·Minds Team

Feature-Katalog

Minds Feature-Kategorien und vertragsnahe Feature-Beschreibungen.

Diese Seite beschreibt die wichtigsten Minds Feature-Kategorien und die kundenbezogenen Feature-Beschreibungen, die für Produkt-, Preis- und Vertragsreferenzen genutzt werden. Kundenspezifische Vereinbarungen können Planlimits, Nutzungskontingente, Leistungsumfang oder Enterprise-Konfigurationen gesondert regeln.

Feature-Kategorien

Zielgruppenmodellierung

Kernobjekte zur Erstellung von Minds und wiederverwendbaren Zielgruppen.

FeatureBeschreibung
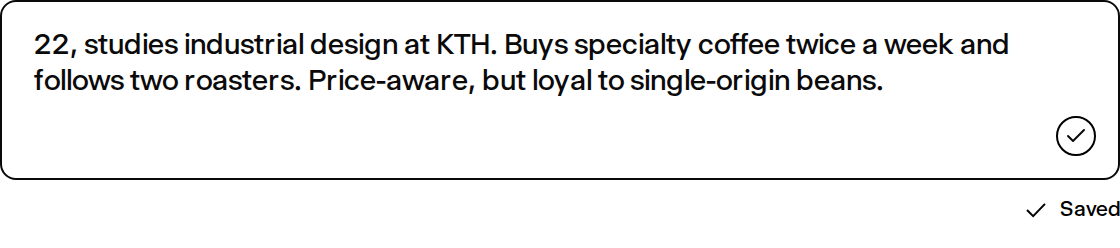
MindsKI-Personas aus Beschreibungen, Profilen, Links, Dateien oder Research-Notizen erstellen. Alles Bereitgestellte bleibt in der Wissensbasis des Minds, und die Web-Anreicherung lässt sich abschalten.
Enthaltene Funktionen
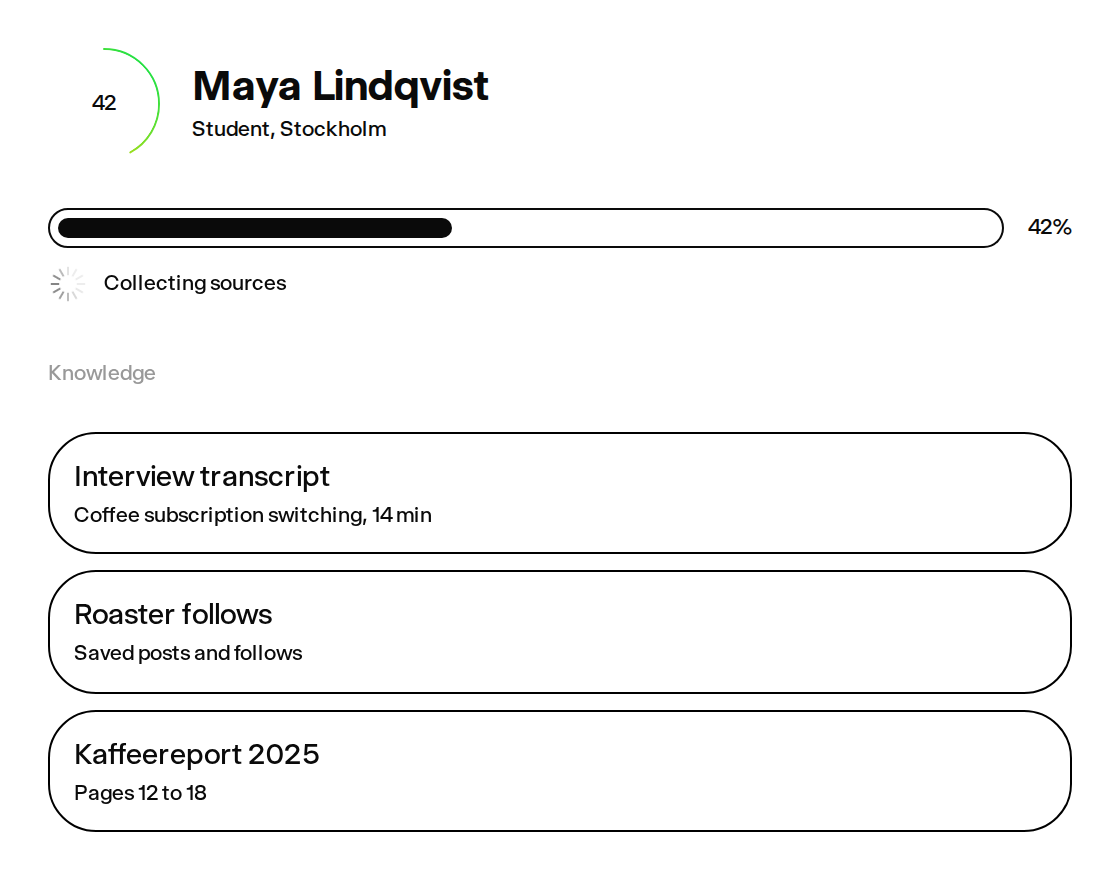
Geführte ErstellungWenn „Neuer Mind“ gewählt ist, klassifiziert ein eigener Profil-Durchlauf, ob die Anfrage eine reale Person bezeichnet, und erzeugt Anfangsbeschreibung und Suchanfragen gemeinsam, ohne die Zielgruppen-Roster-Generierung auszuführen. Ein Mind wird über dasselbe geführte Panel wie eine Zielgruppe erstellt, mit denselben Schritten und demselben Eingabefeld, und nimmt dasselbe Material auf: hochgeladene Dateien, Dateien aus verbundenen Cloud-Speichern, Links und Keyword-Quellen.
Mind creation progress: sources collected, knowledge items read, personality being shaped
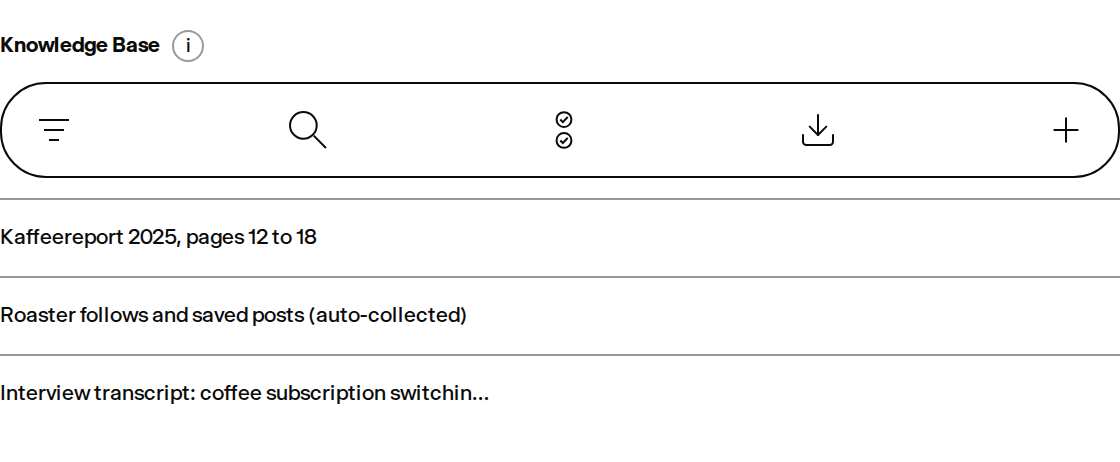
Eigene WissensbasisAlles, was bei der Erstellung übergeben wird, bleibt in der Wissensbasis dieses Minds erhalten und kann daher auch in späteren Antworten herangezogen werden, nicht nur in der Unterhaltung, in der es erstellt wurde. Die Web-Anreicherung lässt sich abschalten; dann entsteht der Mind ausschließlich aus dem von Ihnen bereitgestellten Material.
Knowledge base section of a Mind with its uploaded and auto-collected items
Bearbeitbare BeschreibungenEigentümer und Mitwirkende im Arbeitsbereich können die Beschreibung eines Minds direkt im Profil bearbeiten; dabei wird dasselbe Inline-Autosave-Feedback wie bei Zielgruppenbeschreibungen verwendet. Demo-, Freigabelink- und öffentliche Ansichten bleiben schreibgeschützt.
Inline description editor with auto-save status
Sprache und PRISM-GroundingEin Mind wird in der Oberflächensprache erzeugt, in der er erstellt wurde: Auch das Persona-Profil hinter der Beschreibung entsteht in dieser Sprache, und spätere Anreicherungsläufe behalten sie bei, statt auf Englisch zurückzufallen. Minds PRISM ergänzt quellengestützten öffentlichen Kontext und kann freigegebene Research-Inputs einbeziehen, soweit aktiviert, damit Minds in Research-Workflows wiederverwendet werden können.
PRISM thinking model of a Mind
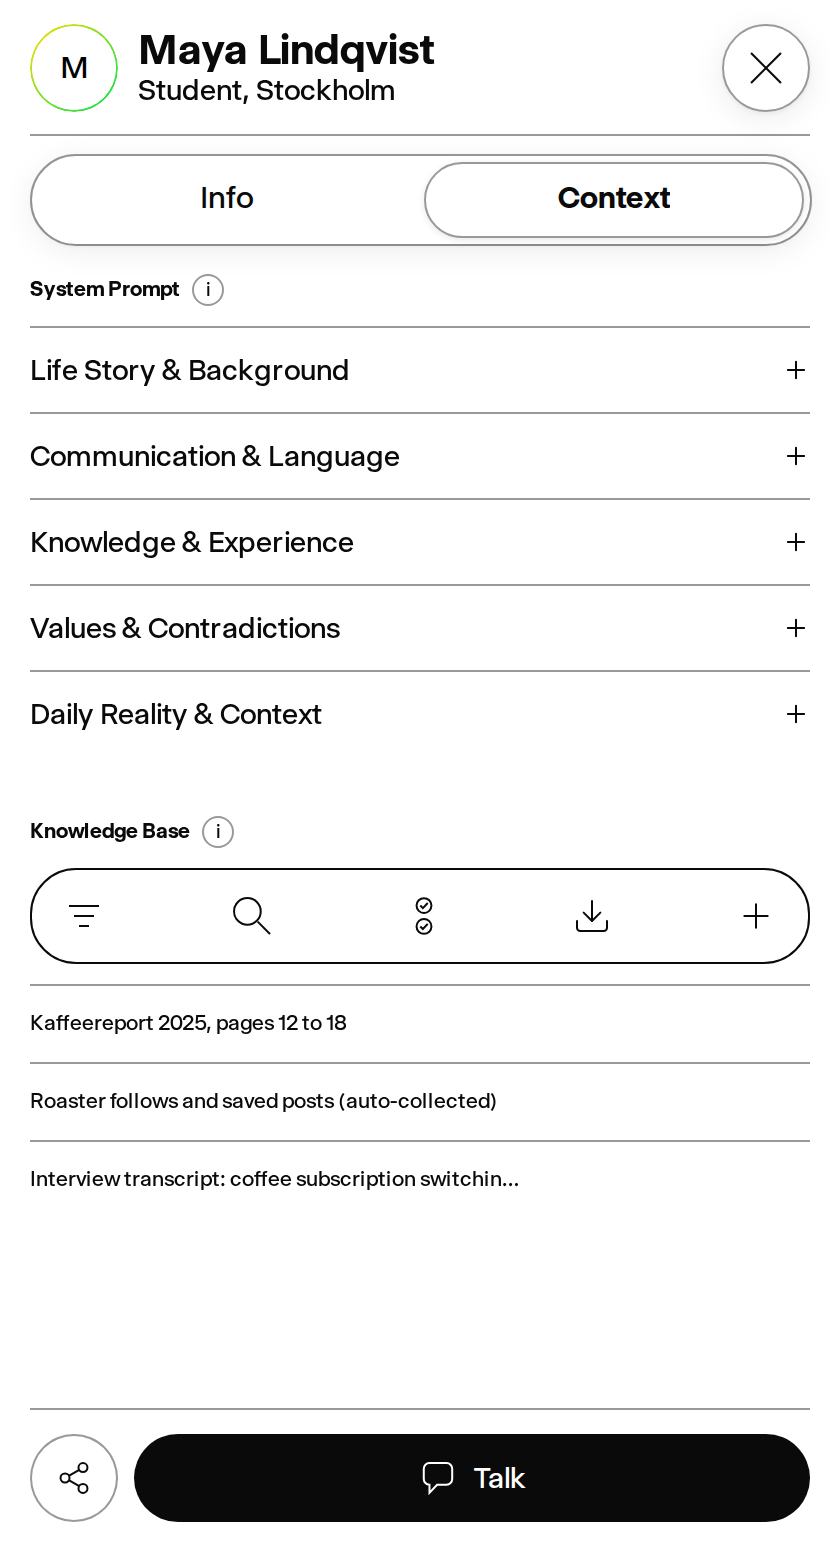
ProfilkontextAngemeldete Mind-Profile können freigegebenen biografischen Kontext neben der Persona-Beschreibung anzeigen, damit Teams relevante Hintergründe prüfen können, ohne interne Kalibrierungsnotizen offenzulegen. Öffentliche Mind-, Landing- und Share-Antworten lassen System-Prompts sowie interne Kalibrierungs- und Quellmetadaten weg.
Context tab of a Mind profile with the personality sections
ZielgruppenerstellungWiederverwendbare Zielgruppen aus bestehenden Minds, einer Beschreibung sowie angehängten Dateien oder Links erstellen. Verteilungen werden aus öffentlichen Quellen und eigenem Research belegt, vor der Erstellung geprüft und in exakte Quoten überführt.
Enthaltene Funktionen
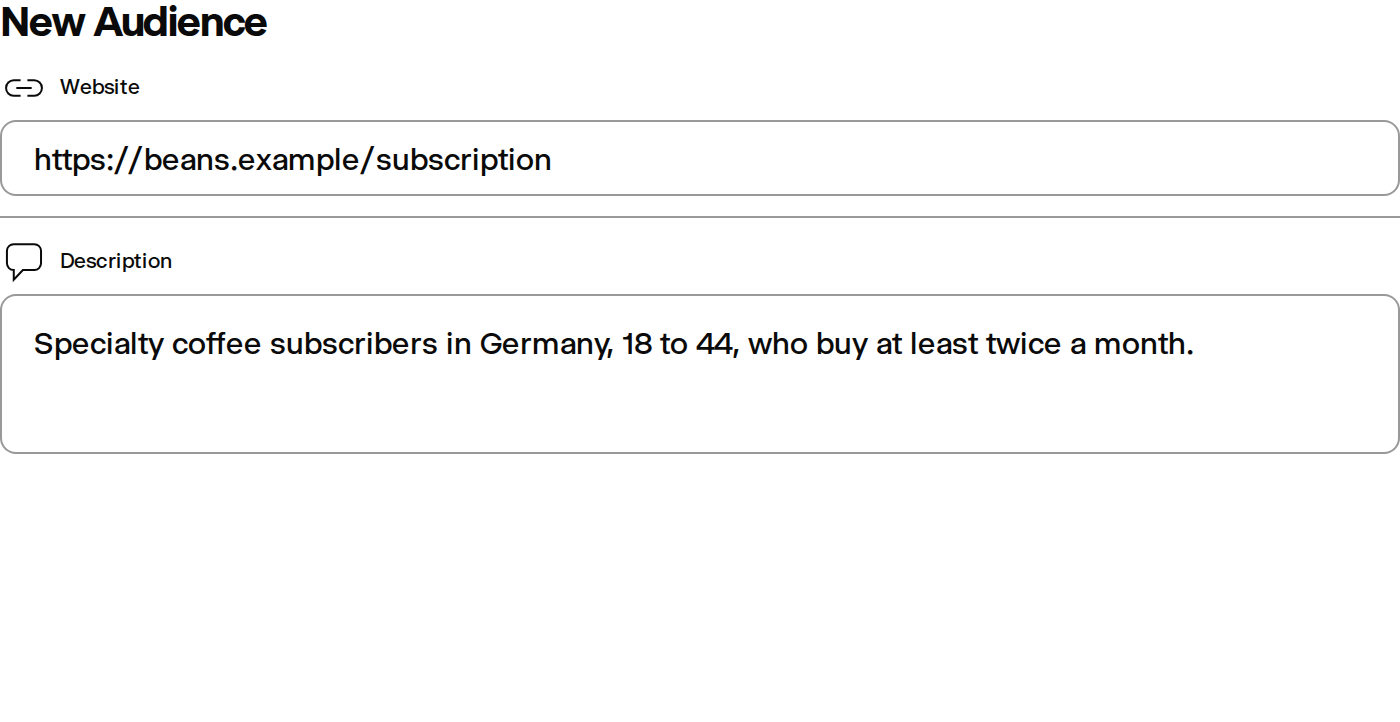
Erstellungspanel, API und MCPÜber API und MCP lassen sich bereitgestellte UTF-8-Forschungsdateien (Text, Markdown, CSV und JSON) importieren und vollständige geprüfte Verteilungen samt Quellen ohne Webrecherche für die Zielgruppe übernehmen. Der erste Erstellungsschritt verankert ein kompaktes Beschreibungsfeld unter optionalem Kontext und wird per Enter ohne separate Footer-Aktion fortgesetzt.
New Audience panel with website and description fields
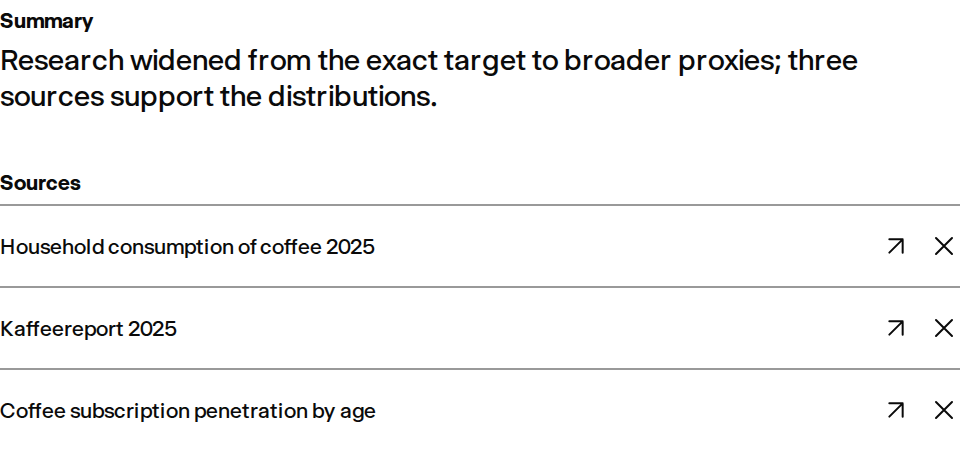
Gestuftes Quellen-ResearchDas gestufte Research erweitert die Suche von der exakten Zielgruppe auf breitere, allgemeine und globale Proxys, um jede belastbare quellengestützte Verteilung zu finden, die die Evidenz trägt – ohne feste Obergrenze an Diagrammen. Vorübergehende Suchfehler werden automatisch wiederholt, und die Suche wird erweitert, wenn ein Durchlauf zu wenige Quellen für eine belastbare Verteilung liefert; eine kurzzeitige Störung des Anbieters wird damit als vorübergehend nicht verfügbares Research ausgewiesen und nicht als fehlende Evidenz der Zielgruppe. Die progressive, quellenübergreifende Extraktion liest jede ausgewählte Quelle und liefert innerhalb des Zeitbudgets die beste validierte Menge.
Source research with the verified sources behind the distributions
Hochgeladene Screener, Berichte und BefragtendatenHochgeladene Research-Dateien werden nach Evidenzstatus klassifiziert: Screener und noch nicht eingesetzte Fragebögen definieren mögliche Optionen, Eignungsausschlüsse und explizite Sollquoten; abgeschlossene Studienberichte und Befragtendatensätze können beobachtete Verteilungen liefern. Von der Quelle ausgeschlossene und noch nicht aufgelöste bedingte Optionen bleiben mit Begründung prüfbar und werden nicht für die Allokation verwendet; passende Befragtenachsen übernehmen die Screener-Regeln. Ein Screener-Merkmal, das die Quelle ohne Soll- oder Ist-Anteil festlegt, wird mit einer vorgeschlagenen Verteilung ergänzt, damit die Zielgruppe darin variieren kann: Diese Werte sind als angenommene Verteilung gekennzeichnet, werden der hochgeladenen Datei nie zugeschrieben und verwässern weder eine angegebene Quote noch reaktivieren sie eine ausgeschlossene Option. Bei Mehrfachauswahl bleiben die Anteile Einzelinzidenzen und dürfen 100% überschreiten, statt die Basis aufzuteilen; das Ergänzen eines Instruments ist zudem unabhängig von seiner Auswertung, sodass eine gestörte Extraktion nicht mehr alle unquotierten Merkmale nur prüfbar zurücklässt.
Drop zone for screeners, reports and respondent data
Ihr Briefing als SpezifikationDer Erstellungs-Prompt selbst gilt als First-Party-Spezifikation: ein eingefügter Screener, genannte Quoten oder die Anweisung, nach einem Merkmal zu segmentieren oder es auszulassen, erzeugt dieselben prüfbaren Verteilungen wie ein Upload — unabhängig davon, ob die Webrecherche dazu Daten gefunden hat. Fließtext-Briefings erzeugen keine Splits mit Fragment-Labels mehr.
Creation composer with a pasted screener brief
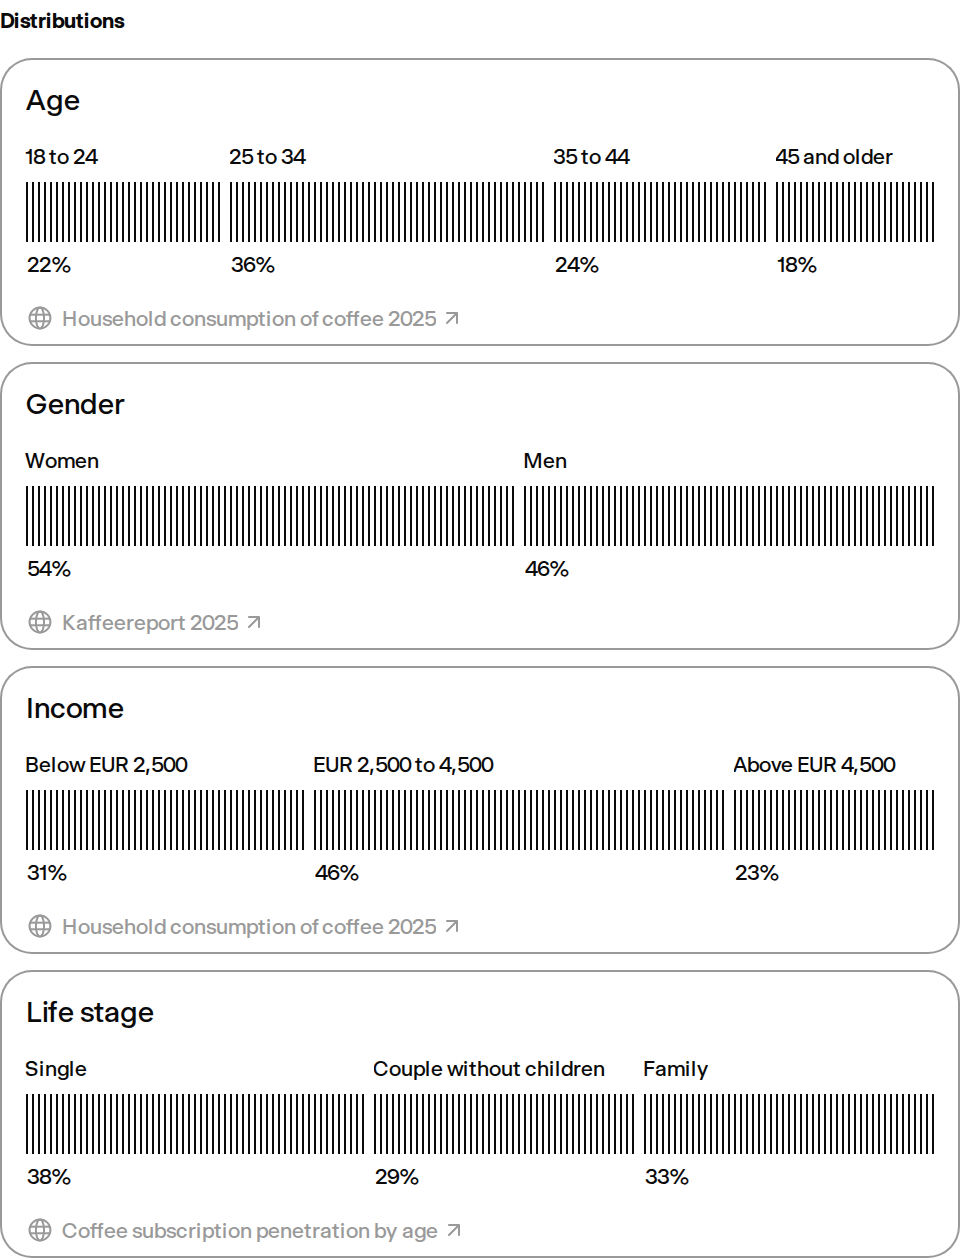
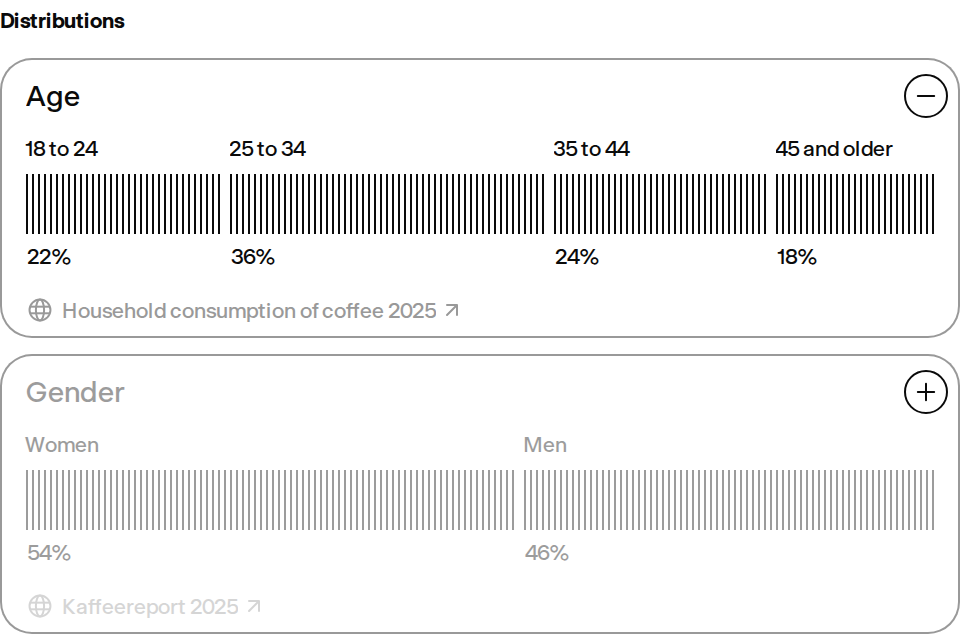
Eingebaute demografische SplitsDie eingebauten Splits Alter, Geschlecht, Einkommen und Lebensphase werden nur angeboten, wenn die Minds der Zielgruppe dafür Belege tragen, statt als fehlgeschlagene Splits zu erscheinen; quellengestützte Splits ordnen jeden Mind über sein gespeichertes Kohortenprofil zu, statt seine Beschreibung erneut auszuwerten. Ein eingebauter Split „Repräsentation“ nutzt dieselbe kanonische Kategorienliste wie das Porträt-Matching, sodass die Achsen, auf denen eine Zielgruppe aufgebaut ist, und die Achsen, nach denen sie gefiltert werden kann, übereinstimmen; quellengestützte Verteilungen zu Ethnie, Race oder Herkunft ersetzen ihn, statt einen zweiten Split für dieselbe Achse anzulegen. Eingebaute Dimensionen werden daran erkannt, wie eine Quelle die Verteilung tatsächlich benennt, nicht nur an einer exakten Übereinstimmung: Auch qualifizierte Namen und Verteilungen in der Sprache der anfragenden Person werden zugeordnet; eine Verteilung, die lediglich eine andere Kennzahl nach einem demografischen Merkmal aufschlüsselt, bleibt ein gruppenspezifischer Split.
Age, Gender, Income and Life stage distribution cards
Belegte Verteilungen als FilterJede quellengestützte Verteilung, auf der die Zielgruppe tatsächlich aufgebaut wurde, wird nach der Erstellung zum Filter – nicht nur die ersten paar: Verteilungen, deren Segmente deterministisch aus den gespeicherten Kohortenprofilen zugeordnet werden, sind vollständig verfügbar; nur modellgenerierte Vorschläge bleiben im Budget des jeweiligen Modus.
Filter list built from the grounded distributions
Deterministische QuotenzuteilungEin deterministischer, Seed-basierter Allocator überführt belegte Prozentwerte in exakte ganzzahlige Quoten; jeder Mind erhält ein zielgruppenspezifisches Kohortenprofil und der Soll-Ist-Audit ist per API verfügbar. Wenn Quellen nur Randverteilungen belegen, wird die gemeinsame Verteilung ausdrücklich unter einer Unabhängigkeitsannahme rekonstruiert, statt unbelegte Korrelationen zu erfinden. Per API lassen sich Seed, einbezogene Dimensionen, Dimensionslimit, Segment-Mindestgröße, Zielwert-Overrides, Joint-Strategie, Antwortdetail und Persona-Kontext steuern; derselbe Vertrag ist für spätere UI-Steuerungen vorbereitet. Eine Verteilung wird gegen die Population zugeteilt, die sie tatsächlich misst: Misst sie eine Teilgruppe (etwa die Herkunft ausländischer Studierender), wird sie nur über die Mitglieder mit diesem Basissegment gezogen und mit Teilgruppe und Anteil ausgewiesen, statt über die gesamte Zielgruppe verteilt zu werden. Trifft dasselbe Attribut aus mehreren Quellen ein, schlägt eine Studienquote eine öffentliche Statistik und diese eine Annahme; verworfene Annahmen bleiben als erkannt gelistet.
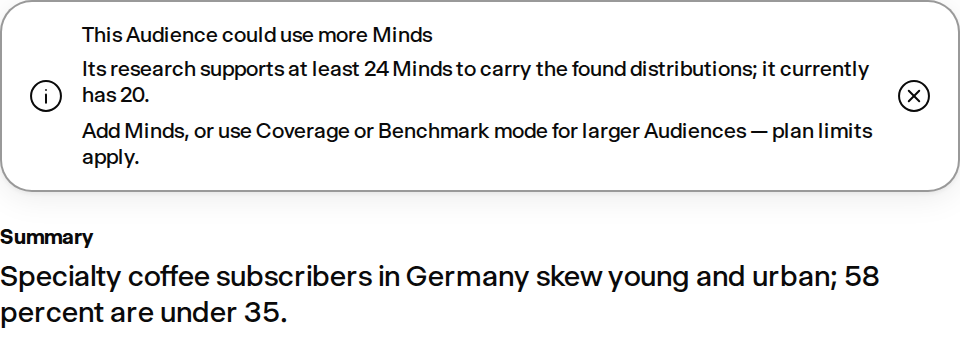
Grounding summary with the research-driven Audience size note
Prüfung vor der ErstellungDie Prüfung zeigt die tatsächlich zugeteilten Profile mit Alter, Geschlecht, Geografie, Beschäftigung, Beruf, Einkommen, Bildung und Lebensphase. Änderungen erfolgen über Rework; Create übernimmt die serverseitig bestätigte Fassung.
Distribution review with one distribution deselected before creation
Befragtendaten als ReferenzstichprobeHochgeladene Studien liefern Referenzstichproben, während Ergebnisantworten als historische Befunde getrennt bleiben. Neue Forschung schließt diese Antworten aus Profilerstellung und Wissensabruf aus; eine ausdrücklich gewünschte Rekonstruktion darf gekennzeichnete historische Aggregate nutzen. Anzahlen, Prozente und Gewichte werden aus Datenzeilen berechnet. Die Zusammensetzung verwendet ungewichtete Stichprobenwerte und beobachtete Beziehungen; gewichtete Befunde bleiben separat prüfbar. Gewünschte Quoten haben Vorrang, ursprüngliche Anteile bleiben erhalten. Nicht erhobene Felder bleiben modelliert oder unbekannt.
Bearbeitbare Beschreibungen und erhaltene ZusammensetzungBestehende gespeicherte Zielgruppen behalten ihre Zusammensetzung. Eigentümer können Zielgruppenbeschreibungen bearbeiten und Marktplatz-Beschreibungen synchron halten.
Audience description editor while saving
Porträt-MatchingSoweit freigeschaltet, erhalten Draft-Minds rechtegeklärte First-Party-Porträts aus öffentlichen Marktplatz-Zielgruppen. Bestehende öffentliche Minds liefern ihre gespeicherte visuelle Präsentation; Alter und deklarierte Repräsentation werden berücksichtigt, sobald diese Merkmale belegt sind. Jede generierte Persona trägt ein explizites visuelles Profil, und der Server ordnet die bestehenden gemeinsamen Kohortenprofile neu zu, damit Identität und Verteilungen ohne Quotenänderung zusammenpassen. Die visuelle Präsentation ist die einzige harte Vorgabe – ein Porträt widerspricht nie dem Geschlecht eines Minds –, während Alter und Repräsentation zu einer bestmöglichen Präferenz herabgestuft werden; Porträts ohne Repräsentationslabel bleiben als neutrale Treffer nutzbar, statt verworfen zu werden. So erhält jeder synthetische Mind ein geschlechtskonformes Porträt, bevorzugt passendes Alter und Repräsentation und verwendet kompatible Porträts erneut, wenn eine enge demografische Gruppe weniger unterschiedliche Assets als die Zielgruppe enthält. Stabile Initialen bleiben nur den bewussten Fällen vorbehalten – einer benannten realen Person, einem Mind ohne deklarierte Präsentation oder einem widersprüchlichen Kohorten-Slot – nie einer demografischen Fehlpaarung. Der Porträt-Pool umfasst alle Minds mit rechtegeklärtem First-Party-Porträt statt nur öffentliche Marktplatz-Zielgruppen; Minds, die benannte reale Personen nachbilden, sind von der anonymen Wiederverwendung ausgeschlossen. Ergänzend sorgen generierte Abdeckungsporträts über die Stil-Archetypen Business, Casual, Creative, Handwerk und Bildung/Pflege für sichtbare Vielfalt statt eines wiederholten Looks.
Live-Fortschritt der ErstellungWährend der Erstellung zeigt eine kompakte Live-Statusansicht den aktuellen Schritt der Zielgruppe sowie den Trainingsstatus jedes einzelnen Minds.
Readiness status: Minds ready and Minds in training
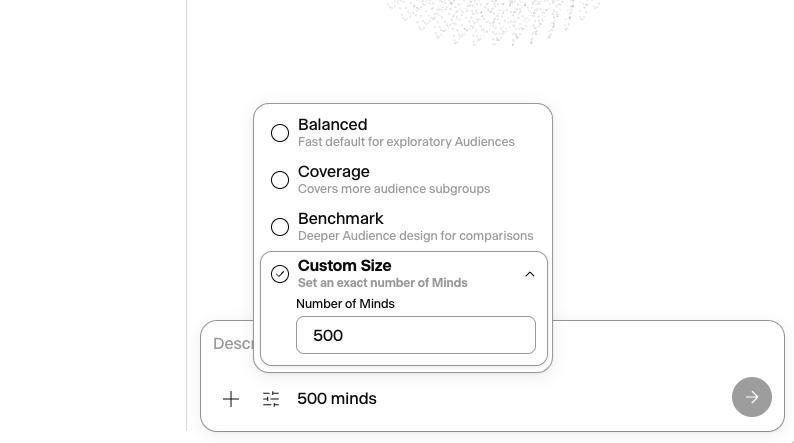
Erstellungsmodi: Balanced, Segment Coverage, Benchmark Depth, Custom SizeDas Erstellungspanel verwendet standardmäßig Balanced und bietet zusätzlich Segment Coverage, Benchmark Depth und Custom Size. Custom Size legt die exakte Anzahl der Minds fest, statt die Größe aus dem Kontingent abzuleiten: Der Design-Modus wird passend zur gewünschten Größe automatisch gewählt, und die Zahl ist durch das Kontingent des Tarifs je Gruppe begrenzt – einschließlich vertraglich vereinbarter Enterprise-Kapazität. Über API und MCP setzt ein explizites memberCount dieselbe Zahl; es überschreibt jede im Briefing genannte Anzahl und wird über das Upgrade-Gate abgelehnt, statt still reduziert zu werden. Balanced bemisst jede Zielgruppe an ihrer eigenen Evidenz — so viele Minds, dass das kleinste belegte Segment eine eigene Vertretung erhält, von 10 bis maximal 20 — sodass eine eng gefasste Zielgruppe klein bleibt, statt einen festen Anteil des Kontingents aufzufüllen; ein größerer Plan vergrößert eine Balanced-Zielgruppe nicht. Ist die Evidenz feiner, als 20 Minds abbilden können, erstellt Balanced seine detaillierteste Zielgruppe, statt seltene Segmente zu verwerfen: Sie bleiben in den Verteilungen sichtbar und behalten ihren Platz in der Allokation. Das Pro-exklusive Segment Coverage gibt jeder begrenzenden, belegten Zielgruppenzelle zwei Minds, von einer evidenzbasierten Mindestgröße von 10 bis zur Modus-Obergrenze von 50 Minds, statt einen festen Anteil des Kontingents aufzufüllen. Das Pro-exklusive Benchmark Depth gibt jeder begrenzenden, belegten Zielgruppenzelle fünf Minds für vergleichbare Tiefe, mit einer evidenzbasierten Mindestgröße von 15, und nutzt das bezahlte Kontingent nur als Obergrenze. Diese liegt bei 200 Minds im Standard-Pro-Plan und bei vertraglich vereinbarter Enterprise-Kapazität höchstens am Systemlimit von 1.000 Minds. Explizite Anzahlen oberhalb des bezahlten Kontingents öffnen das Upgrade-Gate.
Creation panel with the Balanced, Coverage, Benchmark and Custom Size modes, Custom Size set to 500 Minds
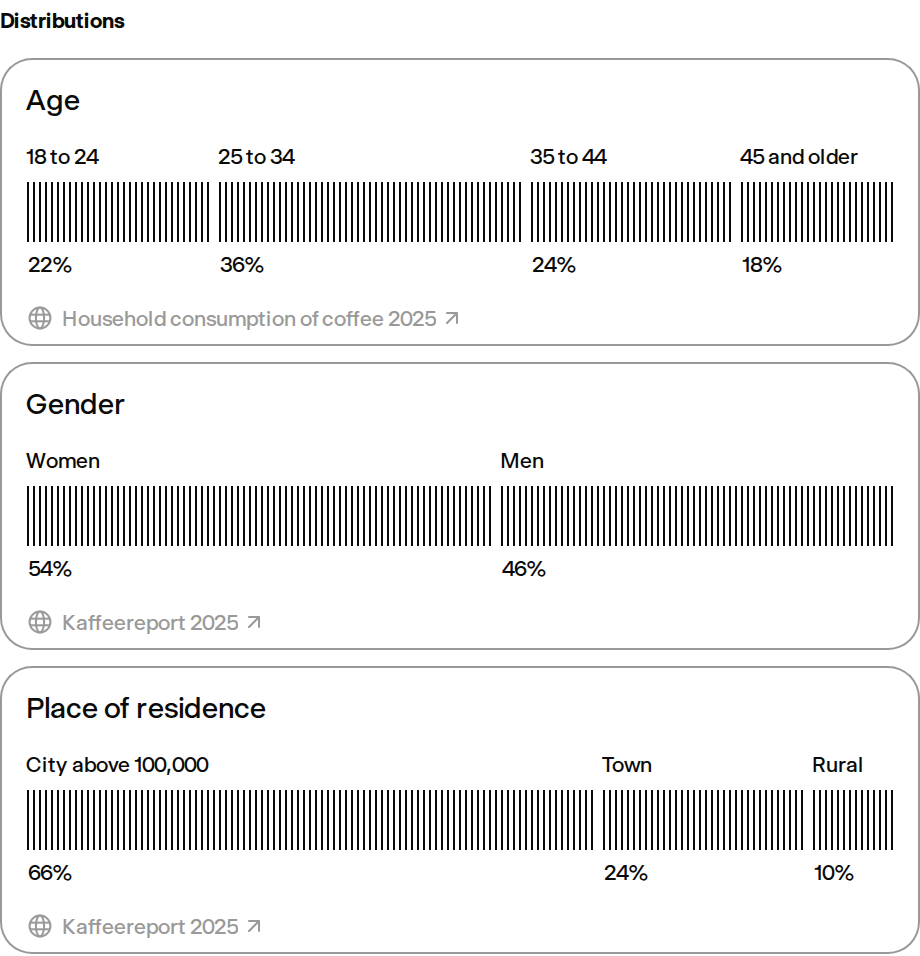
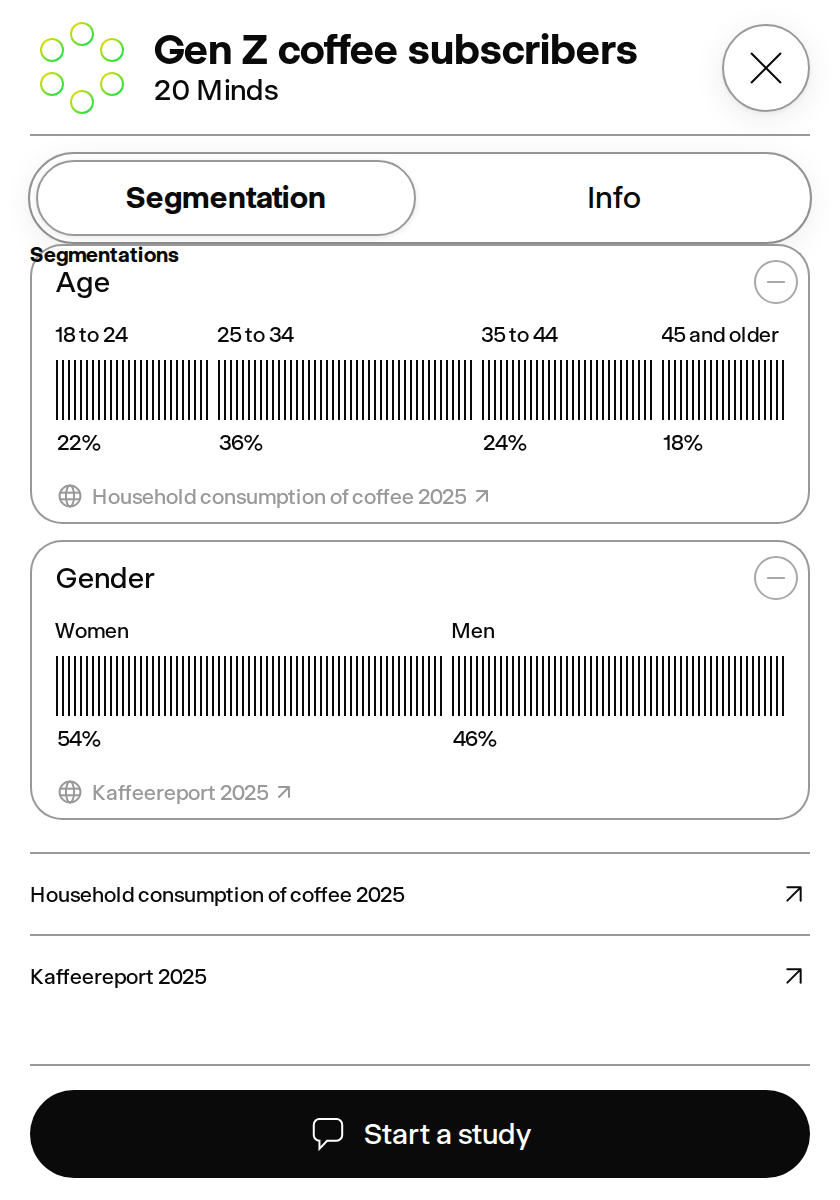
Tabs Segmentierung und InfoNach der Erstellung öffnet die Zielgruppe zuerst den Tab Segmentierung. Er übernimmt den Persona-Orbit aus der Entwurfsprüfung und zeigt jede Verteilung als umrandete Karte mit horizontalen Anteilsbalken, allen Labels und Prozentwerten. Danach folgt der Info-Tab mit aufklappbarer Beschreibung, vollständiger Mind-Liste und einem zentralen Quellenarchiv am Ende; Änderungen an der Zusammensetzung werden über Rework angefordert. Statistiken zu einer breiteren Grundgesamtheit und umgekehrte bedingte Statistiken bleiben mit ihren veröffentlichten Prozentwerten als ergänzender Kontext sichtbar. Werte außerhalb der Zielgruppendefinition sind zunächst abgeblendet und von der Mind-Allokation ausgeschlossen; mit den Plus- und Minus-Steuerelementen können sie ausdrücklich einbezogen oder entfernt werden.
Audience panel on the Segmentation tab
Dauerhafte EntwürfeZielgruppenentwürfe werden vor der Bestätigung gespeichert, laufen im Hintergrund weiter und lassen sich jederzeit aus der Zielgruppenliste fortsetzen.
Audience draft row in the list while drafting
Zielgruppen aus Social-ProfilenErstellen Sie eine Zielgruppe aus einem öffentlichen Instagram-, YouTube- oder LinkedIn-Konto, indem Sie dessen Profil-URL einfügen. Minds liest das Konto und modelliert die Zielgruppe, die ihm folgt — deren Demografie, Interessen und Motivationen —, damit Sie die Menschen recherchieren können, die einem Wettbewerber, Creator oder Unternehmen folgen, ohne das Konto selbst zu klonen.
Prüfung der DatensegmentierungXLS-, XLSX- oder CSV-Befragtendaten Feld für Feld analysieren, Ergebnisse für Tests zurückhalten und eine repräsentative Benchmark-Kohorte mit bis zu 1.000 Minds erzeugen.
Enthaltene Funktionen
FeldklassifikationAlle Zeilen von XLS-, XLSX- und CSV-Befragtendaten strukturell analysieren und jedes Feld als Populationsdefinition, Segmentierungsvariable, Studienergebnis, Entscheidungstreiber, offene Frage, Gewicht/Kennung/Metadaten oder abgeleitete Statistik klassifizieren. Populations- und Segmentierungsvariablen formen standardmäßig die Kohorte; Ergebnisse und Treiber bleiben für Tests zurückgehalten, statt in die Zielgruppe eingebaut zu werden. Die Verteilung jeder Variable erscheint in einem eigenen Prüfschritt.
Datenschutzgerechte ZusammenhängeFür abgeschlossene Befragtendaten werden datenschutzgerechte paarweise Zusammenhänge deterministisch gemessen und in strukturelle Abhängigkeiten sowie Holdout-Evidenz getrennt. Die beobachtete Allokationsstrategie erhält exakte ausgewählte Randverteilungen und bildet die stärksten kompatiblen strukturellen Abhängigkeiten über einen deterministischen Abhängigkeitsbaum nach; kleine Zellen werden unterdrückt und Befragtenzeilen oder eindeutige gemeinsame Profile nie eins zu eins in Minds umgewandelt.
Benchmark-Kohorte erzeugenUnpassende Variablen lassen sich entfernen; anschließend entsteht eine breite repräsentative Benchmark-Kohorte. Soweit freigeschaltet, kann die geprüfte Auswahl bis zu 200 Variablen umfassen und bis zum Systemlimit von 1.000 Minds skalieren. Tabellenbasierte Minds sind anhand ihrer zugewiesenen Profile sofort einsatzbereit, während Porträts im Hintergrund entstehen.
Progress bar of a Benchmark cohort generation
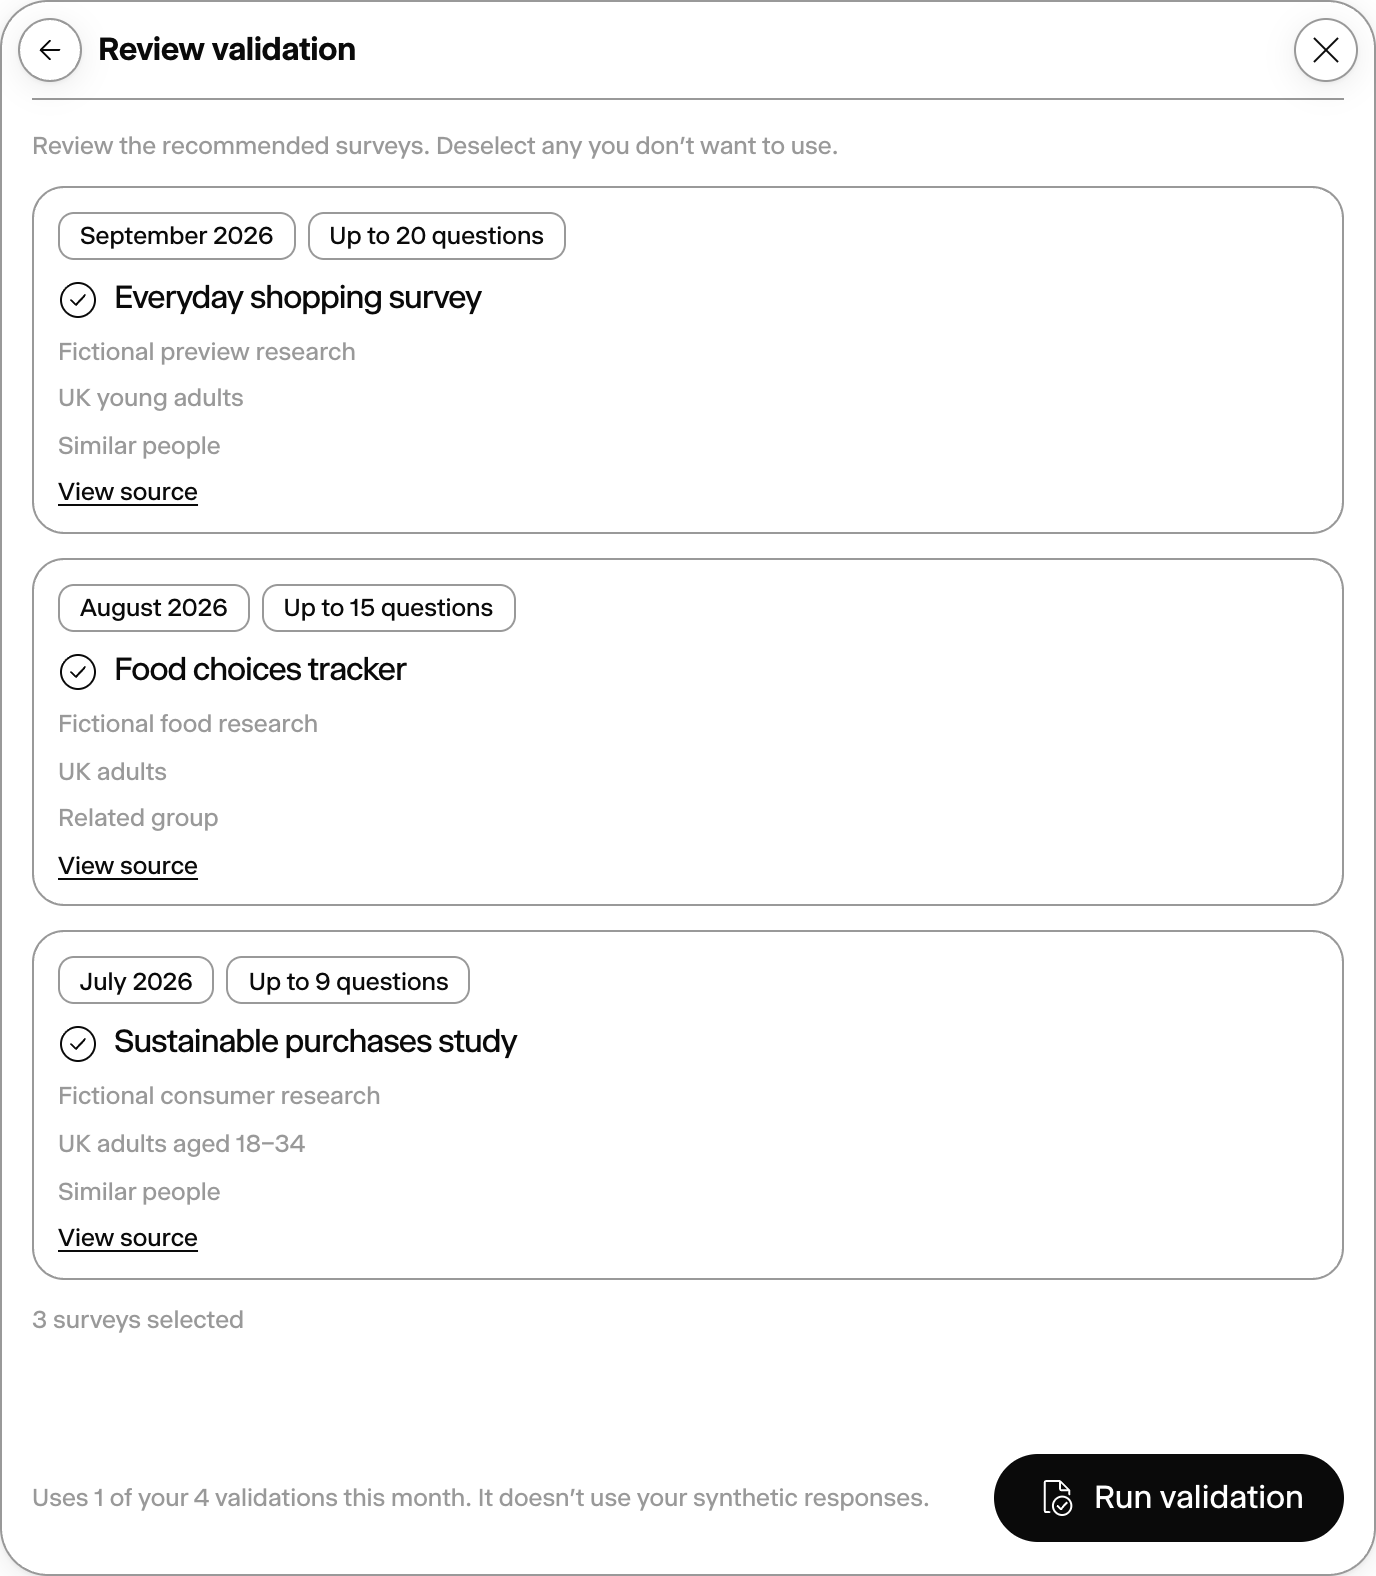
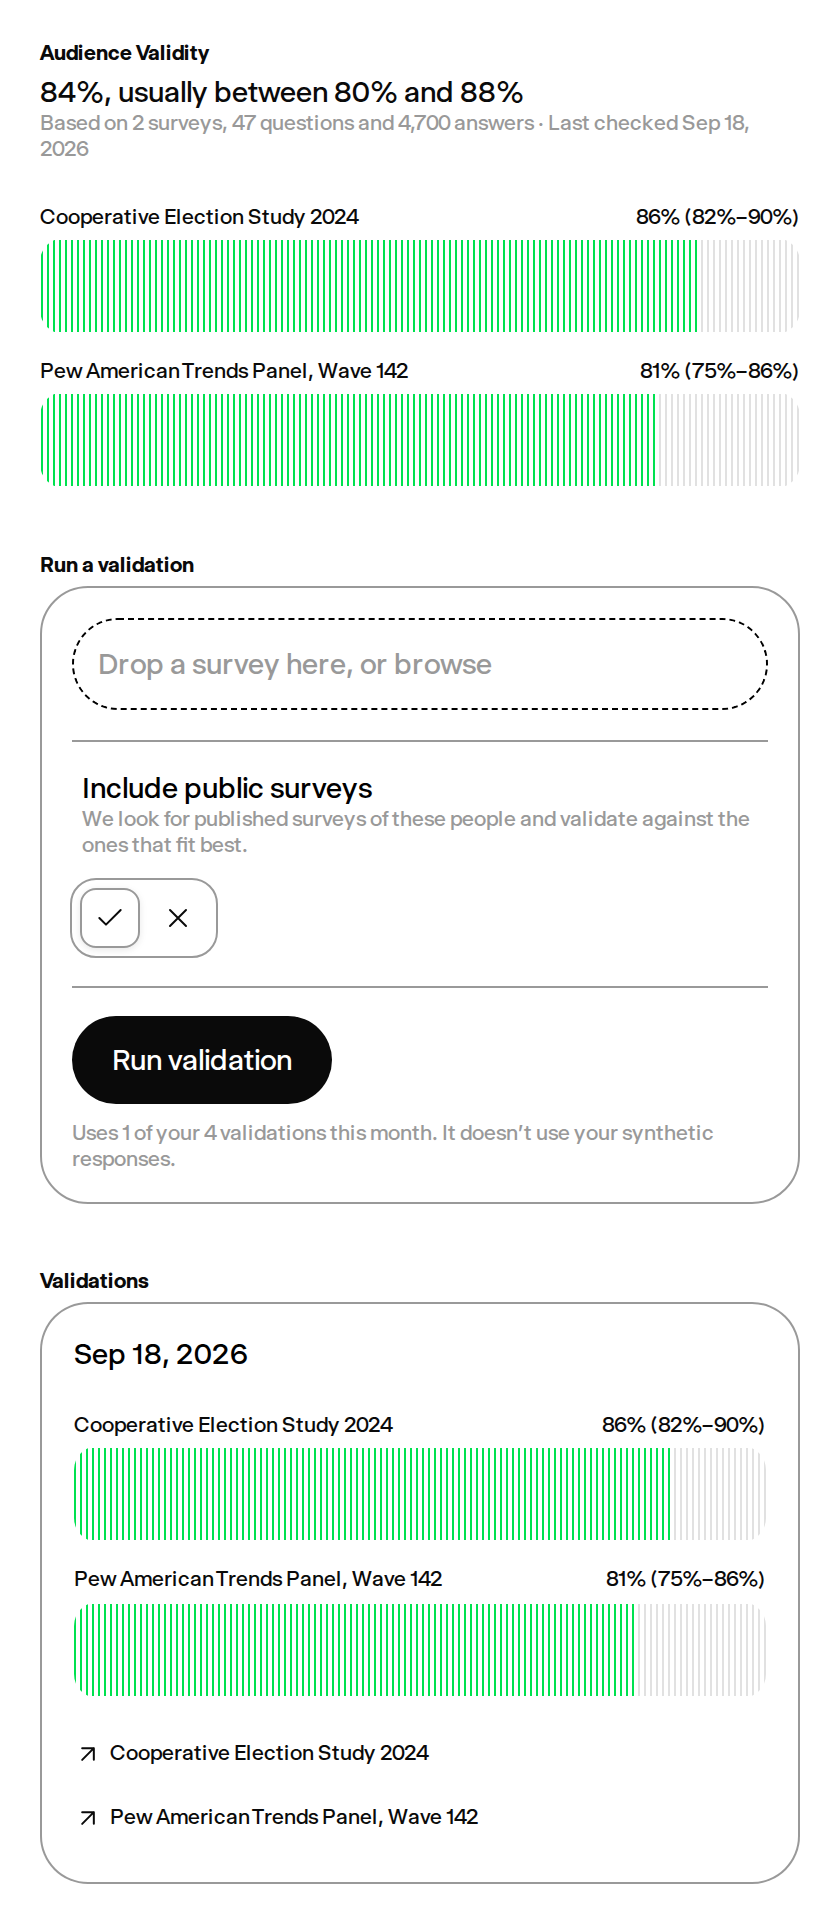
Zielgruppen-ValidierungAntworten einer Zielgruppe mit veröffentlichten oder hochgeladenen Umfrageergebnissen vergleichen. Bei Pay as you go verbraucht die Validierung vorausbezahlte Antworten; ein monatliches Validierungskontingent ist nicht enthalten; kostenpflichtige Abonnements behalten ihre Stripe- oder vertraglichen Kontingente.
Review public survey sources and population fit before validation; deselect surveys to exclude them. Illustrated with fictional preview data.
Validation tab of an Audience: its validity out of 100 with one chart row per survey, the form to run a validation, and previous validations
Marktplatz-ZielgruppenVon Partnern veröffentlichte Zielgruppen abonnieren oder eigene Zielgruppen für andere Teams veröffentlichen; bezahlter Zugriff wird als monatliche Pro-Zusatzleistung abgerechnet.
Enthaltene Funktionen
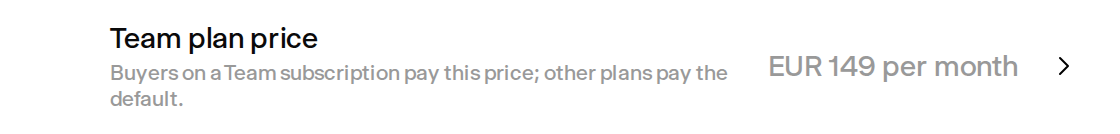
Preise je PlanAnbieter können eine Zielgruppe je Plan bepreisen: Ein optionaler Pro-Preis gilt für Käufer mit Pro-Abonnement, bleibt er leer, zahlen alle Pläne denselben Preis. Der in den Zielgruppendetails, im Abo-Dialog und auf der Rechnung genannte Preis ist immer der, den dieser Plan tatsächlich zahlt.
Pro plan price row of a Marketplace Audience
Cover und BibliotheksleistungGenerierte Zielgruppen-Cover behalten ein einheitliches White-Room-Setting bei und nutzen zielgruppenspezifische Kleidung, Aktivitäten und auf dem Boden platzierte Objekte, damit jede Zielgruppe visuell unterscheidbar ist. Die Zielgruppen-Bibliothek nutzt darstellungsoptimierte Cover-Thumbnails und priorisiert sichtbare Karten, damit große gespeicherte und Marktplatz-Sammlungen beim Durchsuchen reaktionsschnell bleiben.
Marktplatz-KartenMarktplatz-Karten nutzen drei visuelle Gewichtungsstufen: Hohe und normale Gewichtung skalieren das coverbasierte Layout, während Zeilen mit niedriger Gewichtung links einen Zielgruppen-Avatar und unter dem Namen die Anzahl der Minds zeigen. Jede Katalogkarte zeigt neben dem Titel nur eine kontextbezogene Aktion: Speichern für kostenlose Zielgruppen oder Abonnieren für kostenpflichtige Add-ons; Studien- und Verwaltungsaktionen bleiben im Detaildialog.
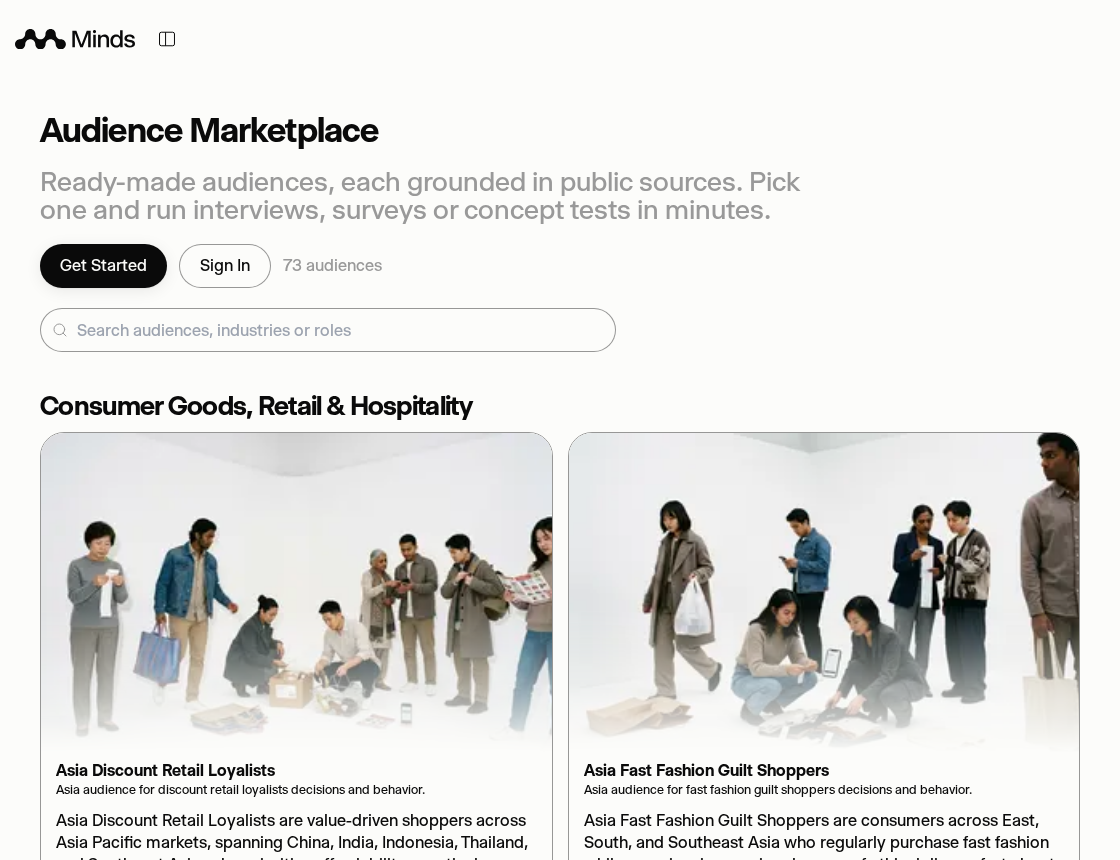
Öffentliche Marktplatz-SeiteDer Katalog ist unter getminds.ai/marketplace in allen neun Sprachen öffentlich: Wer nicht angemeldet ist — Besucher, Suchmaschine oder KI-Assistent — sieht jede veröffentlichte Zielgruppe mit Beschreibung, Quellen und Anzahl der Minds und kann den gesamten Katalog ohne Konto durchsuchen. Eine Aktion auf einer Zielgruppe öffnet die Registrierung, benannt nach der gewählten Zielgruppe.
The signed-out Marketplace page at getminds.ai/marketplace
Eigene Seite je öffentlicher ZielgruppeJede öffentliche Zielgruppe hat unter getminds.ai/marketplace/<name> eine eigene Seite, in allen neun Sprachen, mit derselben Ansicht wie ein geteilter Link: Cover, belegte Beschreibung, die enthaltenen Minds und ein Gespräch mit ihnen. Geteilte Links zu öffentlichen Zielgruppen verweisen Suchmaschinen auf diese Seite, statt mit ihr zu konkurrieren; Links zu privaten Zielgruppen bleiben nicht indexiert.
Individuelles OnboardingErste Zielgruppen in Minuten einrichten: Marke beschreiben, Website einfügen, Kontextdateien anhängen; Minds entwirft Kern-Zielgruppen zur Prüfung, bevor sie erstellt werden.
Enthaltene Funktionen
Drei belegte Kern-ZielgruppenErste Zielgruppen in Minuten einrichten: Marke beschreiben, Website einfügen und mehrere Kontextdateien anhängen; Minds erkennt zuerst den Geschäftskontext. Anschließend entwirft Minds drei Kern-Zielgruppen — Endkund:innen, professionelle Nutzer:innen sowie Handels- oder Vertriebspartner, wenn relevant — und zusätzliche optionale Stakeholder-Zielgruppen nur bei klarer inhaltlicher Abgrenzung. Jede Zielgruppe wird unabhängig anhand eigener Quellen und Verteilungen fundiert und erhält eine quellengestützte Beschreibung, eine ausgewogene Anzahl an Minds sowie ein progressiv generiertes Coverbild.
Selected core Audience card
Prüfen und bearbeiten vor der ErstellungVor der Erstellung können alle vorgeschlagenen Zielgruppen in einem eigenen Prüfschritt kontrolliert und ihre fundierten prozentualen Verteilungen bearbeitet werden. Bestätigte Grounding-Daten und Segmentierungs-Formations werden vor dem Öffnen mit jeder Zielgruppe gespeichert.
Cover, Quellen und Live-ResearchCover starten parallel, sobald Zielgruppen-Kandidaten feststehen, während Research und die nicht sichtbare Mind-Ausbalancierung weiterlaufen. Die Entwurfskarten zeigen die tatsächlich verwendeten verifizierten Quellen. Der Ladeablauf bleibt in der Analyse, bis erste Recherche-Keywords eintreffen, und zeigt dann die verifizierte Recherche in lesbarem Tempo; fertige Entwürfe warten nicht auf optionale Cover oder Marktplatz-Matches. Bei Überarbeitungen werden dieselben Recherche-Schritte sichtbar wiederholt und unveränderte Karten beibehalten.
Live research status line
Rückfragen und Marktplatz-VorschlägeWenn eine bereitgestellte Unternehmensquelle nicht genug Kontext liefert, fragt Minds vor dem Entwurf nach einer kurzen Beschreibung von Angebot und Markt. Passende Marktplatz-Zielgruppen werden vorgeschlagen und Custom Plan öffnet mit den beibehaltenen Zielgruppen eine temporäre Fragebogen-Studie.
Fallback question for the offering and market
Übergabe an die erste StudieCustom Plan übernimmt das gewählte Research-Ziel, die Unternehmensbeschreibung, Website und hochgeladenen Kontext, überspringt eine erneute Zielgruppenauswahl und führt direkt über die Research-Methodenauswahl zur bearbeitbaren Fragenprüfung; erst die erste gesendete Frage erstellt die Studie, sodass das Speichern von Zielgruppen nicht auf das Studienkontingent angerechnet wird.
Start your first Study button
Kontingent, Überspringen und NeustartWorkspace-Limits werden vor der Erstellung von Zielgruppen geprüft. Fertige Zielgruppen bleiben erhalten, wenn eine andere fehlschlägt; diese lässt sich erneut erstellen. Das Onboarding kann übersprungen oder nach der Anmeldung bei Google Drive oder OneDrive oder dem Neuladen desselben Tabs fortgesetzt werden.
Allowance notice with the plans action

Research-Workflows

Abläufe zur Befragung von Minds, zum Segmentvergleich und zum Testen von Stimuli.

FeatureBeschreibung
StudienEine Studienoberfläche für Einzelinterviews mit Minds, qualitative Exploration im großen Maßstab, Fragebögen mit richtungsweisenden quantitativen Auswertungen, Konzept- und Botschaftstests sowie Segmentvergleiche.
Enthaltene Funktionen
StudienformateEin Einzelinterview mit einem Mind, eine moderierte Diskussion mehrerer Minds, eine Frage an eine ganze Zielgruppe, bei der alle Minds parallel antworten, oder ein Fragebogen mit Research-Methode. Formate lassen sich in einer Studie kombinieren.
Format toggle: Interview, Discussion, Audience, Questionnaire
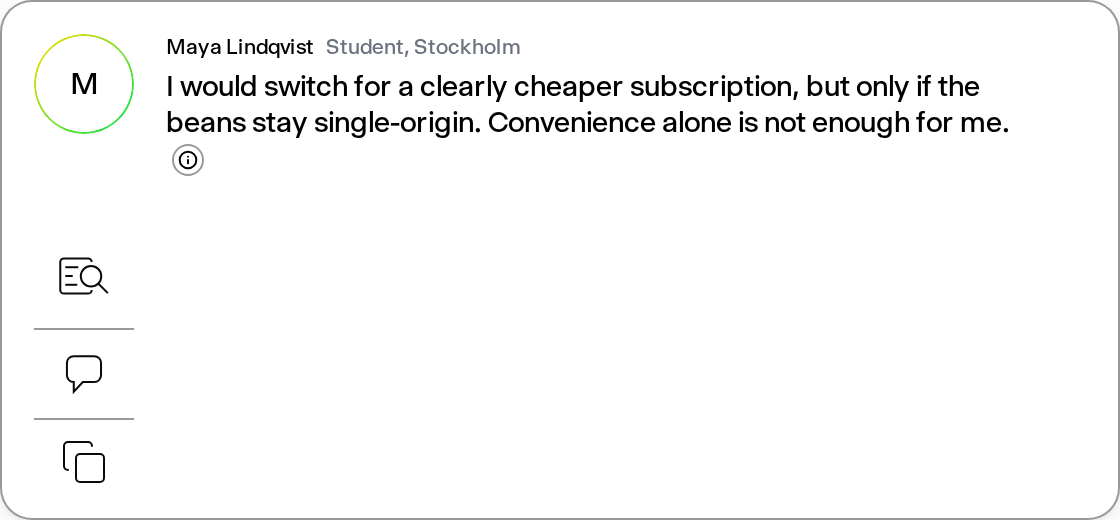
Kontextbezogene Mind-ChatsÜber Chat an einer Mind-Antwort lässt sich die konkrete Frage mit früheren Antworten und den zugehörigen Studiendateien und Bildern vertiefen, ohne sie erneut hochzuladen. Der gespeicherte Chat behält diesen Kontext und verlinkt auf die ursprüngliche Studie; Antworten anderer Minds und spätere Fragen werden nicht übernommen. Eine Oberfläche für Einzelinterviews mit Minds, Zielgruppenfragen und Segmentvergleiche nutzen, inklusive kontextbewusster Folgefragen in der Sprache des aktuellen Gesprächs.
Mind answer card with the Closer Look, Chat and Copy actions
Belegstellen im InterviewIn einem ausführlichen Einzelinterview mit einem Mind zeigen Aussagen aus Wissensbasis, Websuche, analysierten Links und hochgeladenen Dokumenten dieselben Inline-Quellenlogos mit Hover-Hinweisen wie Antwortkarten in Studien: Öffentliche Quellen öffnen ihre exakte URL, private Dateien bleiben unverlinkt und legen niemals Speicherpfade offen.
Minds und Zielgruppen auswählenÜber „Minds auswählen“ im Haupteingabefeld öffnet sich der Picker sofort; ein geöffnetes Minds-Panel wird bei der Übergabe eingeklappt. Zuletzt verwendete Minds und Zielgruppen erscheinen jeweils nur einmal, statt leere Plätze mit Wiederholungen zu füllen.
Recent Minds picker
Quick-Start mit ZielgruppenermittlungBei einem anfragegesteuerten Quick-Start bleibt der stabile Ladezustand (Twinkle) im tastaturbedienbaren Picker sichtbar, während Anfrage, angehängte Websites, Uploads und unterstützte Integrations-Assets zuerst aufgelöst und analysiert werden, um die beabsichtigte Zielgruppe zu verstehen. Anschließend werden passende private Bibliotheks- und Marktplatz-Zielgruppen gemeinsam mit sinnvollen neuen Zielgruppenentwürfen gerankt. Eindeutige Workspace-Aktionen wie Exportieren, Herunterladen oder Neuformatieren eines bestehenden Ergebnisses werden als Aktion erklärt, statt erfundene Analysten-Zielgruppen vorzuschlagen. Die Wartezeit ist begrenzt: Bereits gefundene passende Zielgruppen bleiben erhalten, andernfalls wird statt endlosem Laden ein erneuter Versuch angeboten. Mehrere wiederverwendbare sowie als „NEU“ gekennzeichnete exakte oder angrenzende Alternativen können nebeneinander erscheinen, einschließlich einer gleichnamigen neuen Option bei einem Treffer auf eine bestehende Zielgruppe; alle Ergebnisse bleiben dabei unselektiert, bis der Nutzer eine Auswahl trifft. Bestehende Zielgruppen behalten ihre tatsächlich gespeicherte Anzahl an Minds, auch bei größeren manuell kuratierten Zielgruppen; nur NEUE Quick-Entwürfe verwenden den planverträglichen Bereich von 5–20 Minds. Jede Quick-Anfrage erfordert eine ausdrückliche Zielgruppenbestätigung, bevor eine Studie startet, auch bei einem exakten Treffer auf eine bestehende Zielgruppe. Bestätigte NEUE Entwürfe werden mit den analysierten Quellen in den gemeinsamen Zielgruppenerstellungsablauf übergeben.
Audience selector with existing and new Audience suggestions
Projekt-StudienProjekte können aus den einzelnen Minds des Projekts eine neue Studie starten und sie im Projekt behalten. Studienmeldungen bleiben eindeutig, wenn eine Zielgruppe keine verfügbaren Minds hat oder diese noch vorbereitet werden.
Fortschritts- und StatuskarteEine Statuskarte oben rechts bündelt die Zielgruppen der aktuellen Studie mit laufenden Hintergrundstudien und führt zurück zu einer abgeschlossenen Studie, sobald ihr Ergebnis bereitsteht. Innerhalb einer Studie ist die Karte jederzeit erreichbar und auf diese Studie begrenzt: Sie verbindet den laufenden Fortschritt mit den Zielgruppen der Studie zu einer Verwaltungsfläche. Einsatzbereite Zielgruppen zeigen ihre tatsächlich gespeicherte Anzahl an Minds, ein Kreis-Minus-Symbol entfernt eine Zielgruppe aus der Studie, und eine Zeile „Zielgruppe hinzufügen“ öffnet dieselbe schrittweise Zielgruppenauswahl mit Bestätigungsschritt wie an anderen Stellen im Workspace. In der Übersicht bündelt die Karte weiterhin alle gespeicherten Entwürfe, laufenden Studien und noch in Vorbereitung befindlichen Zielgruppen. Auch andere länger laufende Funktionen können eigene Fortschrittszeilen in derselben Karte veröffentlichen; ein Klick auf eine Zeile führt zurück zur veröffentlichenden Funktion.
Schnelle ErgebnishistorieLang laufende Studien rendern zunächst die neuesten abgeschlossenen Ergebnisse, damit sich das Transkript schnell öffnet. Frühere Ergebnisse bleiben in vorhersehbaren Schritten verfügbar; wird ein zurückgestelltes Ergebnis in der Research-Navigation ausgewählt, wird es vor dem Scrollen zur gewünschten Evidenz eingeblendet.
Studieneinrichtung und StudienpläneEine Studie im Quick-Modus oder über die sechsstufige individuelle Einrichtung starten. Jede Anfrage wird zu einem versionierten Studienplan mit geprüften Fragen, Antwortformaten und Methode, der vor jeder Ausführung bestätigt wird.
Enthaltene Funktionen
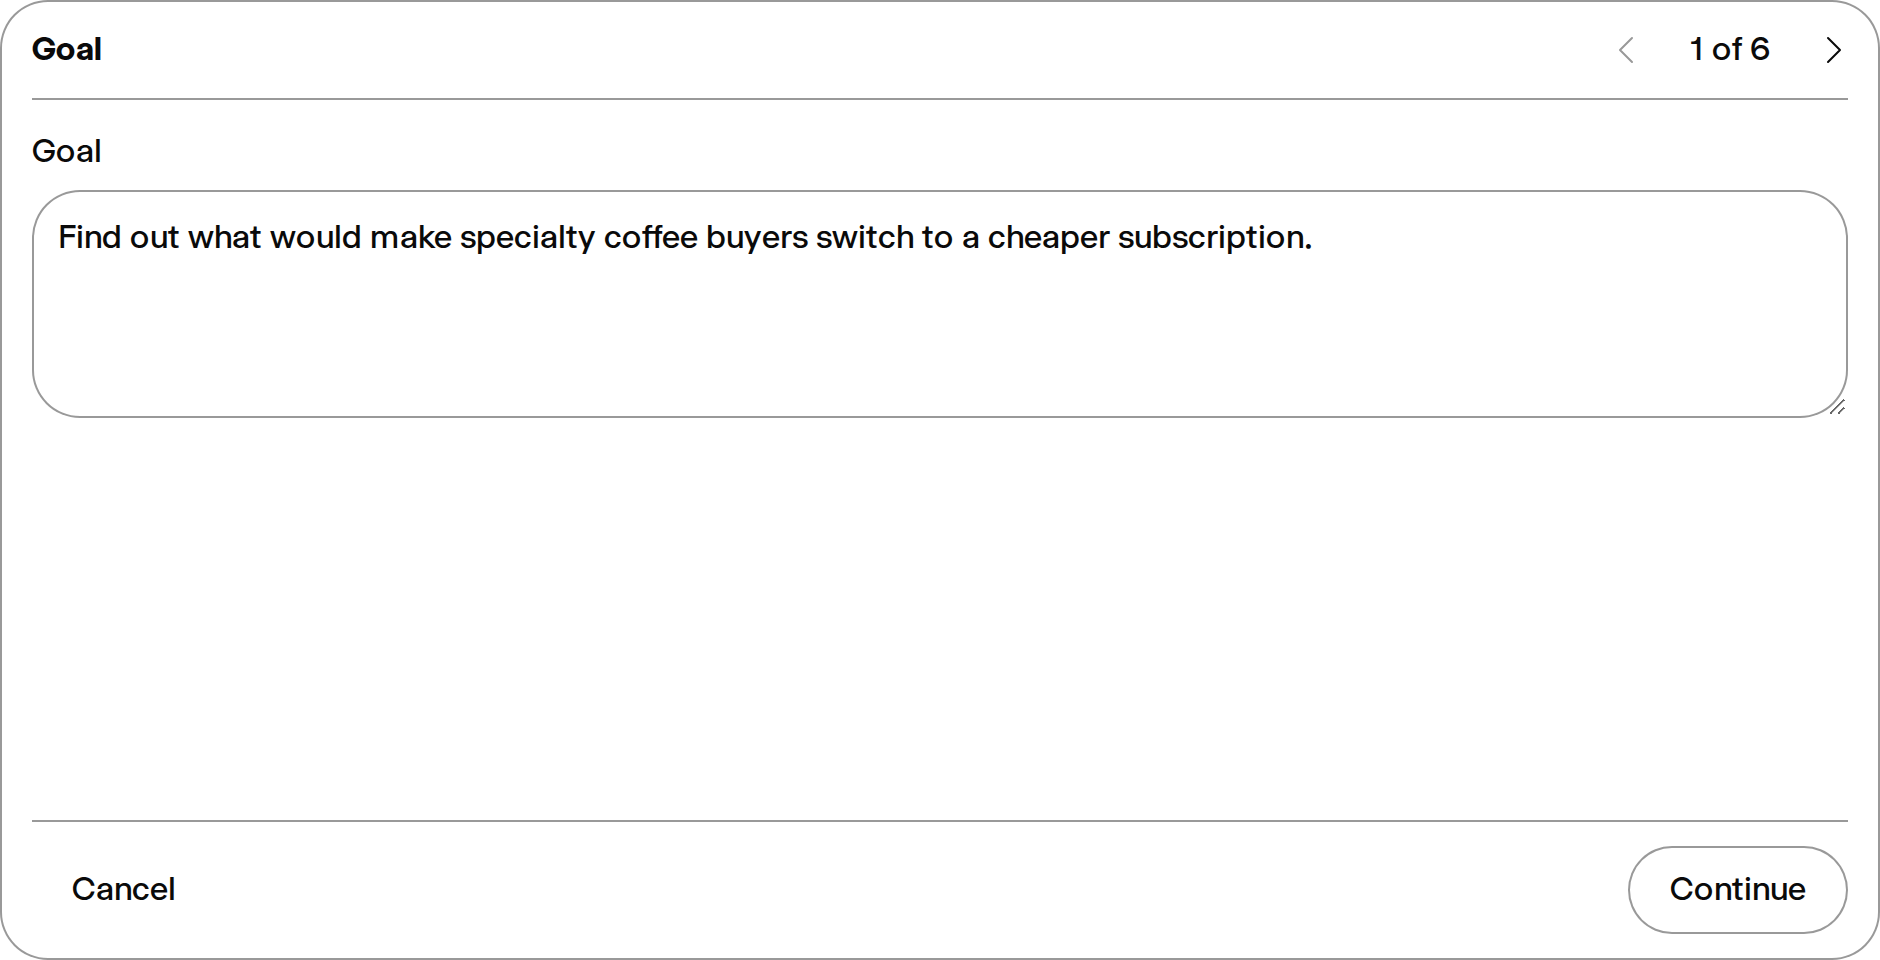
Quick-Modus und individuelle EinrichtungEine Studie im Quick-Modus starten oder in der sechsstufigen individuellen Einrichtung das Research-Ziel festlegen, Website, Dateien oder Notizen hinzufügen, Zielgruppen auswählen, zielbezogene Fragen prüfen und die vollständige Einrichtung vor dem Start bestätigen.
Custom setup step 1 of 6: the research goal
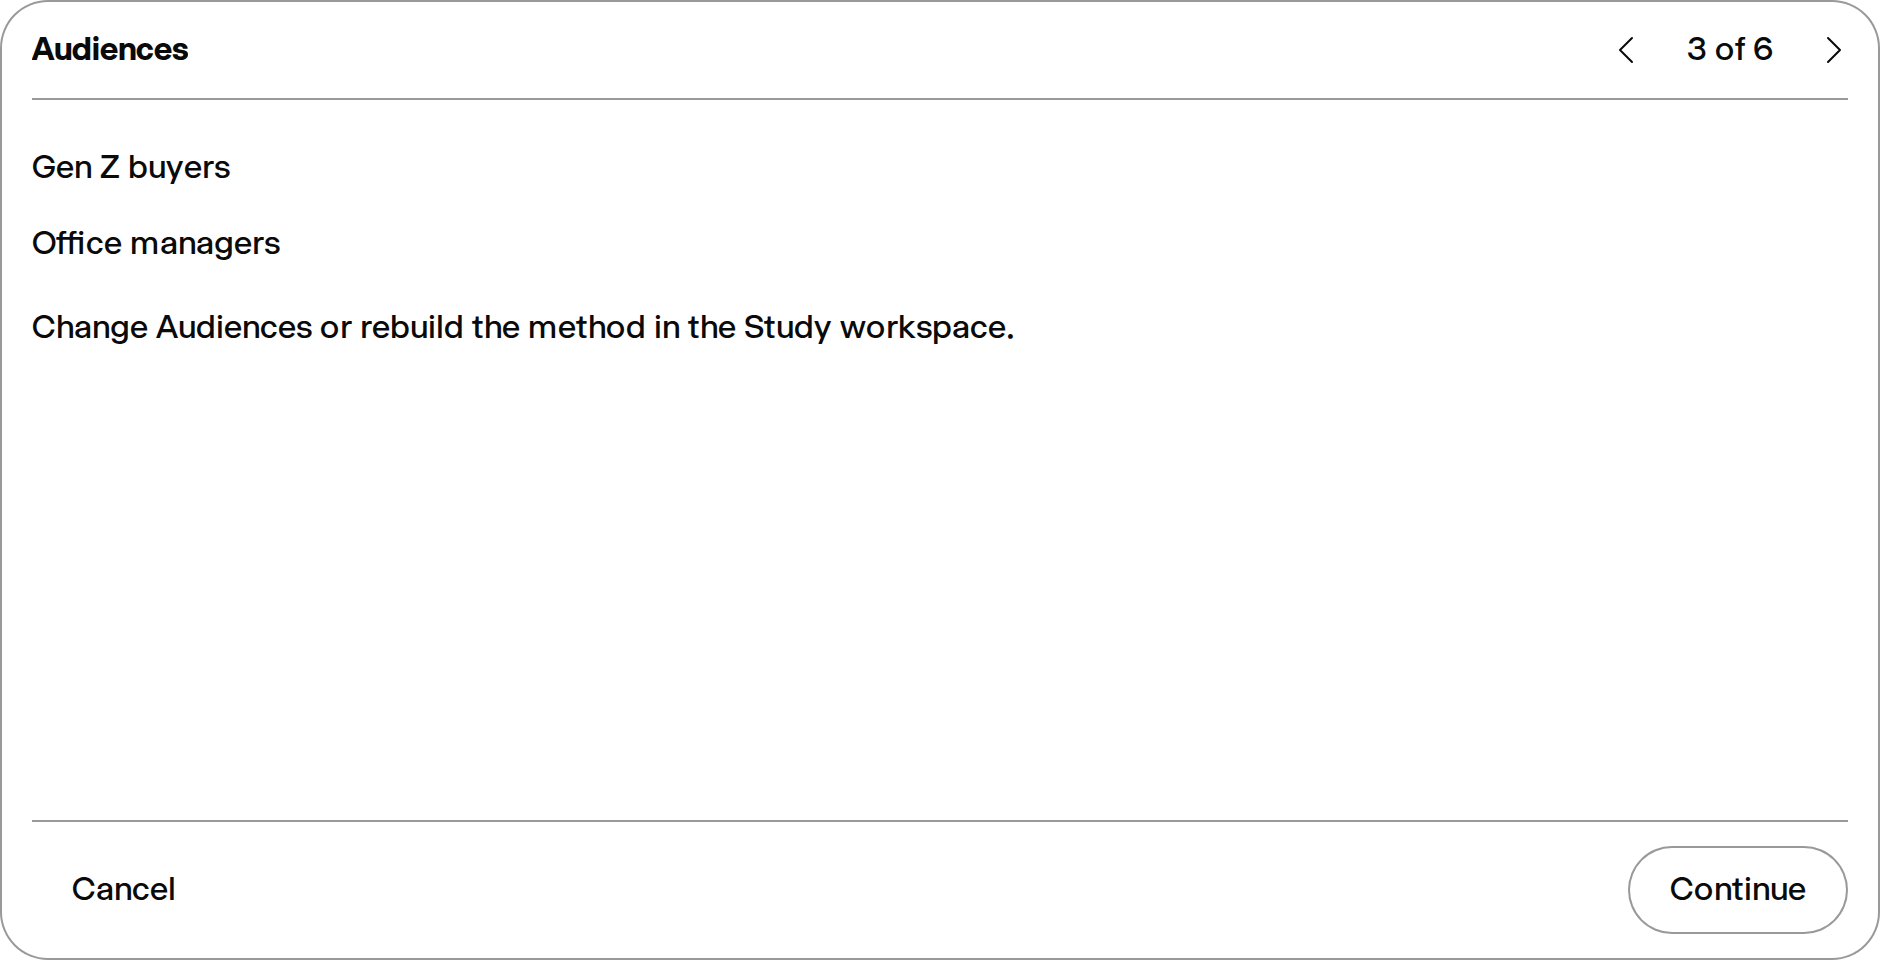
Zielgruppenschritt mit Marktplatz-AuswahlIm Zielgruppenschritt von Quick und Custom lässt sich der vollständige Marktplatz als externe Auswahl öffnen: Bestätigte Marktplatz-Zielgruppen kehren in den Plan zurück, beim Abbrechen wird die vorherige Planauswahl wiederhergestellt. Beim Wechsel vom Eingabefeld in die individuelle Einrichtung werden die aktuelle Anfrage sowie angehängte Websites, Uploads und unterstützte Integrationskontexte übernommen. Kontextuelle Zielgruppenempfehlungen nutzen dieselbe Rangfolge aus gespeicherten Zielgruppen und Zielgruppenentwürfen wie der Schnellmodus, mit den ermittelten Entwürfen als Relevanzanker, damit unpassende schwache Bibliothekstreffer nicht als Empfehlungen erscheinen. NEUE Entwürfe werden in Schritt 3 ausgewählt, bleiben in Schritt 6 sichtbar zur Erstellung markiert und gehen erst nach Bestätigung der vollständigen Einrichtung in dieselbe fundierte Zielgruppenerstellung wie im Schnellmodus.
Custom setup step 3 of 6: Audiences
Fortsetzbare StudienentwürfeNach der ersten Planungsentscheidung wird jedes neue Quick- oder Custom-Setup als isolierter Studienentwurf gespeichert. Checkpoints bleiben beim Wechsel zwischen Chats je Entwurf getrennt; Navigation, Neuladen oder ein fehlgeschlagener Start erhalten den exakten Planungsschritt.
Study draft row in the sidebar
Bestätigung und StartDie Bestätigung erstellt und öffnet sofort die dauerhafte Studie; Uploads und die Vorbereitung NEUER Zielgruppen laufen hinter den bestehenden Ladeanzeigen innerhalb dieser Studie weiter, und die fertigen Zielgruppen werden vor dem Start der bestätigten Fragen derselben Studie hinzugefügt. Bei Annahme durch die Warteschlange wird der zugehörige Entwurf atomar verbraucht, damit ein Start nicht zugleich als Studie und doppelter Entwurf erscheint; ein abgelehnter Start lässt den Entwurf fortsetzbar. Nach der Bestätigung übernimmt die laufende Studie den Study-Zustand, statt das Setup beim Neuladen erneut zu öffnen; als Ergebnisüberschrift wird der kurze bestätigte Research-Gegenstand und nicht das vollständige interne Briefing verwendet.
Confirm and run button
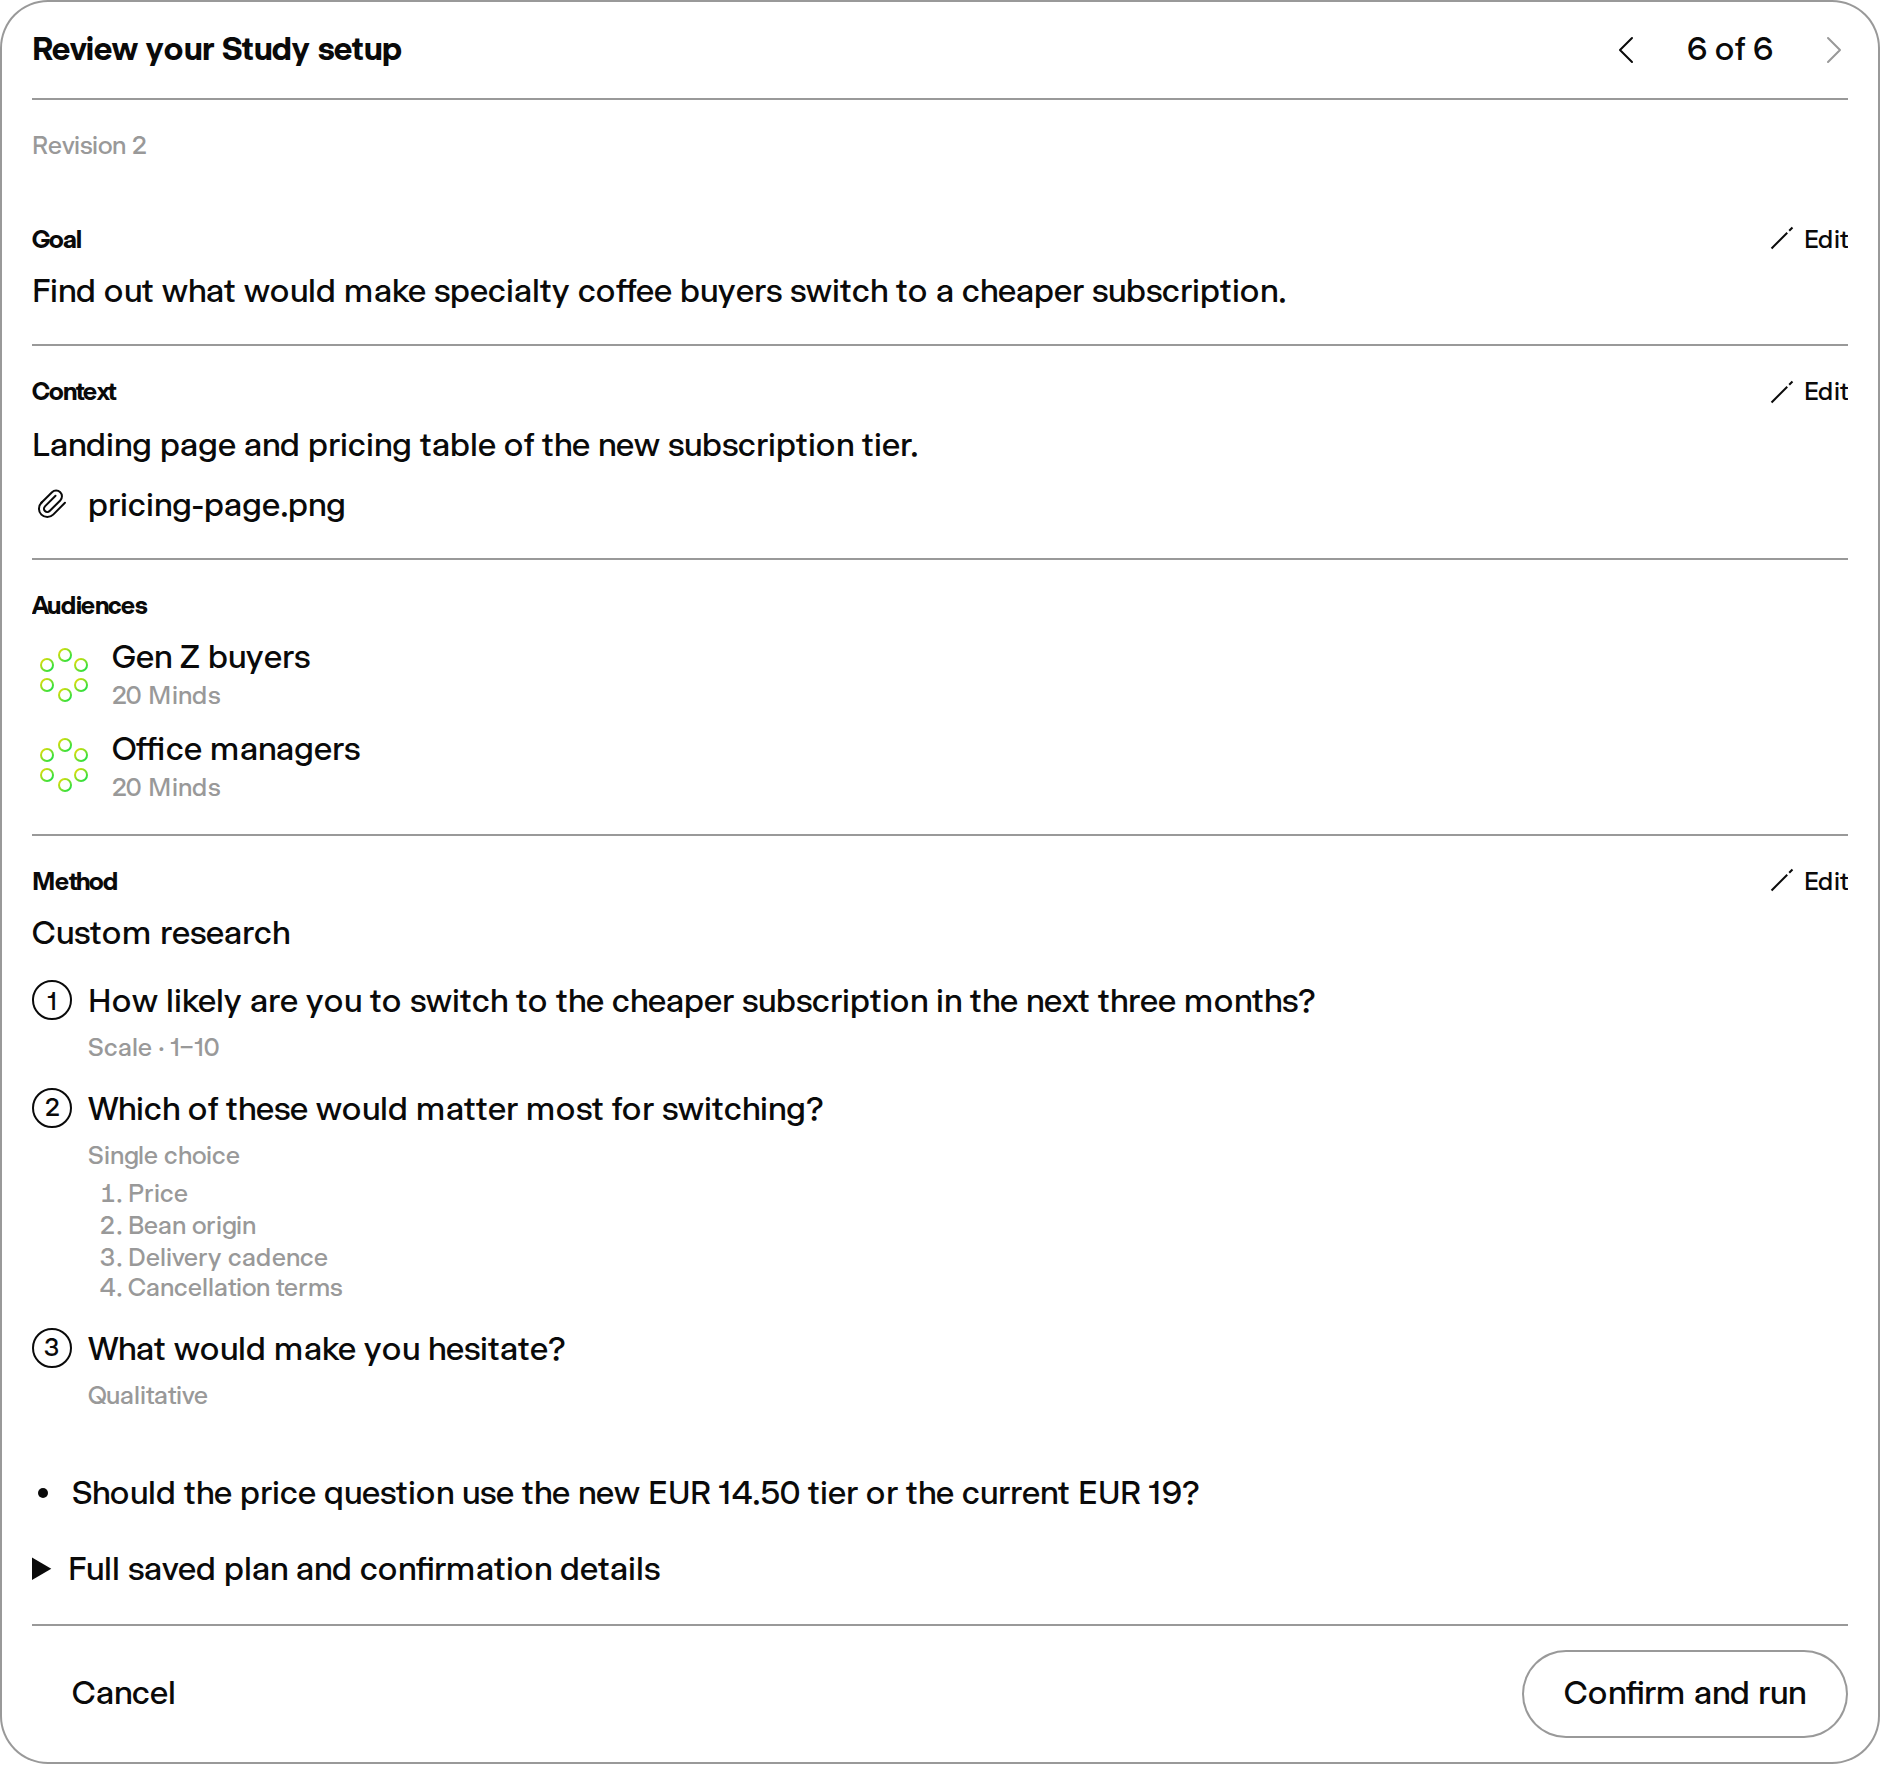
Planerfassung und BestätigungDer Planner erfasst Ziel, Gegenstand, Hauptfrage und Hauptquelle, unterscheidet Nutzerfragen von Agent-Vorschlägen und liefert vor jeder Ausführung ausdrückliche Bestätigungsfragen. Nutzer können den Entwurf überarbeiten oder beim ausführbaren Fragebogenpfad bleiben. Die Bestätigung zeigt für jede Frage das vorgeschlagene Antwortformat—Freitext, Auswahl, eine numerische Standardskala oder eine benutzerdefinierte Skala—und lässt es vor der Ausführung bearbeiten; der bestätigte Antwortvertrag bleibt während der dauerhaften Verarbeitung erhalten. Nach der Bestätigung zeigt Custom in der ursprünglichen Nachricht eine knappe, vom Planner erzeugte Zusammenfassung mit lokalisierter Fragenanzahl und Methodenangabe, statt das vollständige Briefing zu wiederholen. Die Bestätigung richtet sich nach der Urheberschaft und nicht nach der Fragenanzahl: Eine einzelne Frage, die der Planner selbst formuliert hat, einschließlich seiner Lesart einer kurzen Rückfrage wie „wie viel“, wird vor dem Erreichen der Zielgruppe bestätigt, während eine selbst geschriebene Frage direkt ausgeführt wird.
Review step with goal, context, Audiences, method, questions and a confirmation question
StudienspracheEine bestätigte Studie speichert die aktuelle UI-Sprache im Plan und verwendet sie während der gesamten Processor-Ausführung; ältere Pläne ohne Studiensprache behalten den gespeicherten Flow-Owner-Fallback. Eine ausdrücklich gewählte Studiensprache steuert auch serverseitig ergänzte Bestätigungstexte, Fragen, Mind-Antworten, Kategorienamen, Auswertungen je Frage und für den gesamten Lauf sowie spätere Aktualisierungen der Studienzusammenfassung, selbst wenn Mitwirkende oder API-Key-Aufrufe eine andere Sprache verwenden. Startet die Studieninhaberin oder der Studieninhaber einen Fragebogenlauf nach einem Sprachwechsel, verwendet der Lauf die aktuelle Sprache der Anfrage; von Mitwirkenden gestartete Läufe behalten die gespeicherte Sprache der Inhaberin oder des Inhabers bei, damit die gemeinsame Studie konsistent bleibt.
Study language toggle
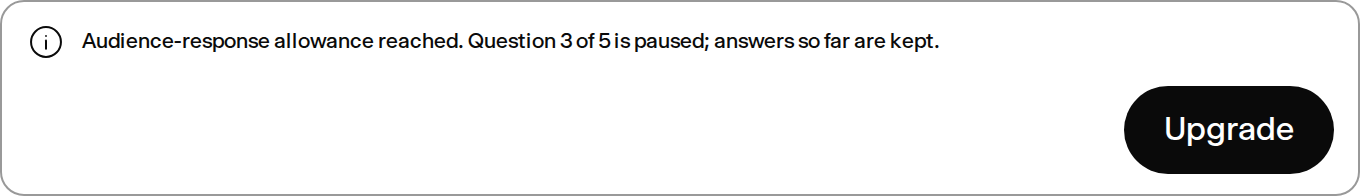
Kontingentprüfung vor und während des LaufsEine bestätigte Custom-Studie prüft ihr Studienkontingent, bevor eine neue Zielgruppe generiert wird. Ein blockierter Start öffnet dadurch sofort den bestehenden kontextbezogenen Upgrade-Pfad, statt zuerst minutenlang eine Zielgruppe vorzubereiten. Zielgruppen-Antwortlimits werden vor dem Start und vor jeder eingereihten Frage geprüft: Blockierte Starts öffnen den Upgrade-Pfad ohne Ausführung; Limits während eines Laufs erhalten Teilergebnisse, stoppen den Rest, informieren die Nutzer:innen und bleiben ausdrücklich als planlimitiert statt abgeschlossen markiert.
Allowance notice pausing a queued question
Ursprungsblock der FragenBestätigte Multi-Fragen-Läufe erscheinen als ein nummerierter Ursprungsblock aus den exakten Fragen; verwaiste akzeptierte oder ausstehende Einträge ohne eingereihten Job bleiben ausgeblendet.
Question header with number, response format and method tags
Pläne über API und MCPBestätigte ausführbare Studien speichern einen unveränderlichen Plan-Snapshot und stellen dauerhaften Fragebogenfortschritt, Methodenberechnungen sowie flexible semantische Zusammenfassungsblöcke über v1 API und MCP bereit; Pläne für visuelle Assets erhalten Heatmap-orientierte Ausgabeabsichten für UI-Renderer.
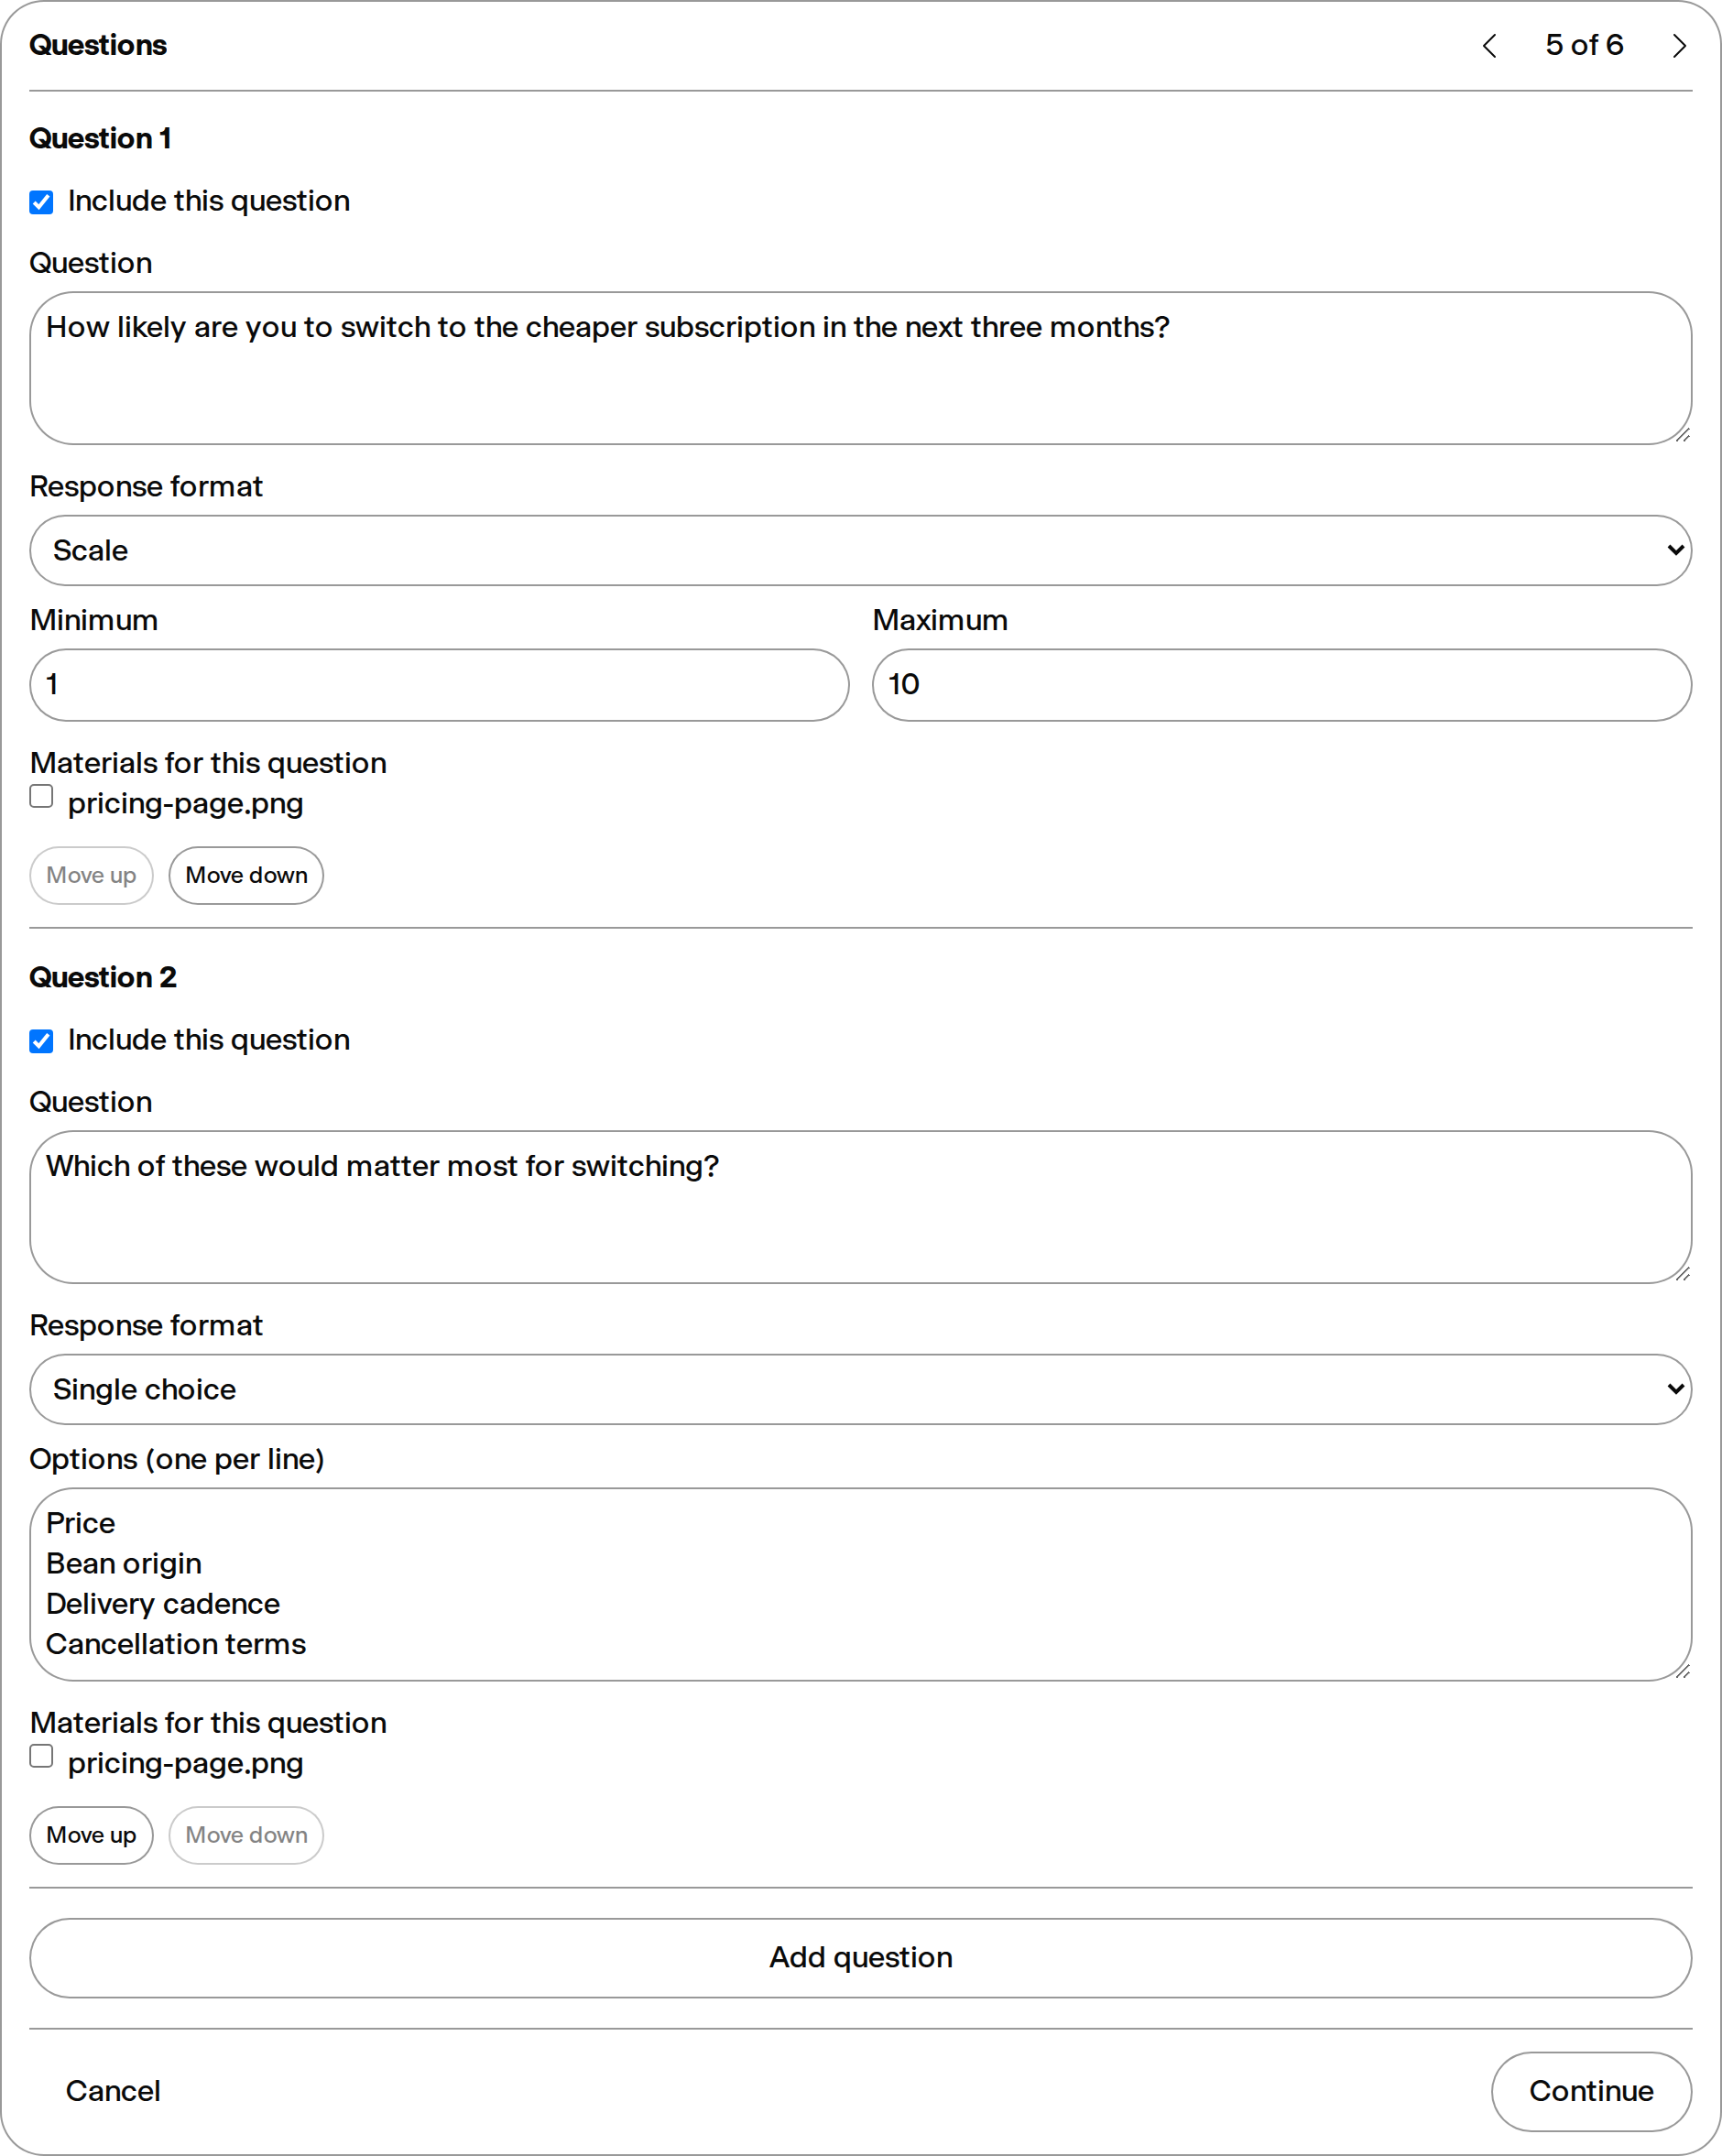
Fragenerkennung und PlanprüfungFragen aus Studieneingaben oder hochgeladenen Fragebogen-Dateien extrahieren und erkennen, das interpretierte Ziel und die Quelle prüfen, nutzerformulierte von vorgeschlagenen Fragen unterscheiden und aus allgemeineren Forschungszielen generierte Multi-Fragen-Pläne vor dem Start bearbeiten. Quick, die Fragengenerierung in Custom, Planrevisionen, v1 und MCP teilen dieselbe Research-Planning-Policy und dasselbe schnelle Planner-Modell. Eine bestätigte verfügbare Methode behält ihren exakten Methoden- und Pipeline-Vertrag im normalen Stream oder dauerhaften Fragebogen-Processor; experimentelle und geplante Methoden bleiben prüfbar, können aber nicht gestartet werden. Die serverseitige Dokumentanalyse verwendet verfügbare authentifizierte Upload-Bytes direkt, sodass Custom- und Fragebogen-Worker nicht davon abhängen, einen relativen Upload-Proxy-Pfad in eine öffentliche URL umzuwandeln.
Questions step with detected questions and response formats
Fragen-WarteschlangeAlle wartenden Einträge mit Live-Fortschritt in einer Fragen-Warteschlange über der Studieneingabe zeigen, weitere Studienanfragen in Eingabereihenfolge anhängen und gruppierte Teilfragen unter der ursprünglichen Anfrage beantworten. Methodengenerierte Aufgaben ersetzen die optimistische Fragenliste durch die ausführbare, vom Processor verwaltete Warteschlange, sodass der Fortschritt auch nach Erweiterungen wie MaxDiff ausgerichtet bleibt. Sobald eine eingereihte Folgenachricht startet, verlässt sie sofort die Warteschlange und erscheint vor ihrer Antwort mit Ladezustand in der Studie. Folgenachrichten bleiben hinter dem aktiven primären Research-Lauf. In einer gespeicherten Studie laufen eingereihte Folgenachrichten dauerhaft im Prozessor weiter, sodass sie ein Neuladen der Seite oder das Schließen und erneute Öffnen der Studie überstehen und trotzdem abgeschlossen werden. Ausstehende Einträge können vor ihrem Start entfernt werden. Wird die letzte sichtbare Zeile einer eingereihten Anfrage entfernt, wird ihr vollständiger dauerhafter Job einschließlich später durch Klassifizierung erzeugter Aufgaben abgebrochen; sobald die Warteschlange leer ist und keine Antwort läuft, startet die nächste Nachricht sofort.
Queued question chip with its remove action
Was als eine Frage giltEine Anfrage wird nur dort getrennt, wo Nutzerinnen und Nutzer eine Liste geschrieben haben: durch Aufzählungszeichen, eigene Zeilen oder aufeinanderfolgende Fragen. Eine mehrteilige Frage bleibt zusammen, sodass ihre Optionen, Nachfragen und umgebrochenen Zeilen bei der zugehörigen Frage bleiben, und eingefügtes Referenzmaterial wird nicht nach den darin enthaltenen rhetorischen Fragen durchsucht. Alles andere wird als eine Forschungsanfrage interpretiert, statt an Satzzeichen zerlegt zu werden.
Abschluss-E-MailWenn eine Studie mit mehr als einer Frage einen längeren Hintergrundlauf abschließt, erhält die einreichende Person eine einzelne E-Mail-Benachrichtigung mit Link zu den Ergebnissen, auch wenn einzelne Fragen nicht abgeschlossen werden konnten; kurze Läufe, abgebrochene Läufe und durch das Antwortkontingent des Plans gestoppte Läufe senden keine E-Mail.
VorlagenFragensätze als Vorlagen speichern und in der individuellen Forschung wiederverwenden, privat oder mit dem Team geteilt.
Saved question template row
Research-MethodenElf deterministische Research-Methoden laufen durchgängig in einer Studie: MaxDiff, NPS, Top-/Bottom-Box, Treiberanalyse, TURF, Gabor-Granger, Van Westendorp, Kano, Ranked Preferences, Segmentvergleich und Conjoint. Signifikanz wird nur behauptet, wenn die Stichprobe sie trägt.
Enthaltene Funktionen
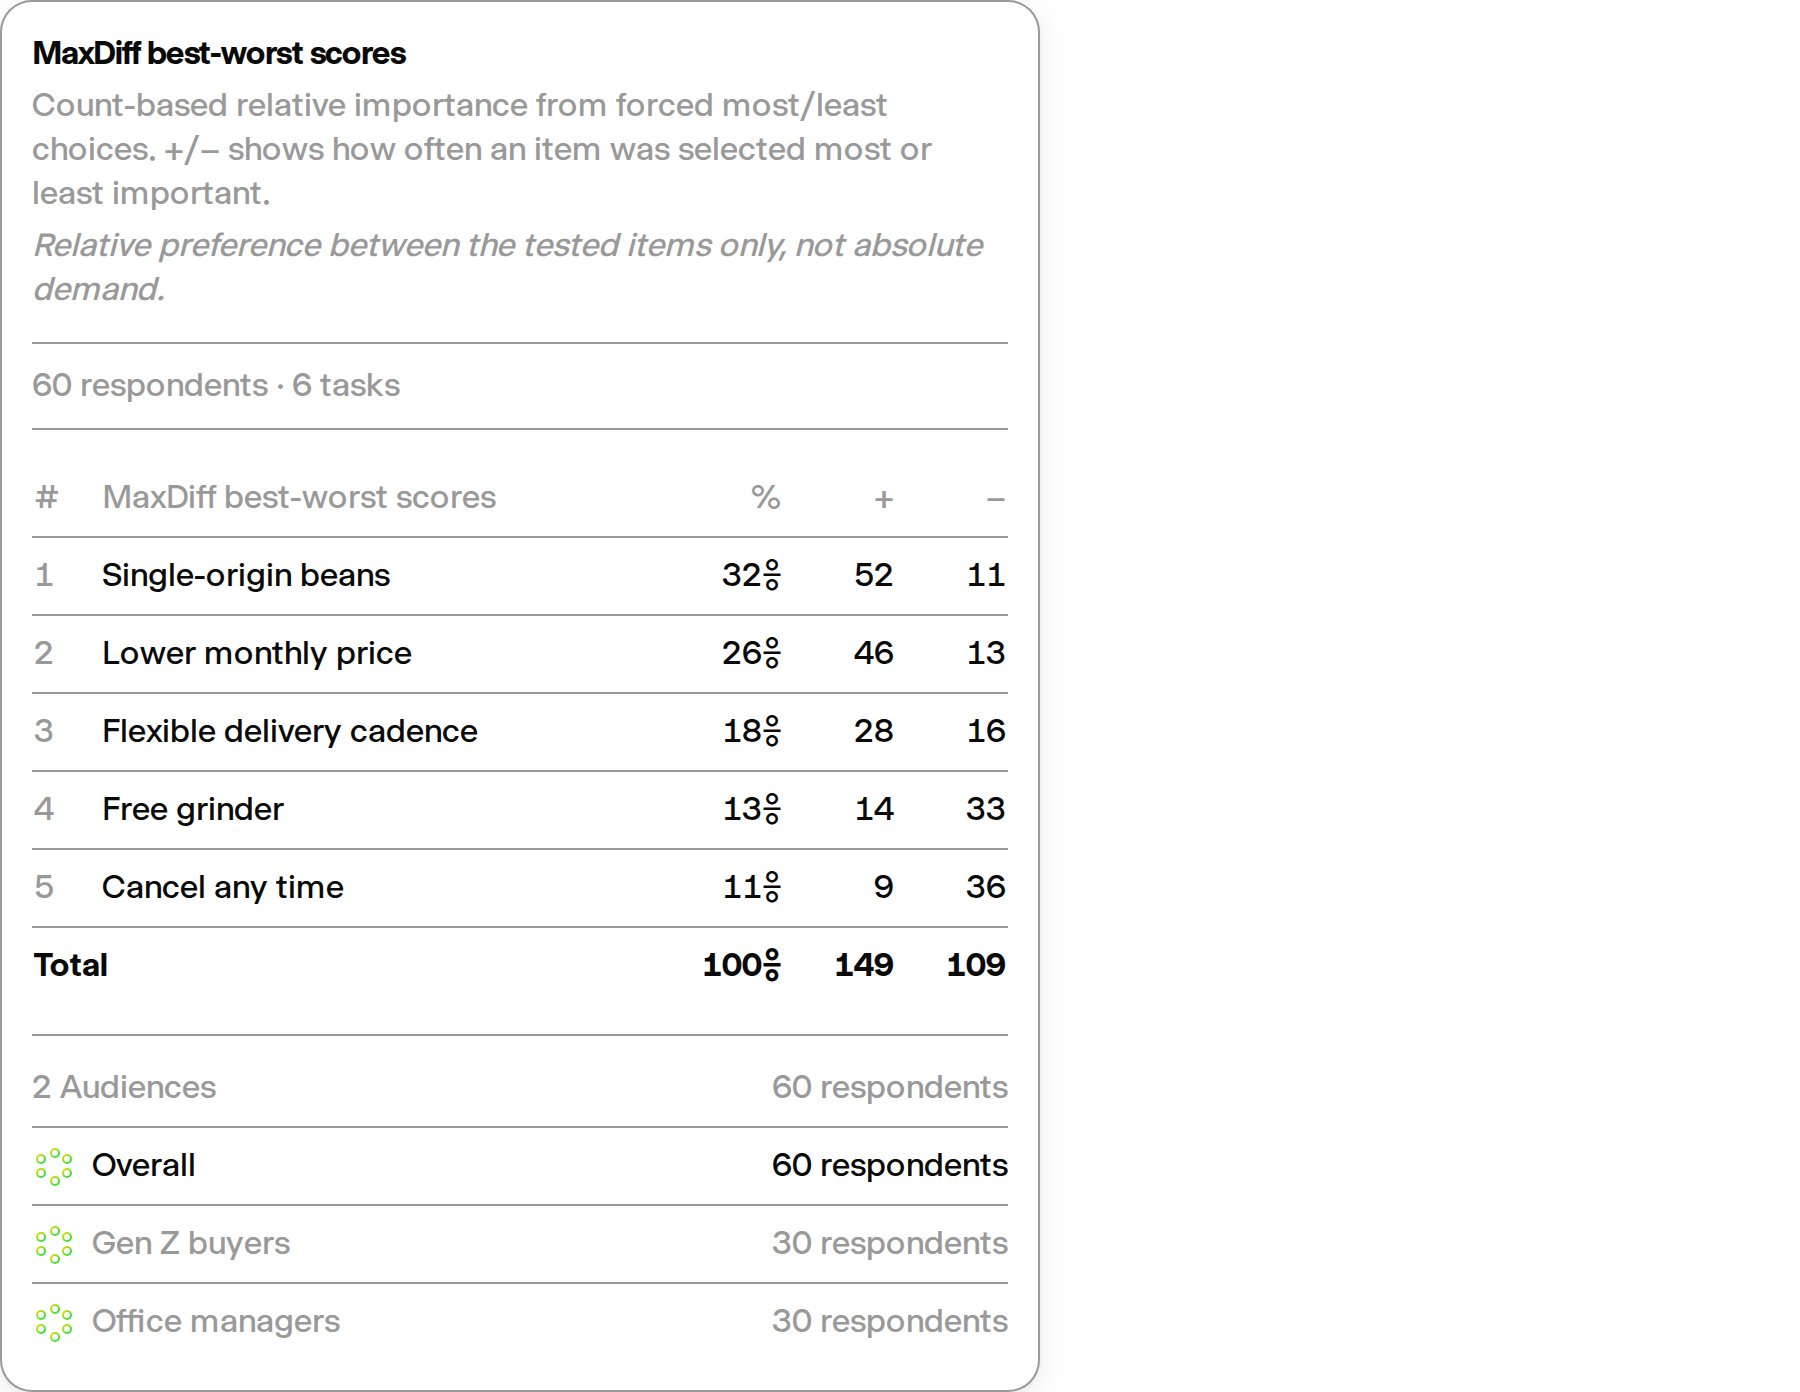
Elf ausführbare MethodenElf Methoden laufen durchgängig: MaxDiff nutzt einen serverseitig entworfenen Forced-Choice-Workflow, und NPS, Top-/Bottom-Box-Auswertung, Treiberanalyse, TURF, Gabor-Granger, Van Westendorp, Kano, Ranked Preferences und Segmentvergleich laufen über denselben deterministischen Adapter-Vertrag mit Gesamt- und Zielgruppenberechnungen, einschließlich paarweiser Signifikanztests zwischen Zielgruppen bei Segmentvergleich, Top-/Bottom-Box-Auswertung, NPS und Ranked Preferences; Auch Conjoint wird ausgeführt: Der Server erstellt ein D-optimales Auswahldesign, lässt zwischen vollständigen Konfigurationen wählen und schätzt mit einem bedingten Logit-Modell Teilnutzenwerte je Ausprägung und die Wichtigkeit je Attribut; ein Design, dessen Teilnutzen nicht getrennt schätzbar wären, wird gar nicht erst ausgerollt. Jede generierte Methodenaufgabe speichert ihren exakten Antwortraum im dauerhaften Job, sodass der Worker Forced-Choice-Optionen nicht neu interpretiert.
MaxDiff best-worst score card
Berechnungen als verbindliche EvidenzDeterministische Berechnungsartefakte dienen als verbindliche Evidenz für die Ergebniszusammenfassung: Das Modell erhält registrierte Methode, Geltungsbereich, methodische Bedeutung und exakte Werte, entscheidet über ihre sachlich passende Platzierung und erklärt sie, ohne Werte neu zu berechnen. Eine abgeschlossene Zusammenfassung kann ein fehlendes gültiges Berechnungsartefakt später erhalten, ohne neu generiert zu werden. Alignment je Frage und Methodenberechnungen für den gesamten Lauf teilen sich ein zusammenfassungsartiges Analyse-Modal, sodass wiederholte Alignment-Werte eindeutig ihrer Frage zugeordnet bleiben statt in einem separaten Rechner-Popover zu erscheinen. Die Startzeit des Processors wird gespeichert, sodass der Ladezähler das erneute Öffnen oder Laden einer Studie übersteht.
Headline metric from a deterministic calculation
SegmentvergleichAntworten verschiedener Zielgruppen vergleichen, um Übereinstimmungen, Unterschiede und abweichende Messaging-Bedarfe zu erkennen.
Belastbare SignifikanztestsSignifikanz wird nur behauptet, wenn die Stichprobe sie trägt: Anteilsvergleiche nutzen den exakten Test nach Fisher statt einer Normalapproximation, deren Voraussetzungen diese Stichprobengrößen nicht erfüllen; Mittelwertvergleiche nutzen Welch-t mit Satterthwaite-Freiheitsgraden, sodass kleine Gruppen ihre eigene Unsicherheit verbreitern; alle Tests eines Ergebnisses werden gemeinsam nach Benjamini-Hochberg korrigiert, damit ein Item nicht allein deshalb signifikant erscheint, weil daneben Dutzende Vergleiche liefen; Gruppen ohne jede interne Streuung können keinen signifikanten Unterschied erzeugen; und ein Vergleich, der gar nicht laufen konnte, wird ausgewiesen, statt ein Schweigen zu hinterlassen, das wie „kein Unterschied“ gelesen wird. Berichtete p-Werte werden nach unten begrenzt statt auf null gerundet, denn kein Ergebnis macht einen Unterschied gewiss.
Methodenwähler mit ErklärungenMethoden, deren Rechner noch nicht ausführbar sind, bleiben im Methodenwähler sichtbar, lassen sich aber nicht auswählen, und eine Studie, die noch auf ihre Berechnung wartet, zeigt im Ergebnisstream einen eigenen Berechnungsschritt. Der Methodenwähler benennt Methoden nicht nur, sondern erklärt sie: Jede Zeile trägt eine Zeile in Alltagssprache, wofür die Methode gedacht ist, und beim Überfahren öffnet sich eine Karte mit der vollständigen Erklärung, die das zugrunde liegende Verfahren benennt — Best-Worst-Scaling, Welch-t-Tests, Total Unduplicated Reach and Frequency —, damit Marktforscherinnen und Marktforscher es wiedererkennen, und dieselbe grundlegende Einschränkung nennt, die auch die Ergebnisse tragen. So ist die Wahl schon vor dem Lauf der Studie informiert und nicht erst danach. Eine Kennzeichnung als „Advanced“ entfällt, da sie Schwierigkeit statt Eignung signalisierte; „Noch nicht verfügbar“ bleibt, weil es die Auswahl tatsächlich verändert. Die Erklärungen sind in allen neun Oberflächensprachen originalsprachlich verfasst und verwenden für Zielgruppe und Studie die jeweils eigenen Begriffe der Sprache statt der englischen.
Method row with its plain-language explanation
Zielgruppen-AntwortenEine Zielgruppe einmal befragen und parallele synthetische Antworten ihrer Minds erhalten, gestützt auf die bereitgestellten Websites, Dateien, Bilder, Videos und Audios.
Enthaltene Funktionen
Verankert im bereitgestellten MaterialEnthält eine Studiennachricht eine erfolgreich geladene Website, Datei, Quelle, einen Screenshot oder ein Bild, muss jede beibehaltene Mind-Antwort ein konkretes Detail aus diesem Material verwenden, statt das Asset als fehlend zu behandeln.
Supplied stimulus shown above the answers
Video- und AudioanalyseBei einem hochgeladenen Video in einer normalen Studienfrage verbindet die Anhangsanalyse das verfügbare Transkript und eine begrenzte Soundtrack-Zeitleiste mit einer begrenzten, szenenbewusst ausgewählten Menge repräsentativer Frames. Bei Videos bis 90 Sekunden wird der vollständige Soundtrack auf wesentliche Musik, Geräuscheffekte, Atmosphäre, Stille, stimmliche Emotion und Audio-Logo-Momente analysiert; längere Videos nutzen höchstens zwölf gleichmäßig verteilte Audioclips von je acht Sekunden. Schlägt die Audioanalyse fehl, bleiben Transkript und visuelle Verarbeitung verfügbar. Eigenständige MP3-, WAV-, M4A-, OGG-, FLAC- und Audio-WebM-Anhänge verwenden dieselbe Transkript- und begrenzte nichtsprachliche Soundtrack-Analyse; fällt einer der beiden Evidenzpfade aus, bleibt der andere verfügbar. Die visuelle Auswahl bewahrt die Abdeckung der Anfangs- und Schlussszene, verteilt Frames bei schnellen Schnitten über die Videolänge und fällt auf drei gleichmäßig verteilte Frames zurück, wenn sich keine verlässlichen Schnitte erkennen lassen.
Video scene timeline
Dauerhafte HintergrundverarbeitungGrößere Zielgruppenanfragen laufen dauerhaft im Hintergrund weiter, zeigen Live-Fortschritt und werden nach einem Neuladen der Seite wiederhergestellt. Bei großen Zielgruppen wird die Antwortarbeit in dauerhafte Batches auf die verfügbare Verarbeitungskapazität verteilt; jede Mind-Antwort wird direkt nach ihrem Abschluss gestreamt, ohne auf den gesamten Batch zu warten, und begrenzte Wiederholungsversuche bearbeiten nur noch fehlende Minds.
Running Study with elapsed time and queued questions
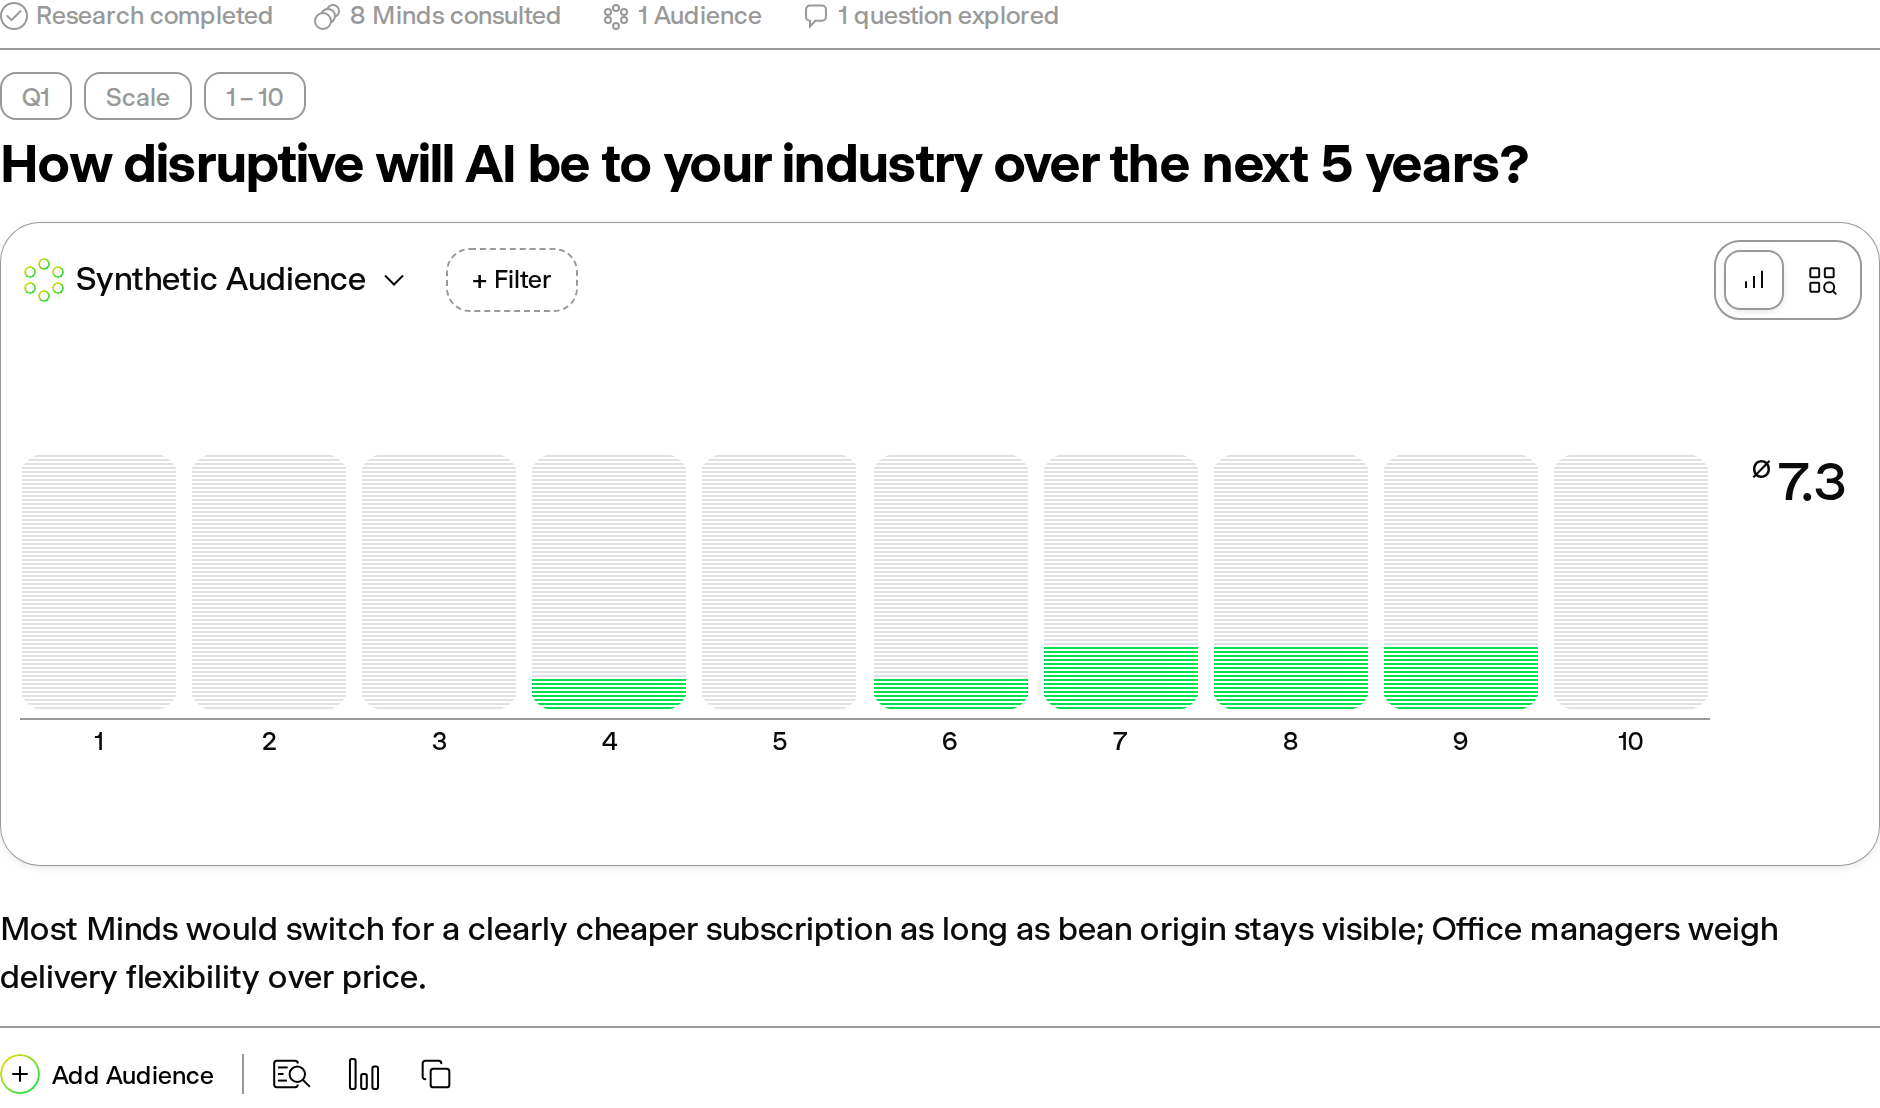
Überschrift, Zusammenfassung und DiagrammeJedes abgeschlossene Ergebnis zeigt zuerst seine Überschrift und eine gestreamte Research-Zusammenfassung. Eine einzelne Frage ergänzt ein kompaktes Antwortdiagramm, bevor die Antwortzeilen der Minds im ausklappbaren Bereich „Evidenz“ folgen. Ein mehrteiliges Research-Ergebnis zeigt ein bis vier, in der Regel zwei, nebeneinander angeordnete Diagramme zu zentralen Erkenntnissen. Sie werden anhand der vollständigen Research-Anfrage und der Gesamtzusammenfassung ausgewählt, nicht allein nach der höchsten Prozentzahl. Jedes Diagramm basiert auf verifizierten Antwortzahlen: ein fokussierter Prozent- oder Skalenwert für eine eigenständige Erkenntnis oder ein Zwei- beziehungsweise Drei-Werte-Vergleich, sobald die Aussage einen Vergleich formuliert. Jede verarbeitete Frage erhält einen eigenen ausklappbaren Bereich mit Antwortdiagramm, Zielgruppenverteilungen und Evidenz auf Mind-Ebene.
Audience response block with chart, summary and actions
Anhangsvergleiche und Asset-ZuordnungErgebnisse von Anhangsvergleichen zeigen ursprüngliche Bildmotive und Vorschauen des ersten Video-Frames direkt über den A/B/C-Spalten, ordnen Varianten anhand des gespeicherten Dateinamens und Vorkommens statt der rohen Anhangsposition zu und lassen historische Stimmen und Erkenntnisse beim erneuten Öffnen unverändert.
Variant preview of an attachment comparison
Quellenangaben an AntwortenNutzt ein Mind abgerufenes Wissen aus seiner Wissensbasis oder Web-Evidenz, zeigen Hover-Karte und „Closer Look“ Quellenlogos direkt an den belegten Aussagen – mit demselben Inline-Zitationssystem wie in Marktplatz-Beschreibungen. Beim Generieren zugeordnete Quellen werden mit der Antwort gespeichert; historische Antworten werden bei Bedarf anhand der aktuellen Wissensbasis des Minds geprüft und im Quellen-Tooltip ausdrücklich als nachträglich verifiziert gekennzeichnet, statt diese Prüfung als ursprüngliche Provenienz auszugeben. Das v1-Ergebnis enthält optional Zitationsmarker, Quellenidentitäten und Provenienz, jedoch nicht den zugrunde liegenden privaten Wissenstext.
Stimulus-TestsTexte, Landingpages, Screenshots, Decks, Produktkonzepte und Wettbewerbermaterial in einer Studie testen.
Heatmap-TestsWebsite-, Video- oder Bild-Heatmaps erfassen simulierte Aufmerksamkeits- und Interaktionssignale.
Enthaltene Funktionen
Evidenz aus der beobachteten SeiteSichtbare Website- und Medien-Evidenz hat Vorrang vor einer früheren unbelegten Annahme; Website-Zusammenfassungen werden aus dem beobachteten Seitenverlauf statt aus einer veralteten Antwort vor dem Browsen abgeleitet.
Website heatmap surface with Mind markers on the observed page
Video- und TranskriptverarbeitungHochgeladene Medien verwenden einen konfigurierten Ersatzdienst, wenn der primäre Transkriptionsanbieter nicht verfügbar ist. Video-Reaktionen verbinden das verfügbare vollständige Transkript mit konkreten sichtbaren Elementen in ausgewählten Frames und nutzen eine rein visuelle Analyse, wenn die Transkription weiterhin nicht verfügbar ist.
Video analysis action
Mehrere Bilder oder Videos je FrageJedes hochgeladene Bild wird als eigenständiges Creative in einem gemeinsamen Ergebnis analysiert; mit Buchstaben beschriftete Tabs behalten den jeweiligen Dateinamen. Bei mehreren zugeordneten Videos zeigt die Auswahl die jeweils gespeicherten Szenen, Heatmap und Mind-Reaktionen. Eine fehlende Analyse wird für die gewählte Frage und Datei gestartet; bestehende Analysen und die Gesamtergebnisse bleiben beim Wechsel erhalten.
Page selector for several tested pages
Einheitlich in UI, API und MCPUI, v1 und MCP verwenden dieselbe Zielprüfung und Analyse-Pipeline.
Geplante StudienStudien täglich, wöchentlich, monatlich oder quartalsweise erneut ausführen. Läufe werden zuverlässig im Hintergrund fortgesetzt, nach Worker-Unterbrechungen wiederaufgenommen und für Prüfung und Export gespeichert.
Research-GlaubwürdigkeitskontrollenDie Evidenzgrenze bleibt von der Zielgruppenerstellung bis zu den Studienantworten sichtbar: Modellierte Annahmen gelten nie als gemessene Fakten, und jede Studie weist ihre eigene Vollständigkeit aus.
Enthaltene Funktionen
Modellierte Annahmen bleiben gekennzeichnetWenn Quellenmaterial lesbar ist, aber keine evidenzgestützte Verteilung angewendet werden kann, bewahrt Minds alle hochgeladenen Materialien zur Prüfung auf und hält diese Zielgruppe auf modellierte Annahmen statt gemessener Kundenfakten fest: Ihre Minds werden angewiesen, Persona-Details als synthetische Szenario-Annahmen zu behandeln, sodass die Grenze in den Antworten selbst durchgesetzt wird und nicht als Kennzeichen, das gelesen und gedeutet werden muss. Bei der Erstellung synthetischer Personas und in Studienantworten werden unbelegte exakte Mitarbeiterzahlen, Umsätze, Budgets, Einkommen, Richtlinienlecks, Vorfallzahlen und Marktanteile vermieden.
Assumed distribution label
Briefings und Quellen bleiben am PlanAngehängte Studienbriefings fließen direkt in den Planner ein; jedes ausdrücklich genannte Kriterium bleibt als eigene prüfbare Frage erhalten, und der vollständige Studienplan wird bei der Zielgruppenübergabe bis zur Bestätigung weitergereicht, statt nur die erste Frage auszuführen. Eine Studie behält außerdem das Material, das ihre Anfrage mitgebracht hat. Eine Website oder Datei, die in der Nachricht genannt, im Composer angehängt oder während der Planprüfung ergänzt wurde, wird zur bestätigten Quelle des Plans und begleitet jede Frage des Durchlaufs. Das Ersetzen der ursprünglichen Formulierung durch Planner-Fragen kann die geprüfte Seite oder das geprüfte Dokument damit nicht mehr verlieren. Lässt sich eine Kontextdatei nicht lesen, startet die Studie nicht, statt Ergebnisse zu Material zu veröffentlichen, das niemand geöffnet hat.
Context step carrying the brief and the attached file
Vollständigkeit einer abgeschlossenen StudieEine abgeschlossene Studie weist außerdem ihre eigene Vollständigkeit aus. Scheitert eine Frage, zieht die Studie ihr Fazit aus den Fragen, die geantwortet haben, und nennt deren Anzahl, statt einen Durchlauf zu verwerfen, dessen übrige Antworten weiterhin gültig sind; ein erneuter Versuch der gescheiterten Frage baut das Gesamtfazit auf der breiteren Evidenz neu auf. Eine Studie, die nicht mehr antwortet, weist darauf samt Anzahl der gesammelten Antworten hin und kann auf Wunsch aus ihnen abgeschlossen werden, statt einen endlosen Fortschrittszustand zu zeigen. Ein Fazit, das ohne vollständige Gesamtauswertung aus den einzelnen Fragebefunden zusammengesetzt wurde, wird als solches gekennzeichnet.
Response coverage notice of a finished Study

Analyse und Ergebnisse

Strukturierte Ergebnisse, die Antworten in verwertbares Research-Material überführen.

FeatureBeschreibung
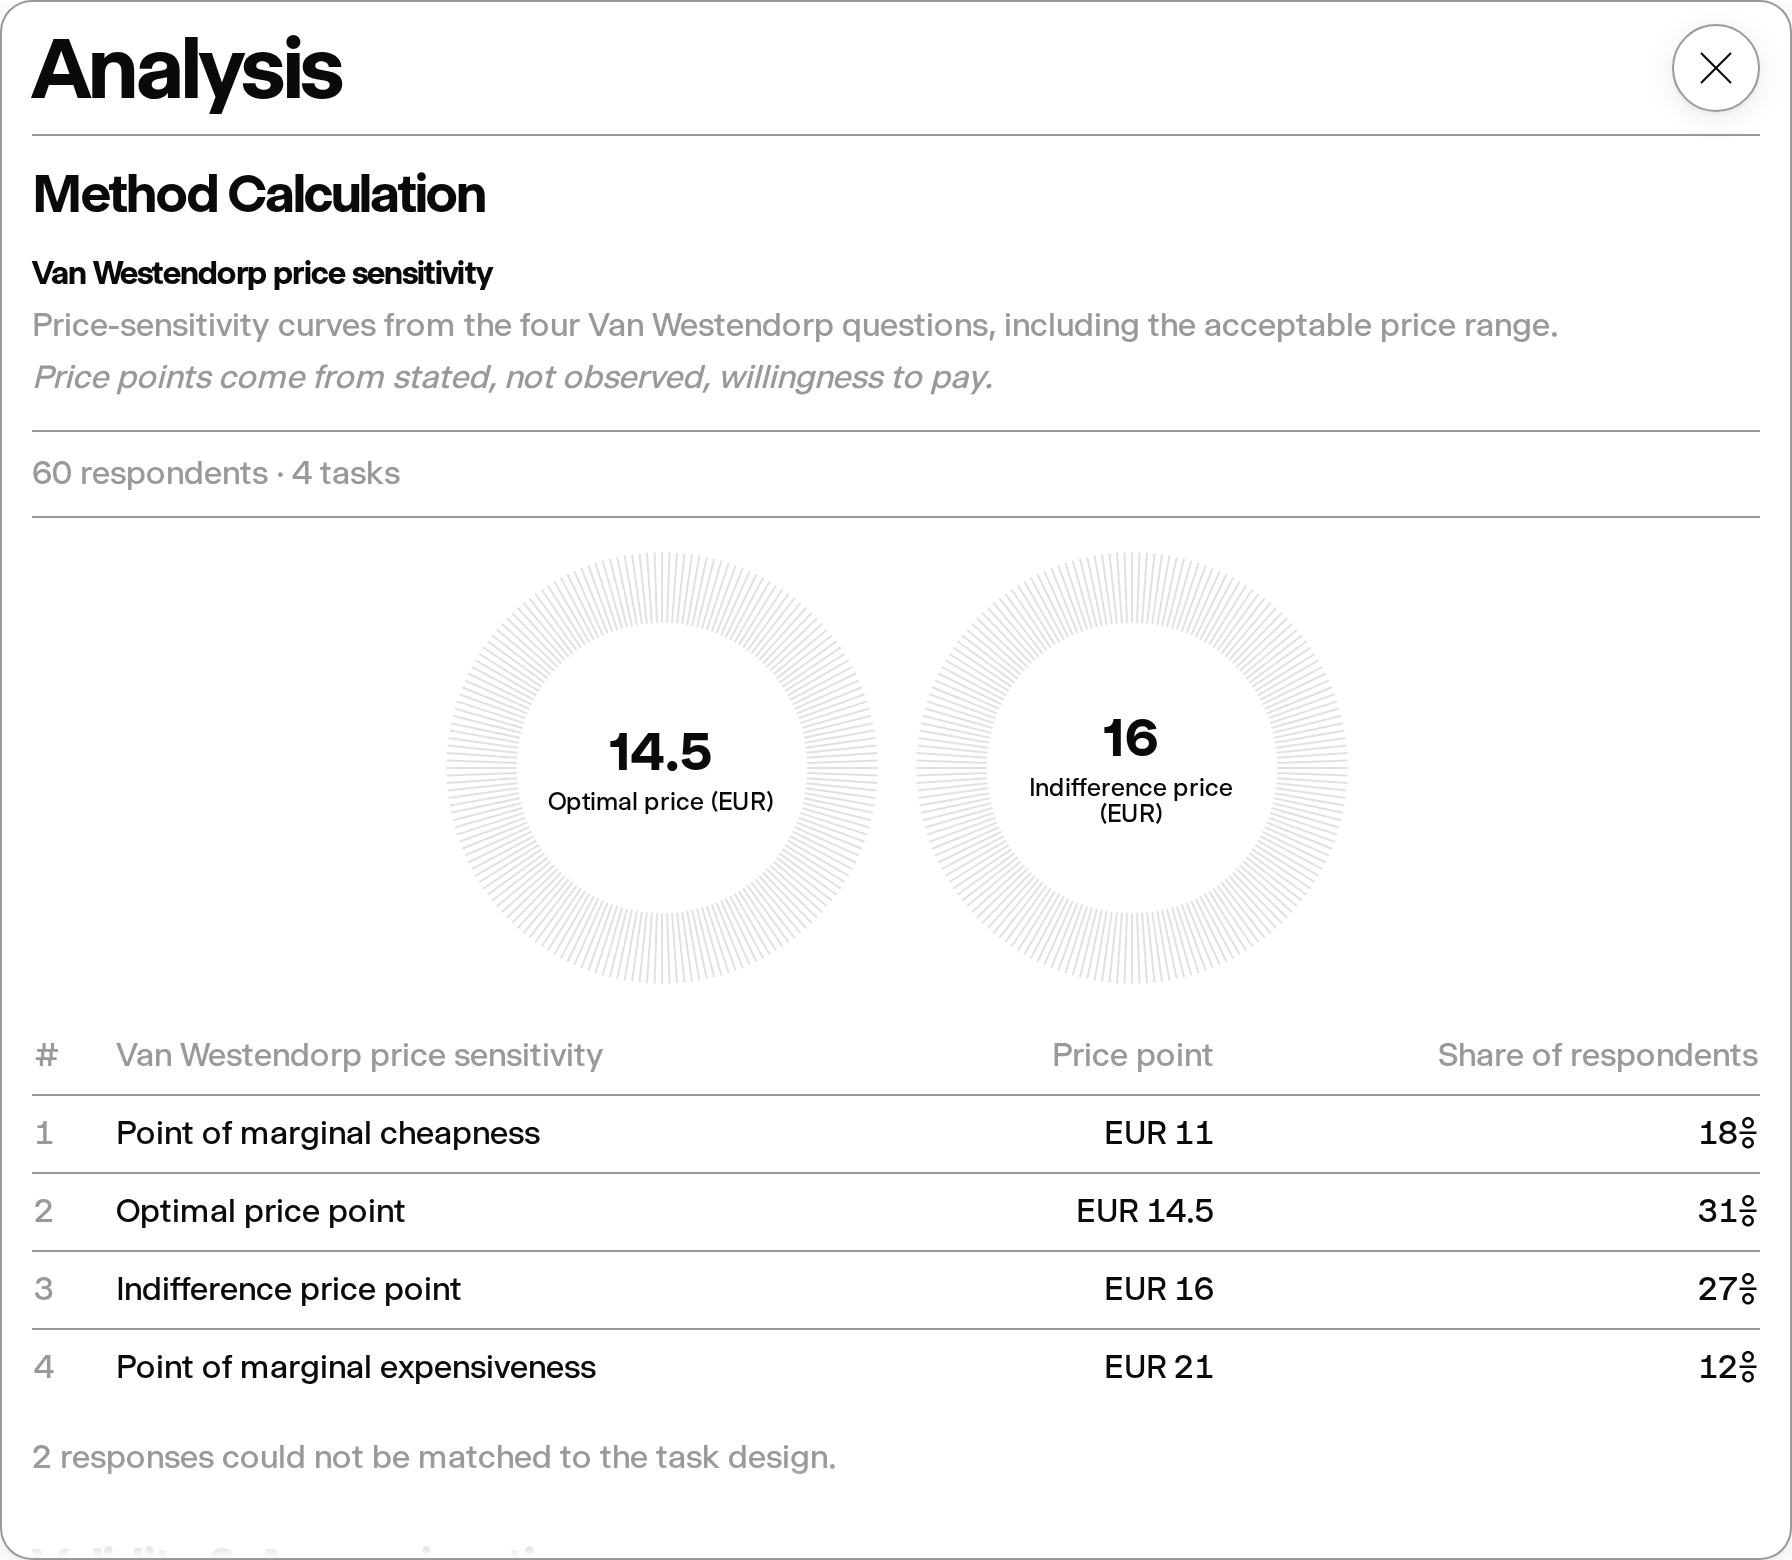
Methodenergebnisse und AnalyseDeterministische Methodenergebnisse öffnen in einem Analyse-Modal mit der Berechnung, einer Tabelle zu Validität und Approximation und der grundlegenden Einschränkung jeder Methode direkt neben den Zahlen.
Enthaltene Funktionen
Analyse-ModalDeterministische Methodenergebnisse im zusammenfassungsartigen Analyse-Modal öffnen, während der Workspace hinter einem weichgezeichneten Hintergrund sichtbar bleibt. Das Modal zeigt zwei einheitliche Tabellen: zuerst die Methodenberechnung, danach eine Tabelle zu Validität und Approximation mit Persönlichkeits- und Verteilungsübereinstimmung je Frage; jede Abschnittsüberschrift wird beim Überfahren erklärt. Jede rechnergestützte Methode—MaxDiff, NPS, Top-/Bottom-Box, Treiberanalyse, TURF, Gabor-Granger, Van Westendorp, Kano, Ranked Preferences und Segmentvergleich—deklariert im selben Modal ihre eigenen Tabellenspalten, Kennzahlen, Kategorie-Tags und Ergebnisnotizen, einschließlich paarweiser Signifikanzhinweise zwischen Zielgruppen bei Segmentvergleich, Top-/Bottom-Box, NPS und Ranked Preferences. Jede Zielgruppenzeile trägt das Minds-Gruppenicon und schaltet die Tabelle auf die Berechnung dieser Zielgruppe um.
Analysis modal with the method calculation
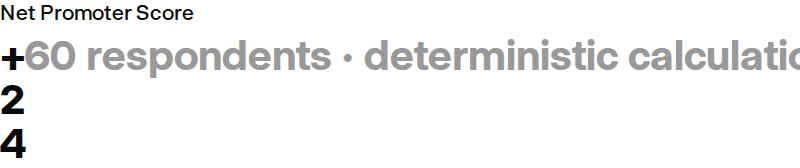
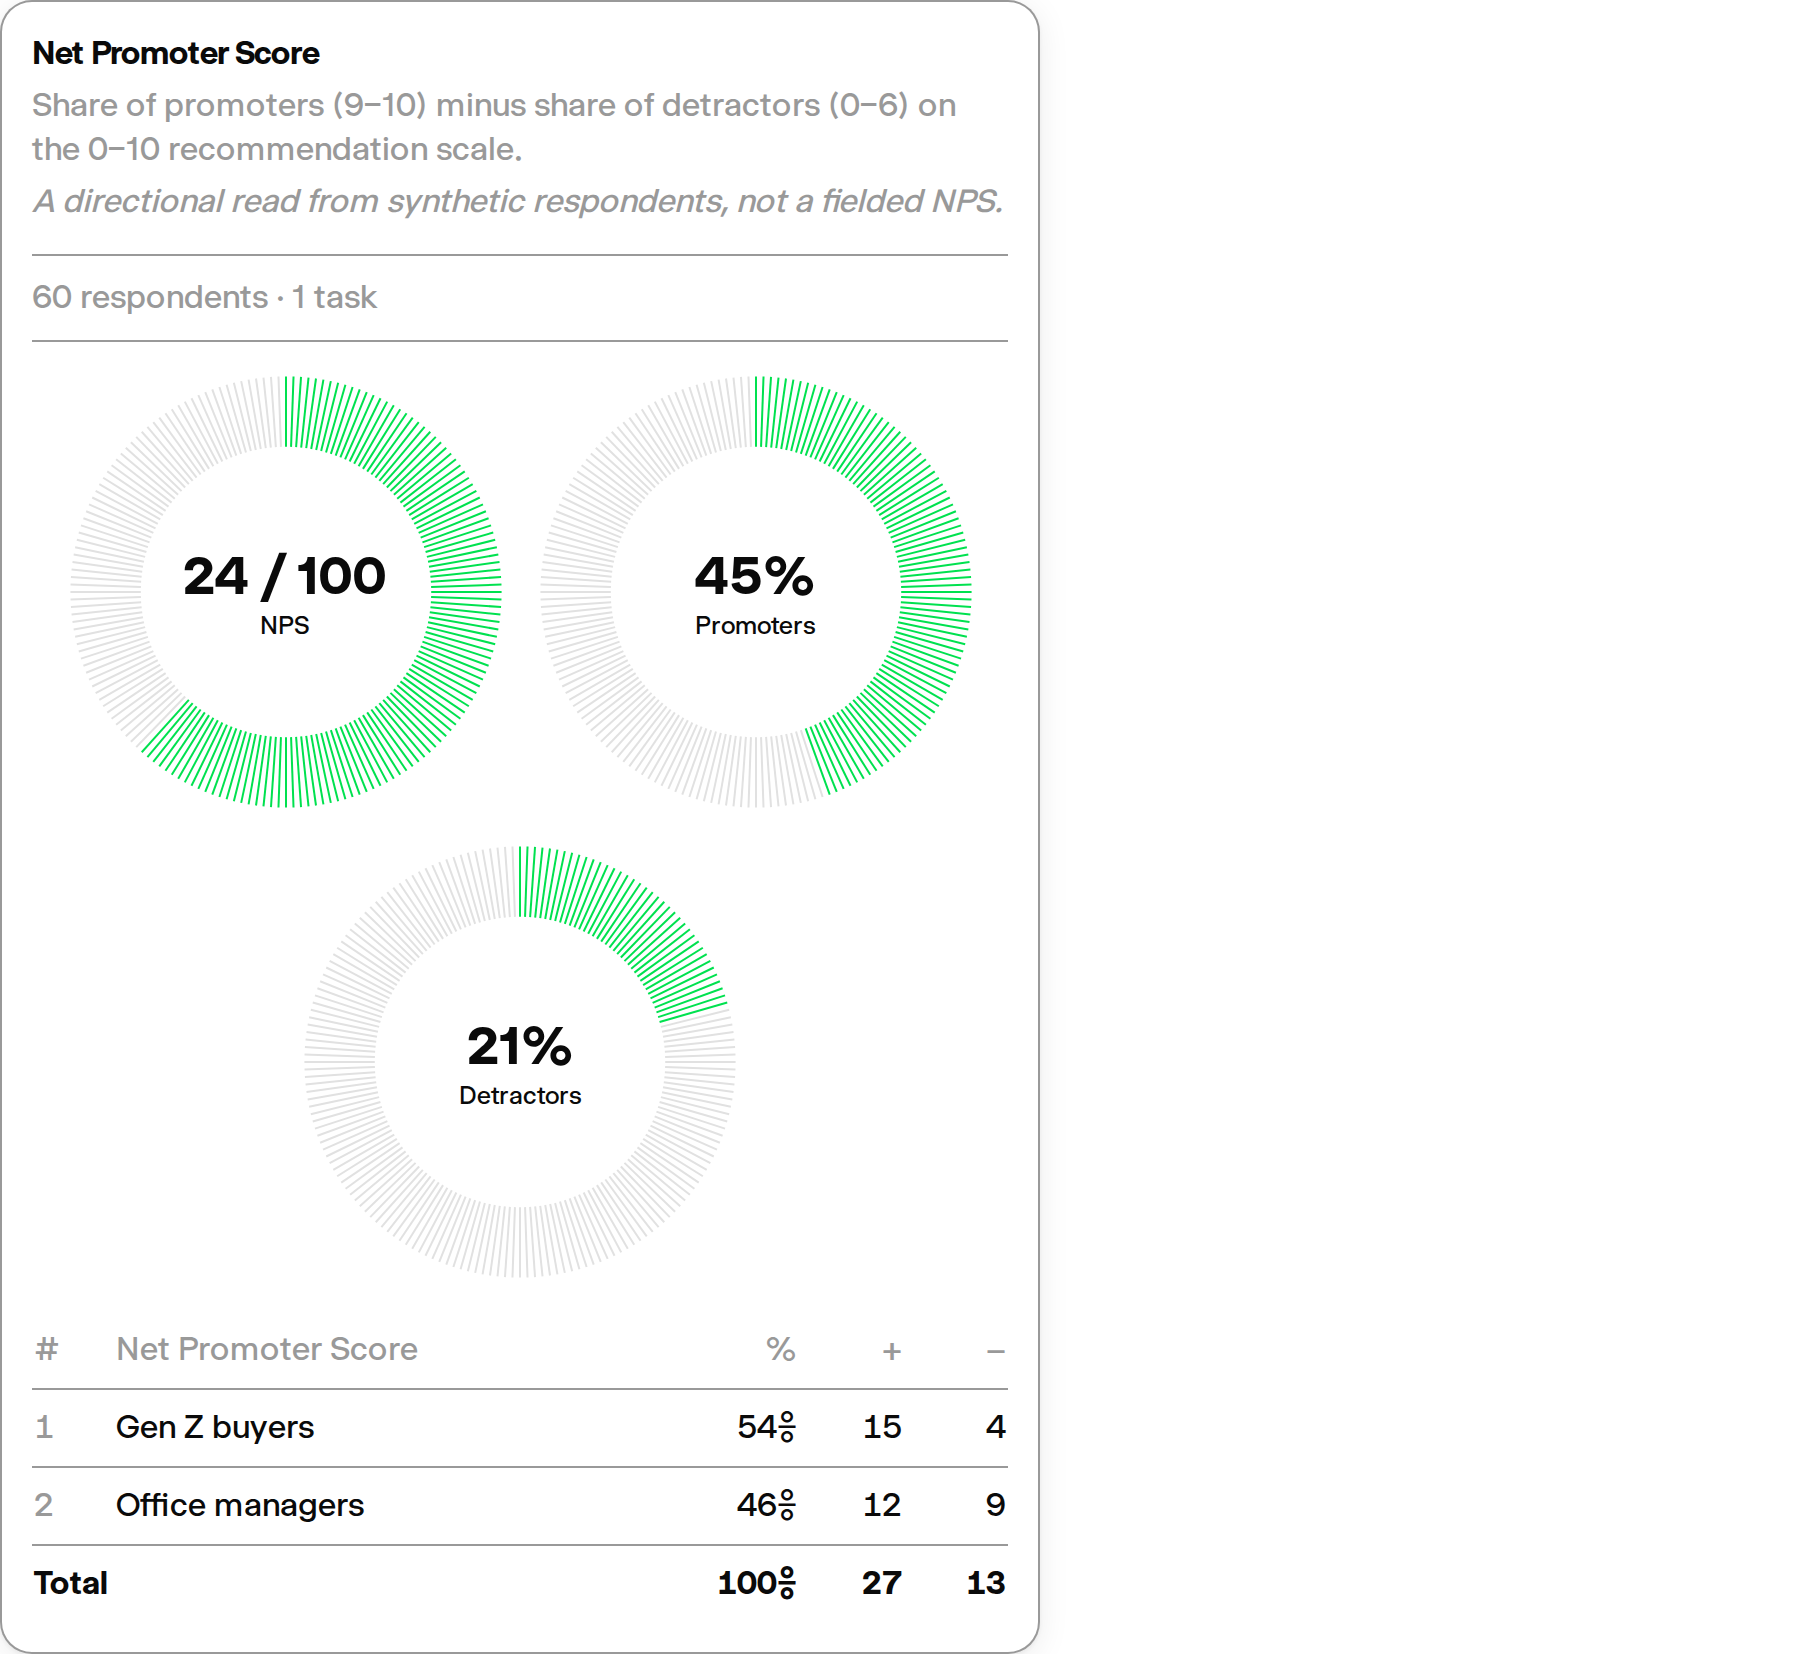
Einschränkungen und ehrliche SkalenJede Methode nennt ihre grundlegende Einschränkung direkt neben den Zahlen — was das Ergebnis nicht ist — und nicht nur in der generierten Zusammenfassung; bei der Treiberanalyse wird ausgewiesen, ob ein Treiber das Ergebnis hebt oder senkt, da die Wichtigkeit selbst vorzeichenlos ist. Kennzahlen nutzen das Standard-Donut-Diagramm auf ihrer ehrlichen Skala, etwa NPS von −100 bis 100, und Tabellen erhalten Gesamt- oder Durchschnittszeilen nur dort, wo sich die Zeilen tatsächlich zu einem Ganzen summieren — je Spalte deklariert, damit eine zeilenweise Stichprobengröße nie zu einer Zahl größer als das Panel summiert wird.
NPS card on its -100 to 100 scale with the standing limitation
Verlässlicher MethodenwechselDie Methodenwahl wird erst übernommen, wenn ein dazu passender Plan vorliegt, sodass der Wähler nie eine Methode anzeigt, die die Studie gar nicht ausführt; ein fehlgeschlagener Wechsel behält die bisherige Methode, statt die Studie beim erneuten Versuch stillschweigend auf Custom Research zurückzusetzen. Eine Methode mit nahezu korrekter Konfiguration wird vor dem Lauf repariert statt zu einem qualitativen Lauf herabgestuft, sodass die deterministische Berechnung dennoch entsteht. Ein Deployment während eines laufenden Studienlaufs lädt die Seite nicht mehr unter der Studie weg: Die neue Version wird bei der nächsten Navigation nach Abschluss des Laufs übernommen, und der Wechsel zu einer Forced-Choice-Methode formuliert die Fragen in der Form dieser Methode neu, statt an Fragen der vorherigen Methode zu scheitern. Eine Studie, deren Methode eine deterministische Berechnung deklariert, berechnet sie auch bei Läufen mit einer einzigen Frage, und ihr Ergebnis bleibt im Ladezustand, bis die Berechnung vorliegt — das sofort geöffnete Analyse-Modal zeigt so immer die Methodentabelle.
Method row marked not available yet
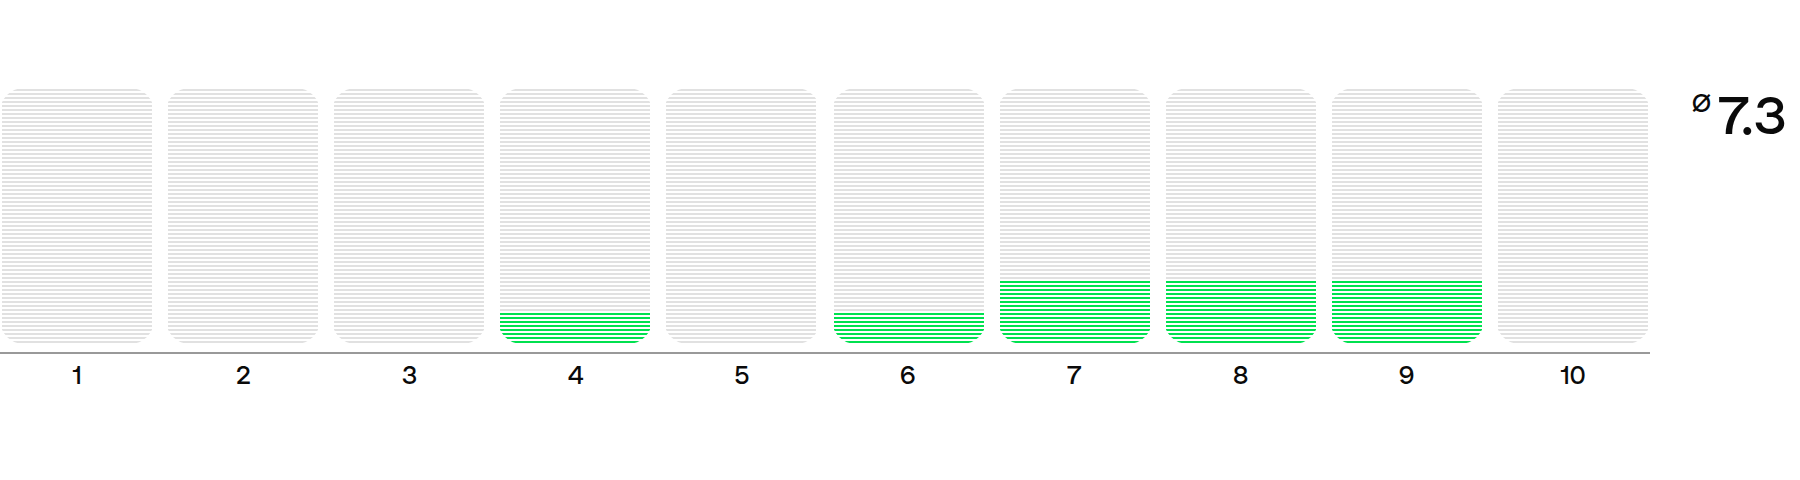
AntwortaggregationSkalen-, Einfachauswahl-, Mehrfachauswahl- und Freitextantworten in Durchschnittswerte mit einer Nachkommastelle, unabhängige Auswahlquoten, Verteilungen und Themen verdichten.
Scale overview from 1 to 10 with the share of answers per point and the average
Kanonische AntwortkategorienFreitextantworten werden mit einem versionierten Kategoriensystem samt Definitionen, Regeln und exakten Belegstellen kodiert: automatisierte Inhaltsanalyse mit Modellprüfung, keine menschliche Intercoder-Validierung.
Enthaltene Funktionen
KategoriensystemQualitative Antworten werden anhand ihres vollständigen gespeicherten Textes mit einem versionierten Kategoriensystem, Definitionen, Ein- und Ausschlussregeln sowie exakten Belegstellen kategorisiert. Gleichbedeutende Formulierungen teilen eine Kategorie; gegensätzliche Aussagen bleiben getrennt. Hauptkategorien zählen eine Stimme pro Antwort, weitere Codes bleiben an der Antwort erhalten.
Coded categories with a representative quote each
Große Studien und nicht kategorisierte AntwortenBegrenzte Verarbeitungsblöcke unterstützen große Studien. Mehrdeutige oder fehlgeschlagene Zuordnungen werden als nicht kategorisiert ausgewiesen.
Coding notice with uncoded answers
Gespeicherte Ergebnisse neu kategorisierenEigentümer und Mitwirkende können bestehende Ergebnisse neu kategorisieren, ohne Antworten neu zu generieren; ursprüngliche und neuere Kategorieversionen bleiben erhalten.
Geltungsbereich und A/B-VariantenEs handelt sich um automatisierte strukturierte Inhaltsanalyse mit Modellprüfung statt menschlicher Intercoder-Validierung. Bei A/B-Tests bleiben hochgeladene Varianten der feste Antwortraum, einschließlich nicht gewählter Varianten.
StudienzusammenfassungenOn-Demand-Rolling-Zusammenfassungen einer Studie mit hervorgehobenen Themen und Zusammenfassungs-Charts erstellen und im weiteren Studienverlauf aktualisieren.
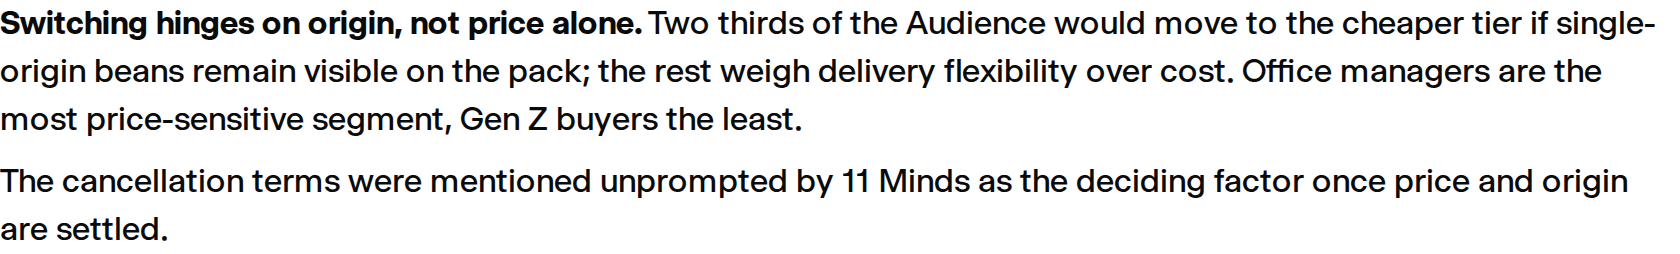
Study summary prose with the headline finding in bold
Strukturierte ExporteAntworten, Transkripte, Studienergebnisse und Executive Summaries als Markdown, JSON, PDF, gebrandetes Word oder 16:9-PowerPoint exportieren; Rohdaten als SPSS-SAV, CSV und XLS.
Enthaltene Funktionen
Executive Summaries und StudienberichteExecutive Summaries sind als PDF, editierbare Markdown- und Word-Dokumente sowie als foliennativer PowerPoint-Foliensatz im 16:9-Format verfügbar, der Executive Takeaway, Kennzahlen, teilnehmende Gruppen, bis zu vier evidenzbasierte Erkenntnisse, Entscheidungstreiber, Methodik und Quellen zeigt. Vollständige Studienberichte verwenden dieselbe 16:9-Insights-Deck-Struktur in PDF und PowerPoint sowie fließende Markdown- und Word-Begleitdokumente.
Personaprofile und ZielgruppenprofilePersonaprofile und Zielgruppenprofile nutzen dasselbe foliennative System mit eigener Identität, Merkmalen oder Zusammensetzung, teilnehmenden Minds, Methodik und Quellenhierarchie.
Ein Teilen- und ExportmenüDer Export-Button einer Antwort und die Teilen-Aktion der Zusammenfassung öffnen dasselbe studienweite Teilen- und Exportmenü wie die Steuerung in der Kopfzeile.
Result actions with Export
RohdatenUnterstützte Research-Ergebnisse wie Antworten, Transkripte, Studienergebnisse und Executive Summaries als Markdown, JSON, PDF oder gebrandete Word-Dokumente exportieren, einschließlich Persona- und Zielgruppen-Exporten mit ihren Quellen und Hinweisen, soweit verfügbar. Studienrohdaten sind zusätzlich zu CSV und XLS als native SPSS-SAV-Datei verfügbar.

Zusammenarbeit

Teamfunktionen für gemeinsame Nutzung und Administration.

FeatureBeschreibung
Gemeinsamer Team-ArbeitsbereichIn einem gemeinsamen Arbeitsbereich für teambezogene Minds, Zielgruppen, Studien und Research-Materialien arbeiten. Zielgruppen-Eigentümer, eingeladene Mitwirkende und Mitglieder des geteilten Pro-Arbeitsbereichs können gewöhnliche Zielgruppendetails, Freigabeeinstellungen sowie Marktplatz-Cover oder berechtigte Logo-Medien bearbeiten; öffentliche und reine Studienansichten bleiben schreibgeschützt, während destruktive, Zugriffs-, Verifizierungs- und Abrechnungsvorgänge strengeren Berechtigungen unterliegen.
Sitzplatz- und RollenverwaltungTeam-Sitzplätze, Zugriffe und Arbeitsbereichsadministration in den Team-Einstellungen verwalten. Mehrere E-Mail-Adressen einfügen, eine gemeinsame Mitglieds- oder Adminrolle wählen und ungültige Adressen oder bestehende Einladungen vor dem Versand prüfen; zusätzliche kostenpflichtige Sitzplätze erfordern eine Bestätigung; fehlgeschlagene Einladungen bleiben zur Korrektur und zum erneuten Versand erhalten.
Enthaltene Funktionen
Kunden-Onboarding für PartnerFreigeschaltete Partner können getrennte Kundenarbeitsbereiche anlegen, Audiences zuweisen und Funktionen ausschließlich für ihre eigenen Kunden steuern. Vertragspakete enthalten gekaufte Sitzplätze, zeitlich begrenzte Early-Bird-Boni und getrennte monatliche Antwortkontingente; die Abrechnung zeigt die interne Lizenz und benannte Kundenpositionen, die der Partner bezahlt.
Partner customer onboarding controls
Gepoolte Team-NutzungAntwortkontingente über Sitzplätze hinweg bündeln, damit die Nutzung auf Arbeitsbereichsebene gesteuert werden kann.
Studien teilen und GastzugangEine Studie per Link teilen oder Kunden und Stakeholder einladen; Gäste stellen eigene Fragen an Ihre Zielgruppe, auch mit kostenlosem Konto, und ihre Nutzung läuft über Ihr Kontingent.
Enthaltene Funktionen
Teilen-Links, Veröffentlichung und ExportEine Studie per Link teilen, ausdrücklich veröffentlichen oder wieder privat schalten und aus demselben Teilen-Menü exportieren; Veröffentlichungen und destruktive Aktionen erfordern immer eine Bestätigung.
Share menu with link sharing and e-mail invitations
Gastfragen auf Ihr KontingentKundinnen, Kunden oder Stakeholder in eine eigene Studie einladen und sie eigene Fragen an die Zielgruppe stellen lassen — auch mit einem kostenlosen Konto. Ihre Fragen laufen über das Antwortkontingent der Eigentümerin oder des Eigentümers, sodass kein Plan-Limit des Gasts die geteilte Studie blockiert. Die Nutzung wird dem eigenen Arbeitsbereich zugeordnet, wobei der Gast als Urheber der eigenen Fragen erhalten bleibt.
Invitation input for a client or stakeholder

Integrationen

Programmierbarer Zugriff und angebundene Workflow-Oberflächen.

FeatureBeschreibung
Verbundene KontenDie Tools verbinden, in denen Ihr Material liegt, und es ohne erneutes Hochladen in eine Studie, eine Zielgruppe oder die Wissensbasis eines Minds holen: Cloud-Speicher, Designdateien, Werbekonten und Produkt-Tickets.
Enthaltene Funktionen
Google Drive und OneDriveDateien aus verbundenen Cloud-Speichern wie Google Drive oder OneDrive im Studieneingabefeld, bei der Zielgruppenerstellung und in der Wissensdatenbank eines Minds anhängen, mit Zugriff nur auf die im Picker ausgewählten Dateien.
Attachment source picker with Google Drive and OneDrive
FigmaSoweit freigeschaltet, einen Figma-Datei- oder Frame-Link in eine Studie einfügen, um das Design als Stimulus zu nutzen.
Meta AdsSoweit für den gebuchten Plan freigeschaltet, ein Meta-Profil in den Einstellungen verbinden, ein autorisiertes Werbekonto auswählen und bestehende Anzeigentexte, Bilder und Videos direkt in eine Studie importieren. Die Integration speichert OAuth-Tokens verschlüsselt, führt ein Import-Audit-Protokoll und fordert nur Lesezugriff an. Minds kann deshalb keine Meta-Anzeigen erstellen, bearbeiten, veröffentlichen, pausieren oder löschen.
Meta Ads connection row
LinearLinear verbinden und ein Epic oder PRD über die Chateingabe anhängen — aus den letzten Issues wählen oder einen Issue-Link einfügen — um Studienforschung dazu durchzuführen. Das Issue wird schreibgeschützt als Markdown-Dokument mit Beschreibung, Metadaten und aktuellen Kommentaren importiert und wie jedes hochgeladene PRD verarbeitet. Mit installiertem @Minds-Workspace-Agenten genügt eine @Minds-Erwähnung im Issue: Der Forschungsplan erscheint im Thread, wird bestätigt und die Studienergebnisse kommen direkt auf das Issue zurück.
Linear connection row
JiraJira verbinden und ein Epic oder PRD über die Chateingabe anhängen — aus den letzten Issues wählen oder einen Issue-Link einfügen — um Studienforschung dazu durchzuführen. Das Issue wird schreibgeschützt als Markdown-Dokument mit Beschreibung, Metadaten und aktuellen Kommentaren importiert und wie jedes hochgeladene PRD verarbeitet.
Jira connection row
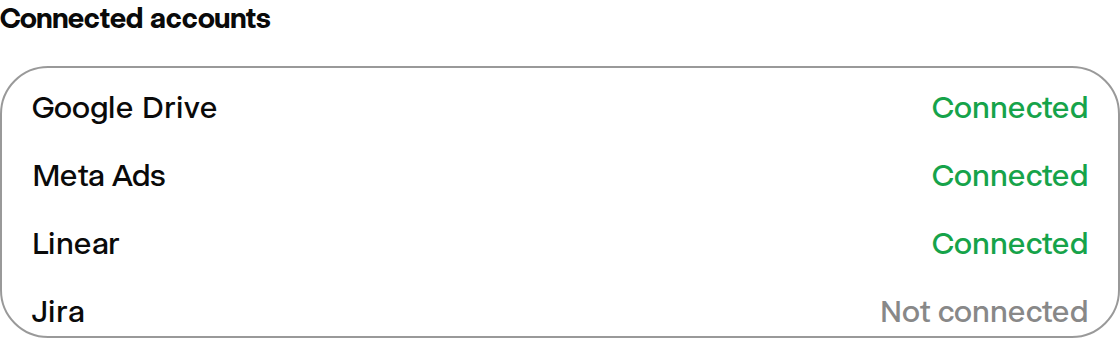
IntegrationsübersichtMinds-Integrationen in einer großen Workspace-Übersicht durchsuchen, erreichbar über die Seitenleiste oder Einstellungen. Die Karten sind nach verbundenen Konten, KI-Assistenten, Daten und Berichten, Website-Werkzeugen und kommenden Integrationen gruppiert. Verfügbare Karten öffnen einen Einrichtungsdialog mit Verbindungsoptionen oder Anleitungen. Bei unterstützten Konten wird der aktuelle Verbindungsstatus angezeigt; der Zugriff hängt von Integration und Tarif ab.
Connected accounts section
MCP-IntegrationKompatible KI-Clients und Agenten über das Model Context Protocol mit Minds-Workflows verbinden, innerhalb derselben Grenzen wie die öffentliche API.
Enthaltene Funktionen
Minds, Zielgruppen und Studien über MCPZentrale Lebenszyklusaktionen für Minds, Wissen, Zielgruppen, Formationen, Studien, Chats und Studienentwürfe verwenden dieselben Anwendungsgrenzen wie die öffentliche API. Bestehende Studien lassen sich exportieren, ausdrücklich per Link veröffentlichen oder wieder privat schalten und mit eingeladenen Mitwirkenden teilen; Veröffentlichungs- und destruktive Aktionen behalten ihre Bestätigungs- und Risikokennzeichnung, während das Erstellen und Rotieren von API-Zugangsdaten in den authentifizierten Kontoeinstellungen verbleibt.
Dauerhafte StudienläufeStudienfragen liefern eine dauerhafte Run-ID, statt von einem einzelnen MCP-Prozess oder offenen Stream abzuhängen; der Status wird über erneute Verbindungen, Neustarts und horizontal skalierte MCP-Instanzen hinweg aus dem gemeinsamen datenbankgestützten Ledger gelesen.
Plan-Widgets in MCP-HostsPlan-Widgets auf dem Desktop haben sechs Schritte: Ziel, Kontext, Zielgruppen, Methode, Fragen und Prüfung. Du kannst das Ziel, eingefügtes Befragungsmaterial sowie unterstützte Fragen, Optionen, Skalen, Reihenfolge und Materialzuordnungen bearbeiten. Speichern erstellt ohne KI-Neugenerierung eine neue Entwurfsversion; die Studie startet erst nach separater Bestätigung dieser gespeicherten Version im Chat. Das Widget bietet bei ungespeicherten Änderungen Speichern und prüfen, aber keine Schaltfläche zum Starten der Studie. Methodenspezifische Fragebatterien und Änderungen an bestehenden Studienzielgruppen werden im Studienbereich bearbeitet. Mobil öffnet sich der Studienbereich; nach dem Start führt ein Link zu Fortschritt und Ergebnissen.
Plan widget on the Method step with Save and review
Browser-Erweiterungen und WidgetsUnterstützte Browser-Erweiterungen und MCP-Widgets nutzen, um Minds in externe Workflows oder kundenseitige Oberflächen einzubinden. Erstellungs-, Status-, Zielgruppen- und Antwort-Widgets erhalten autorisierte Zustände über den MCP-Host, zeigen ihre Oberfläche in allen neun unterstützten Sprachen, verwenden während der Verarbeitung einen zentrierten Minds-Loader und laden freigegebene Mind-Porträts über kurzlebige signierte Bild-URLs, ohne App-Zugangsdaten im Iframe offenzulegen.
API-ZugriffDie öffentliche API für unterstützte programmatische Minds-, Zielgruppen-, Studien- und Export-Workflows sowie Studien-Freigabelinks und Einladungen von Studien-Mitwirkenden nutzen. Das Aktivieren eines Studien-Links ist eine ausdrückliche Veröffentlichungsaktion und macht auch die angehängten Zielgruppen und Minds zugänglich; Einladungsantworten enthalten keine Einladungstokens. Einzelne Minds und Studien können ausschließlich auf verarbeitetes Mind-Wissen beschränkt werden: Live- und Anfragequellen werden deaktiviert, eine leere Suche bricht kontrolliert ab und Dateinamen bleiben nachvollziehbar, ohne private Inhalte offenzulegen. Wissens-Uploads zeigen ihren Verarbeitungsstatus je Eintrag und können den Mind-Prompt erst nach erfolgreicher Verarbeitung neu erzeugen. Dauerhafte Studienläufe werden transaktional angenommen und liefern sofort eine Run-ID; Clients können den verbindlichen Status abrufen, geordnete Lebenszyklusereignisse erneut laden, Arbeit abbrechen und denselben Idempotenzschlüssel ohne doppelte Ausführung wiederholen.
Minds für n8nn8n-nodes-minds auf einer selbst gehosteten n8n-Instanz installieren und einen Minds-API-Schlüssel hinterlegen. Version 0.1.0 bietet Study Create, Get, Get Many, Preview Research Plan und Get Summary, auch als Tool für einen KI-Agenten. Die Vorschau speichert einen Planentwurf; die Forschung wird separat in Minds geprüft und gestartet. Das Paket ist auf npm veröffentlicht; die n8n-Verifizierung läuft noch und eine Installation in n8n Cloud ist noch nicht verfügbar.
Minds für Google SheetsEin Google Sheet als Recherche-Warteschlange nutzen. Wähle Zeilen aus, deren erste Spalte Fragen enthält, wähle eine bestehende Zielgruppe, bestätige den Lauf – und jede Antwort wird in die nächste Spalte geschrieben. Leere Zeilen behalten ihre Position, das Add-on warnt vor dem Überschreiben vorhandener Ausgabezellen und sendet pro Lauf bis zu 25 Fragen über denselben Minds-MCP-Endpunkt wie die übrigen unterstützten Integrationen.
Studienanalysen für Looker StudioEin bestehende Studie als wiederverwendbare Datenquelle mit Looker Studio verbinden – für Reports, wiederkehrende Reviews und geteilte Dashboards. Der Connector authentifiziert sich per API-Key, liest die Live-Analytics zur eingegebenen Studien-ID und verändert die Studie nie.
Individuelle IntegrationenKundenspezifische Integrationen für Enterprise-Workflows, interne Systeme oder Analytics-Stacks definieren.

Sicherheit und Enterprise-Kontrollen

Kontrollen, die typischerweise für größere Teams und beschaffungsgetriebene Einführungen konfiguriert werden.

FeatureBeschreibung
Single Sign-OnKundenseitig verwaltete SAML-2.0-Anmeldung über Supabase Auth konfigurieren, einschließlich Microsoft Entra ID und Okta, mit providergebundenem Team-Auto-Join, Sitzplatzprüfung und Legacy-Account-Preflight; MFA und Conditional Access bleiben beim Identity Provider.
Modellverbindungen für TeamsWenn für einen Pro-Arbeitsbereich aktiviert, können Admins verschlüsselte Zugangsdaten für öffentliche HTTPS-Endpunkte mit OpenAI Chat, OpenAI Responses oder Anthropic Messages hinterlegen. Vor der ausdrücklichen Auswahl für Mind- oder Studienanfragen werden die Fähigkeiten geprüft. Wartende Aufgaben behalten die gewählte Revision; nicht verfügbare Verbindungen führen zu einem Fehler ohne Modellwechsel. Unterstützende Analysen nutzen weiterhin Minds-Modelle; Anbietergebühren fallen separat an. Visuelle Eingaben werden in dieser Version nicht unterstützt.
Enterprise-SLAService Levels, Support-Reaktionszeiten und Servicegutschriften für Enterprise-Einführungen vereinbaren, soweit anwendbar.

Services und Support

Support, Einführung, Validierung und kundenspezifische Leistungen.

FeatureBeschreibung
Abonnement-AbrechnungNeue Kunden wählen vor dem Checkout ihr Rechnungsland. Bestehende Abonnenten behalten ihre Abrechnungsvereinbarungen und vereinbarten Preise. Team-Owner und Admins verwalten dasselbe Pro-Abonnement.
Validierungs- und KalibrierungsleistungenGesondert definierte Validierungs-, Onboarding-, Kalibrierungs- oder Research-Support-Leistungen anhand geeigneter interner oder externer Referenzdaten durchführen.
Individuelle synthetische PopulationenKundenspezifische oder branchenspezifische synthetische Populationen aus Kundeninputs, Partner-Research und geeigneten öffentlichen Quellen erstellen.
Prioritäts-SupportPriorisierten Support für bezahlte Pläne und Kundenarbeitsbereiche erhalten.
Community-SupportStandardmäßige Self-Serve- und Community-orientierte Support-Ressourcen nutzen.