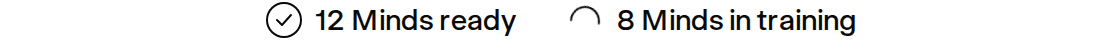·Minds Team

Catalogue des fonctionnalités

Catégories de fonctionnalités Minds et descriptions orientées client.

Cette page présente les principales catégories de fonctionnalités Minds et les descriptions orientées client utilisées comme référence dans le produit, les prix et les contrats. Les accords propres à chaque client peuvent définir séparément les limites du plan, les volumes d'utilisation, le périmètre de services ou la configuration enterprise.

Catégories de fonctionnalités

Modélisation d'audience

Objets fondamentaux pour créer des Minds et des Audiences réutilisables.

FonctionnalitéDescription
MindsCréez des personas IA à partir de descriptions, de profils, de liens, de fichiers ou de notes de recherche. Tout ce que vous fournissez reste dans la base de connaissances propre au Mind, et l'enrichissement web peut être désactivé.
Capacités incluses
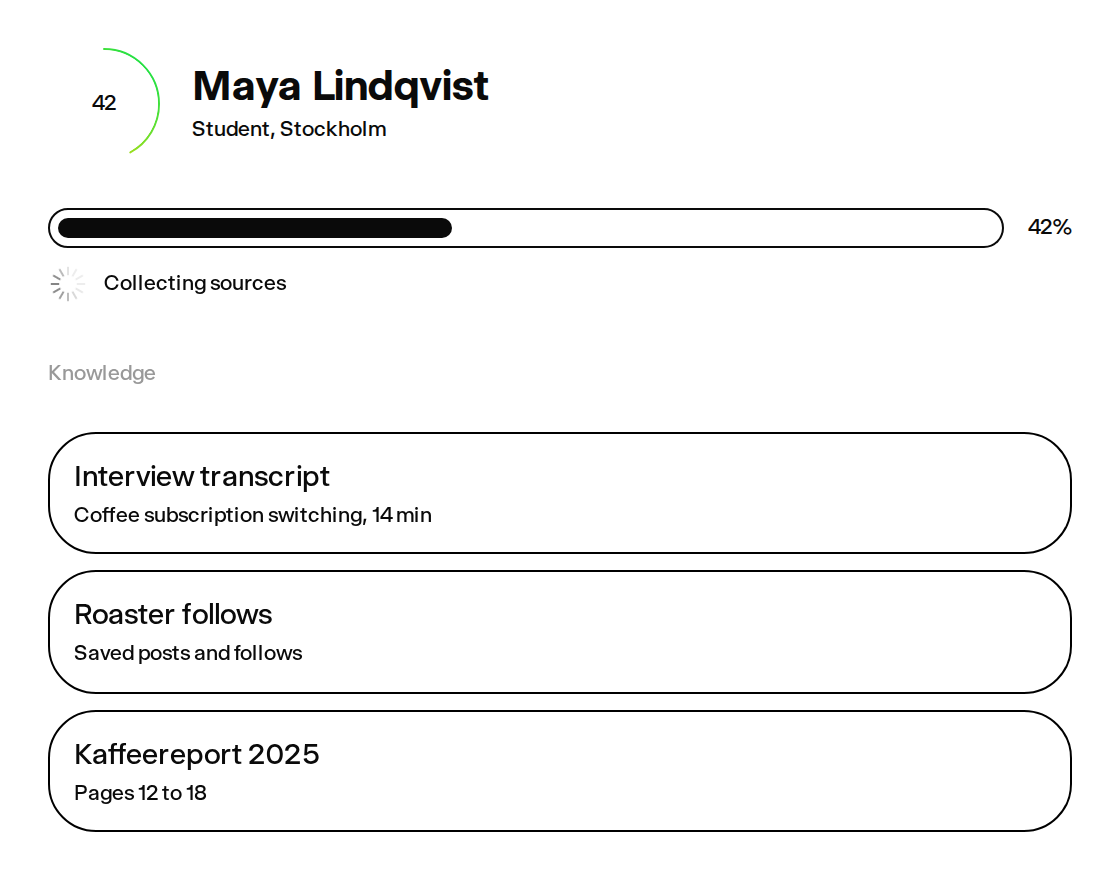
Création guidéeLorsque Nouveau Mind est sélectionné, une passe de profil dédiée détermine si la demande désigne une personne réelle et produit ensemble la description initiale et les requêtes de collecte, sans lancer la génération d'une liste de membres d'Audience. Un Mind est créé via le même panneau guidé qu'une Audience, avec les mêmes étapes et le même compositeur, et accepte le même matériel : fichiers téléversés, fichiers issus d'un stockage cloud connecté, liens et sources par mots-clés.
Mind creation progress: sources collected, knowledge items read, personality being shaped
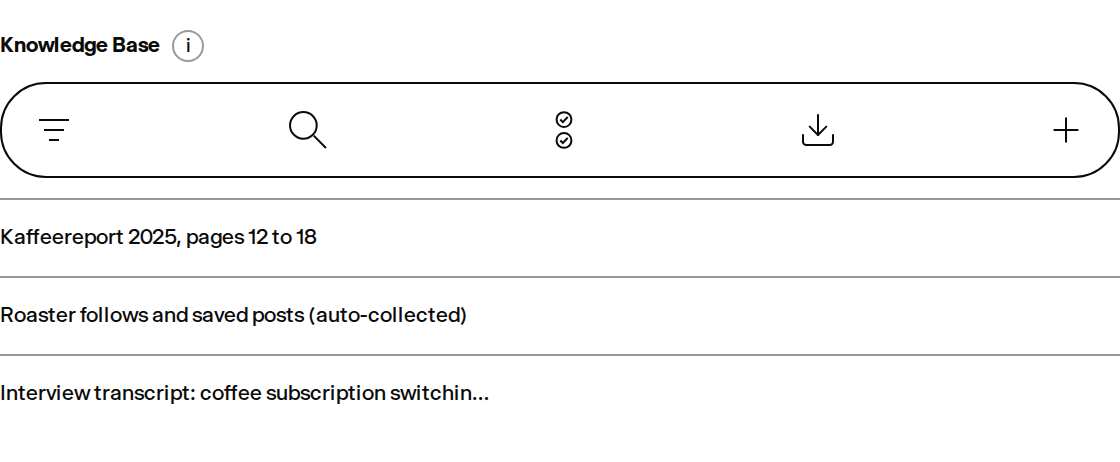
Base de connaissances propreTout ce qui est fourni à la création est conservé dans la base de connaissances propre à ce Mind, afin de pouvoir être cité lors d'échanges ultérieurs et pas seulement dans la conversation où il a été créé. L'enrichissement web peut être désactivé : dans ce cas, le Mind est construit uniquement à partir du matériel que vous avez fourni.
Knowledge base section of a Mind with its uploaded and auto-collected items
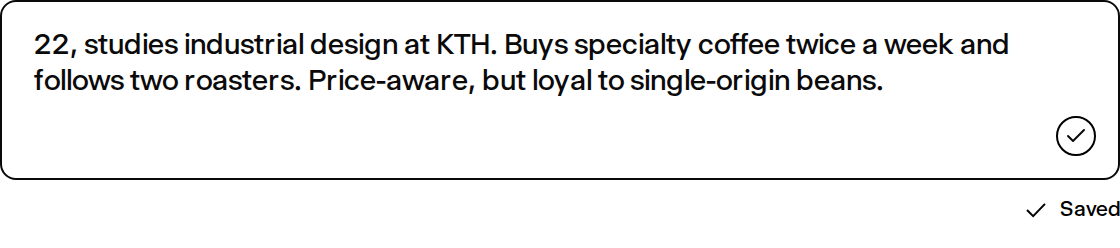
Descriptions modifiablesLes propriétaires et les collaborateurs de l'espace de travail peuvent modifier la description d'un Mind directement depuis son profil, avec le même retour d'enregistrement automatique en ligne que pour les descriptions d'Audience ; les visiteurs en démo, via lien partagé ou en accès public restent en lecture seule.
Inline description editor with auto-save status
Langue et ancrage PRISMUn Mind est généré dans la langue d'interface dans laquelle il a été créé : le profil de persona qui sous-tend la description est rédigé dans cette langue, et les passes d'enrichissement ultérieures la conservent au lieu de revenir à l'anglais. La modélisation de sources Minds PRISM ajoute du contexte issu de sources publiques et peut intégrer des données de recherche autorisées là où cela est activé, afin que les Minds puissent être réutilisés dans différents flux de recherche.
PRISM thinking model of a Mind
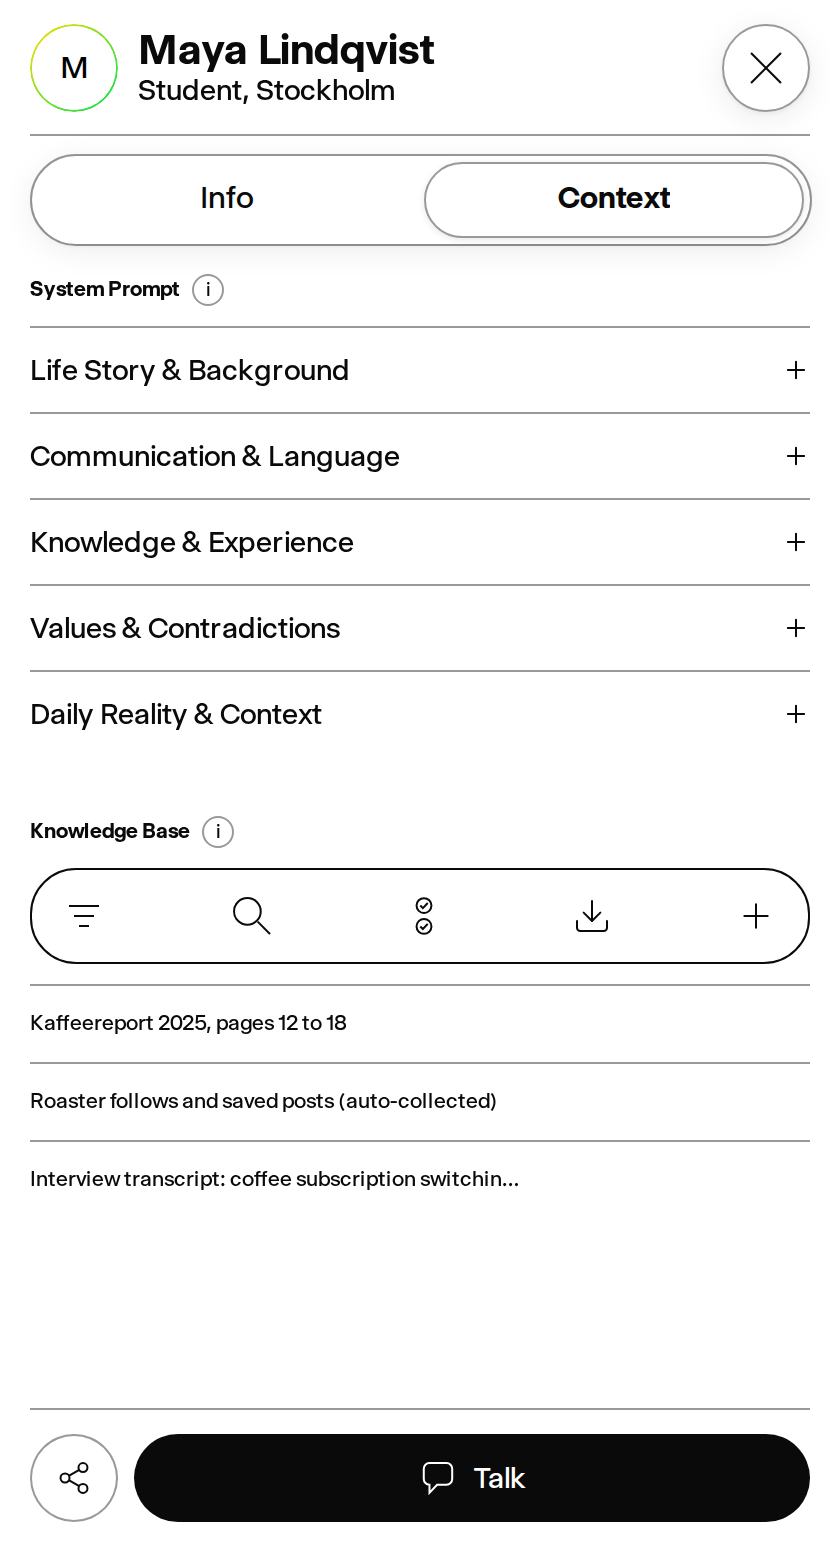
Contexte de profilLes profils de Mind consultés en étant connecté peuvent afficher un contexte biographique approuvé à côté de la description du persona, afin que les équipes examinent les éléments de contexte pertinents sans exposer les notes de calibration internes. Les réponses publiques d'un Mind, des pages d'atterrissage et des partages omettent les prompts système ainsi que les métadonnées internes de calibration ou de source.
Context tab of a Mind profile with the personality sections
Création d'AudiencesConstruisez des Audiences synthétiques réutilisables à partir de Minds existants, d'une description et de fichiers ou liens joints. Les distributions s'appuient sur des sources publiques et sur vos propres recherches, sont examinées avant la création, puis converties en quotas exacts.
Capacités incluses
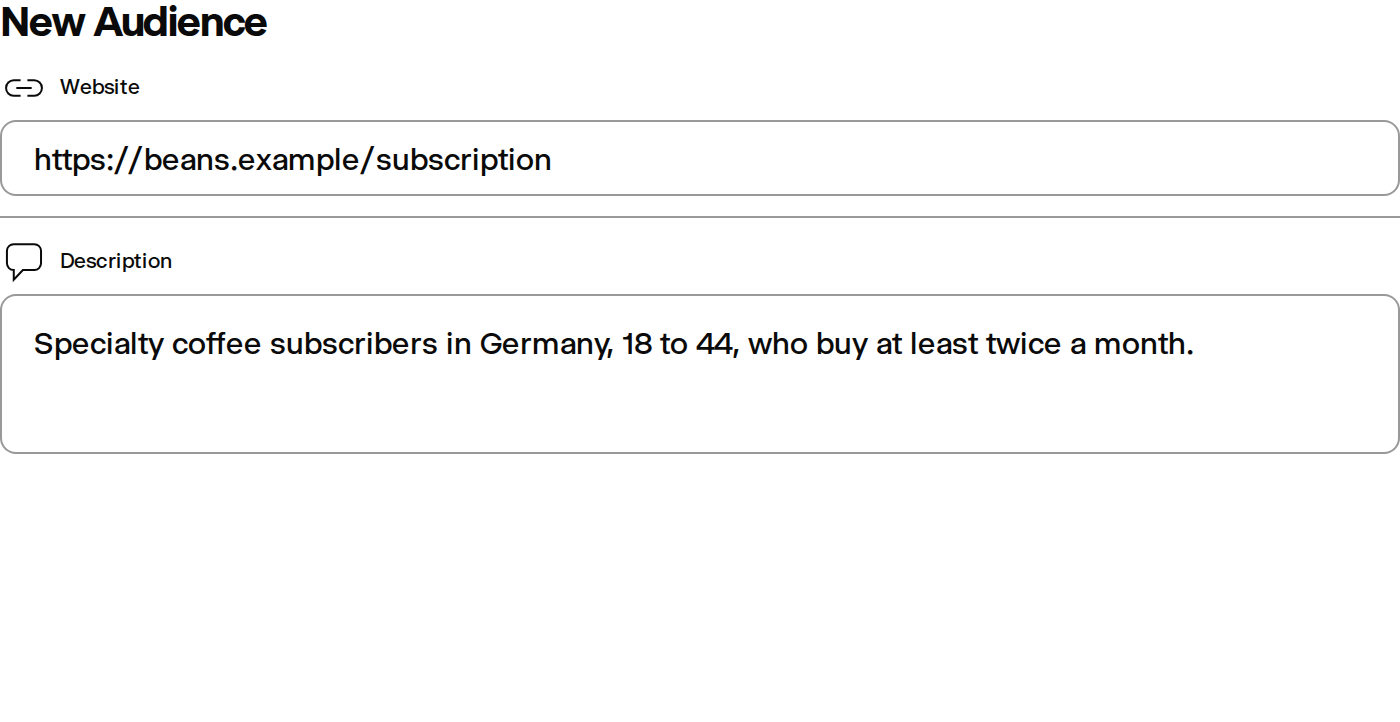
Panneau de création, API et MCPLes clients API et MCP peuvent importer les fichiers de recherche UTF-8 fournis dans un stockage durable appartenant au compte et prévisualiser des distributions complètes examinées par l'appelant, sans recherche web. Une création d'Audience lancée via V1 ou MCP est persistée dans le même cycle de vie AudienceDraft que l'application web et diffuse les mêmes statuts Drafting (rédaction), Creating (création) et Ready (prêt) dans chaque espace de travail ouvert. L'écran de création initial conserve un compositeur de description compact ancré sous le contexte facultatif et utilise la touche Entrée pour continuer, sans action distincte en pied de page.
New Audience panel with website and description fields
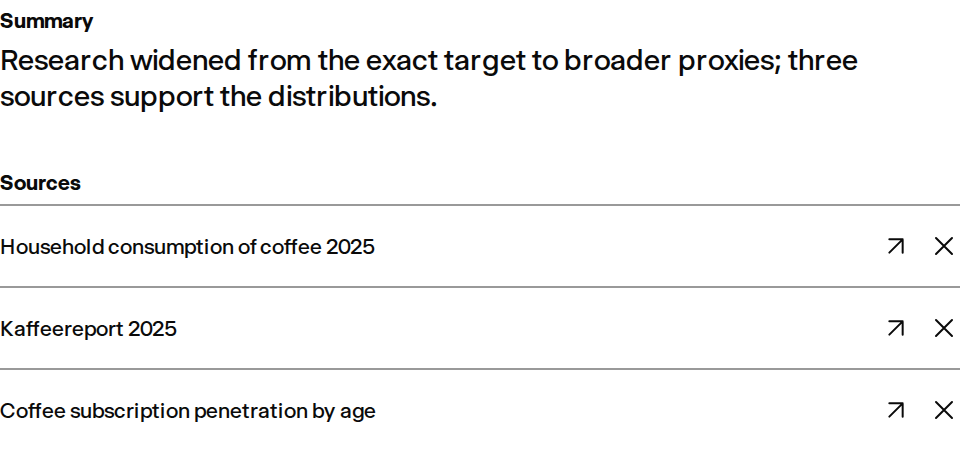
Recherche de sources par paliersLa recherche par paliers s'étend de la cible exacte à des approximations plus larges, générales puis mondiales, afin de trouver toutes les distributions défendables et ancrées dans des sources que les preuves étayent, sans plafond fixe de graphiques. La recherche relance les échecs de recherche transitoires et élargit ses requêtes lorsqu'une passe renvoie trop peu de sources pour étayer une distribution défendable : une panne temporaire d'un fournisseur est donc signalée comme une recherche indisponible et à réessayer, et non comme une audience dépourvue de preuves. L'extraction progressive à sources diversifiées lit chaque source sélectionnée et renvoie le meilleur ensemble validé dans le budget de la requête.
Source research with the verified sources behind the distributions
Questionnaires de sélection, rapports et données de répondants téléversésLes recherches téléversées sont classées selon leur statut de preuve : les questionnaires de sélection et les questionnaires non administrés définissent les options candidates, les exclusions d'éligibilité et les quotas cibles explicites, tandis que les rapports finalisés et les jeux de données de répondants peuvent fournir des distributions observées. Les options exclues par la source et les options conditionnelles non résolues restent visibles en revue avec leur motif et ne deviennent jamais des entrées d'allocation ; les axes de répondants correspondants héritent des règles du questionnaire de sélection. Une variable de sélection que la source mentionne sans aucune part cible ni observée est complétée par une distribution proposée afin que l'Audience puisse tout de même varier sur cet axe : ces pourcentages portent la mention Distribution supposée (Assumed distribution), ne sont jamais attribués au fichier téléversé, ne diluent jamais un quota déclaré et ne réintroduisent jamais une option écartée. Les variables à réponses multiples conservent des incidences par option pouvant dépasser 100 % au lieu d'être forcées à partitionner la base, et la complétion d'un instrument est indépendante de sa lecture : même après une extraction dégradée, chaque variable sans quota reçoit une distribution proposée au lieu de rester consultable uniquement en revue.
Drop zone for screeners, reports and respondent data
Votre brief comme spécificationLe prompt de création compte lui-même comme une spécification de première main : un questionnaire de sélection collé, des quotas déclarés ou une consigne de segmenter ou non sur une variable produisent les mêmes distributions examinées qu'un téléversement, que la recherche web ait trouvé ou non des données à ce sujet de façon indépendante. Les briefs rédigés en prose donnent des segmentations correctement nommées plutôt que des fragments.
Creation composer with a pasted screener brief
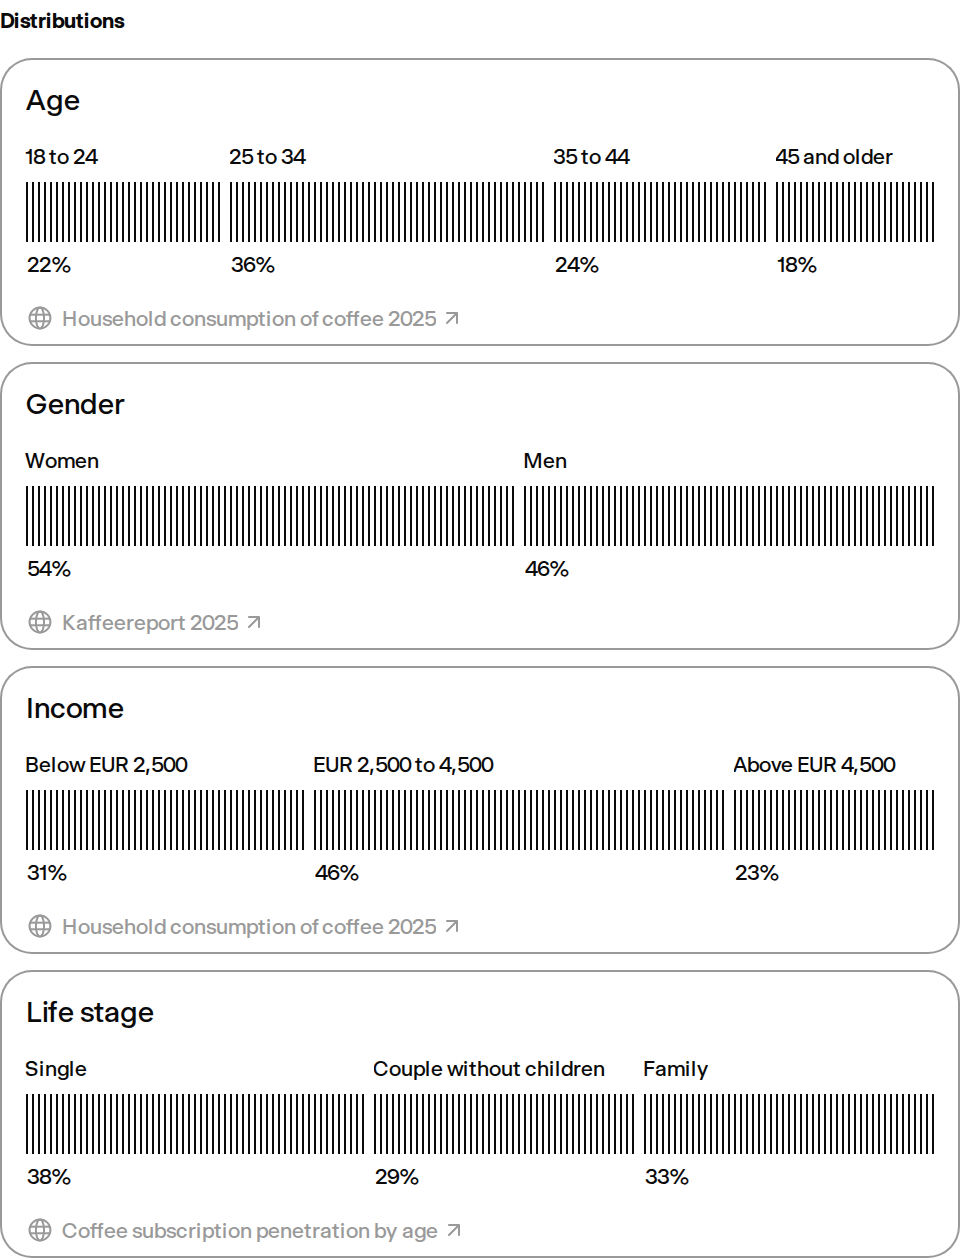
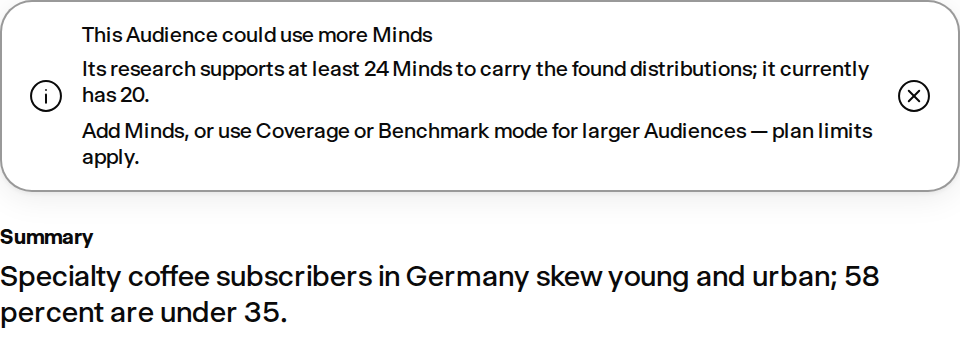
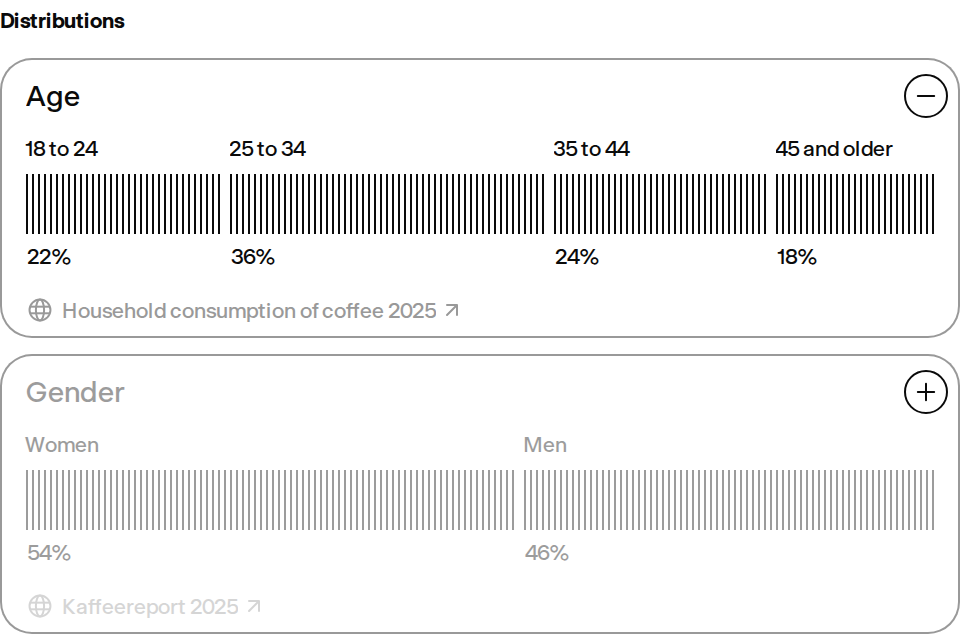
Segmentations démographiques intégréesLes segmentations intégrées Âge, Genre, Revenu et Étape de vie sont proposées uniquement là où les Minds de l'Audience disposent de preuves les étayant, au lieu d'apparaître comme des segmentations en échec, et les segmentations ancrées affectent chaque Mind à partir de son profil de cohorte persisté plutôt qu'en relisant sa description. Une segmentation Représentation intégrée utilise le même vocabulaire canonique que l'outil d'appariement des portraits, de sorte que les axes sur lesquels une Audience est construite et ceux selon lesquels elle peut être filtrée concordent ; des distributions ancrées d'Ethnicité, d'Origine ou d'Héritage la remplacent au lieu d'ajouter une seconde segmentation pour le même axe. Les dimensions intégrées sont reconnues à partir de la façon dont une source nomme réellement une distribution, et pas uniquement par correspondance exacte : des intitulés qualifiés comme Race and Ethnicity ou Ethnic Group (catégories du recensement 2021) se rattachent à la même segmentation, et les distributions nommées dans la langue du demandeur sont elles aussi reconnues ; une distribution qui se contente de ventiler une autre métrique par un critère démographique reste une segmentation propre à ce groupe.
Age, Gender, Income and Life stage distribution cards
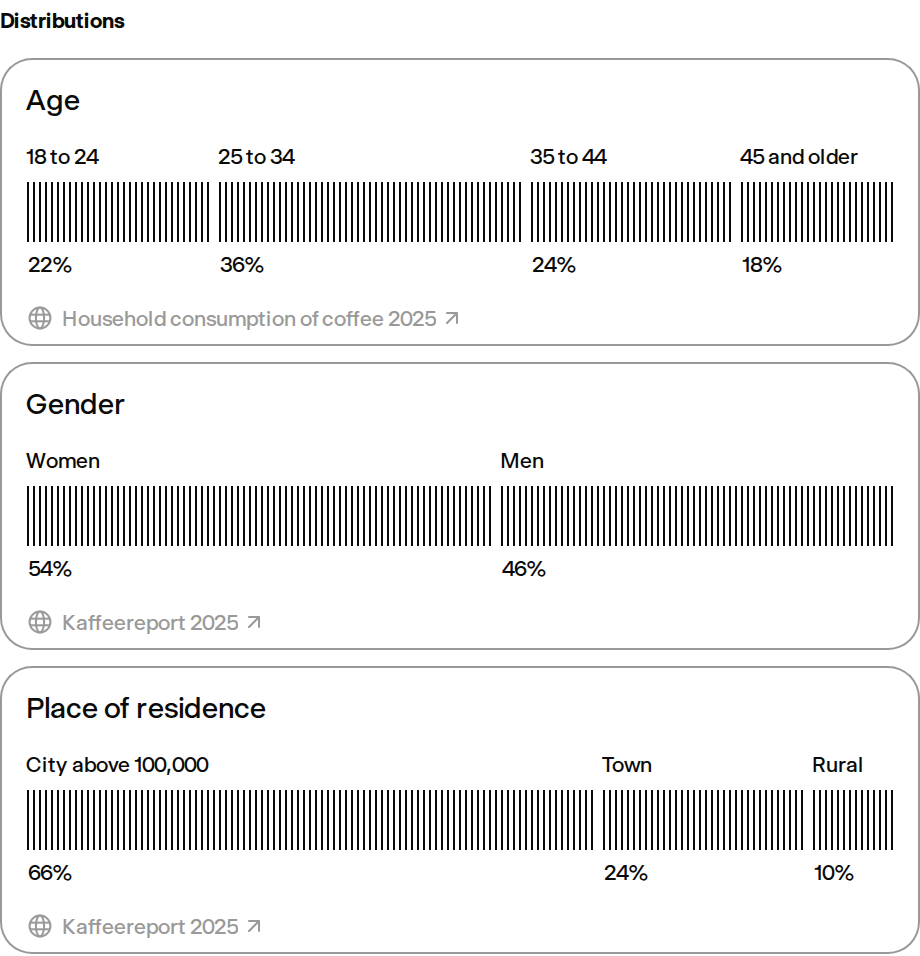
Distributions ancrées comme filtresChaque distribution ancrée sur laquelle l'Audience a réellement été construite devient un filtre après la création, et pas seulement les premières : les distributions dont les segments sont attribués de façon déterministe à partir des profils de cohorte persistés sont toutes exposées, tandis que seules les suggestions générées par le modèle restent soumises au budget propre à chaque mode.
Filter list built from the grounded distributions
Allocation déterministe des quotasLes pourcentages ancrés sont convertis en quotas entiers exacts par un allocateur déterministe initialisé par une graine ; chaque Mind reçoit un profil de cohorte persisté propre à l'Audience, et l'audit cible/réalisé est accessible via l'API. Les preuves limitées aux marges utilisent une reconstruction conjointe explicitement fondée sur l'indépendance, plutôt que d'inventer des corrélations. Les appelants de l'API peuvent ajuster la graine, les dimensions incluses, le plafond de dimensions, le plancher de segments réalisables, la stratégie de loi conjointe, le niveau de détail des réponses et le comportement du contexte de profil ; le même contrat est prêt pour de futurs contrôles dans l'interface. Une distribution est allouée sur la population qu'elle mesure réellement : une distribution qui porte sur un sous-ensemble (par exemple l'origine des étudiants étrangers) est répartie uniquement entre les membres appartenant à ce segment de base et est étiquetée avec le sous-ensemble et sa part, de sorte qu'elle s'applique à ce sous-ensemble et non à l'ensemble de l'Audience. Lorsque le même attribut provient de plusieurs endroits, un quota d'étude prime sur une statistique publique, et une statistique publique prime sur une hypothèse, les hypothèses écartées restant listées comme identifiées.
Grounding summary with the research-driven Audience size note
Revue avant créationExaminez les profils provisoires réels et leur composition allouée, avec les huit groupes fondamentaux visibles : Âge, Genre, Géographie, Situation professionnelle, Profession, Revenu, Éducation et Étape de vie. Demandez des modifications via Rework (retravailler) ; la revue est en lecture seule et Créer utilise l'instantané accepté côté serveur.
Distribution review with one distribution deselected before creation
Jeux de données de répondants comme échantillons de référenceLes effectifs, les valeurs manquantes, les pourcentages et les résultats pondérés d'enquête sont calculés à partir des lignes téléversées. Les caractéristiques de l'étude brute définissent un échantillon de référence, tandis que les réponses fournies restent des résultats historiques. Une nouvelle recherche exclut ces réponses de la génération des personas et de la récupération d'informations ; une reconstruction explicitement demandée peut utiliser des agrégats historiques et est signalée dans la même revue. Les quotas demandés priment sur les parts observées, les deux observations étant conservées. Les champs manquants, non posés et inconnus restent distincts ; les dimensions non collectées portent la mention modélisée ou inconnue. La composition utilise actuellement des effectifs d'échantillon non pondérés et les relations observées, les observations pondérées étant conservées séparément lorsqu'une colonne de pondération d'enquête valide est fournie. Un échantillon client téléversé n'est jamais présenté en silence comme une population nationale.
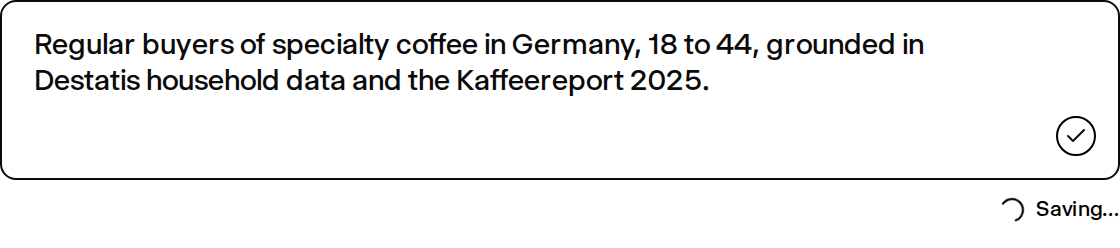
Descriptions modifiables et composition préservéeLa composition et les affectations de cohorte des Audiences déjà enregistrées sont préservées ; la provenance est une métadonnée additive. Modifiez les descriptions d'Audience contrôlées par le propriétaire tout en gardant les descriptions du Marketplace synchronisées.
Audience description editor while saving
Appariement des portraitsLà où cette option est activée, les Minds en brouillon reçoivent des portraits de première main libres de droits issus des Audiences publiques du Marketplace. Les Minds publics existants apportent des métadonnées de présentation visuelle stockées ; l'âge et la représentation déclarée affinent l'appariement lorsqu'ils sont disponibles, et le modèle de rédaction rattache chaque nationalité ou région demandée à des catégories de représentation canoniques, afin que les étiquettes de persona et les libellés du catalogue partagent un seul vocabulaire. Chaque persona généré porte un profil visuel explicite, et les biographies suivent les profils de cohorte déjà alloués sans modifier les quotas. La présentation visuelle est la seule contrainte stricte : un portrait ne contredit jamais un genre déclaré, tandis que l'âge et la représentation sont traités comme des préférences appliquées au mieux, et les portraits sans étiquette de représentation restent utilisables comme correspondances neutres au lieu d'être rejetés. Chaque Mind synthétique reçoit ainsi un portrait cohérent avec son genre ; l'outil d'appariement privilégie l'âge et la représentation exacts et réutilise des portraits compatibles lorsqu'une catégorie démographique étroite compte moins de visuels distincts que l'Audience. Les initiales stables sont réservées aux cas délibérés : une personne réelle nommée, un Mind sans présentation déclarée ou un emplacement de cohorte qui contredit sa propre identité, jamais un simple écart démographique. Le vivier de portraits est constitué de tous les Minds possédant un portrait de première main libre de droits, et pas uniquement des Audiences publiques du Marketplace, les Minds clonés à partir de personnalités publiques nommées étant exclus de toute réutilisation anonyme ; il est complété par des portraits de couverture générés couvrant des archétypes vestimentaires, affaires, décontracté, créatif, métiers manuels, éducation et soins, afin qu'une cellule démographique offre une variété visible plutôt qu'un même visage répété.
Progression de création en directLa création à corpus partagé réutilise les sources initiales lors de la phase 1 et marque chaque Mind comme prêt dès que sa personnalité est construite ; l'analyse approfondie individuelle facultative se poursuit en arrière-plan sans bloquer l'achèvement. Pendant la construction, une couche de traitement en direct compacte affiche l'étape en cours au niveau de l'Audience ainsi qu'un statut d'entraînement en temps réel pour chaque Mind.
Readiness status: Minds ready and Minds in training
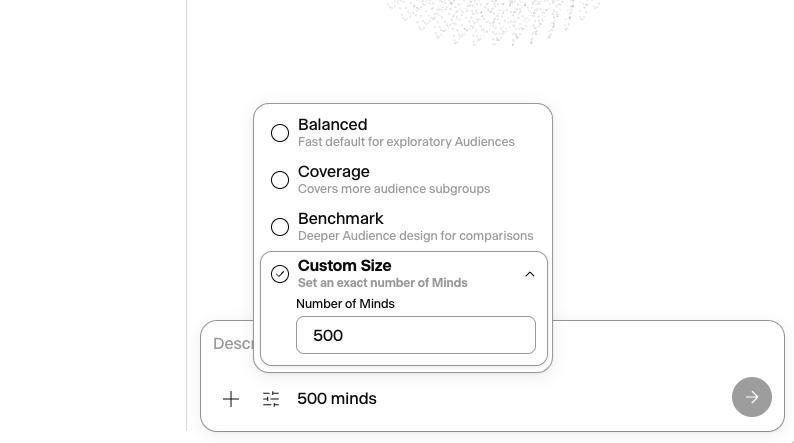
Modes de création : Équilibré (Balanced), Couverture des segments (Segment Coverage), Profondeur Benchmark (Benchmark Depth), Taille personnalisée (Custom Size)Le panneau de création utilise Équilibré (Balanced) par défaut et propose également Couverture des segments (Segment Coverage), Profondeur Benchmark (Benchmark Depth) et Taille personnalisée (Custom Size). Taille personnalisée fixe le nombre exact de Minds au lieu de laisser un mode dimensionner l'Audience à partir de la capacité : le mode de conception est choisi automatiquement pour correspondre à la taille demandée, et le nombre est borné par l'allocation par Audience du forfait, y compris un plafond Enterprise négocié. Les appelants API et MCP fixent le même nombre avec un memberCount explicite, qui prévaut sur tout effectif indiqué dans le brief et qui est rejeté avec l'écran de mise à niveau plutôt que réduit en silence. Équilibré dimensionne chaque Audience à partir de ses propres preuves, assez de Minds pour donner au plus petit segment étayé son propre représentant, de 10 à 20, de sorte qu'une audience étroite reste petite au lieu d'occuper une part fixe de l'allocation du forfait, et un forfait plus généreux ne gonfle jamais une Audience Équilibré. Lorsque les preuves sont plus fines que ce que 20 Minds peuvent représenter, Équilibré construit son Audience la plus détaillée au lieu d'abandonner les segments rares, qui restent visibles dans les distributions et gardent leur place dans l'allocation. Couverture des segments, réservé au forfait Pro, donne deux représentants à chaque cellule d'audience ancrée limitante, depuis un plancher de preuves de 10 Minds jusqu'au plafond de 50 Minds du mode, au lieu d'occuper une part fixe de la capacité. Profondeur Benchmark, réservé au forfait Pro, donne cinq représentants à chaque cellule d'audience ancrée limitante pour une profondeur permettant la comparaison, depuis un plancher de preuves de 15 Minds, et n'utilise l'allocation payante que comme plafond. Ce plafond est de 200 Minds sur le forfait Pro standard, avec une capacité Enterprise négociée pouvant aller jusqu'au plafond système de 1 000 Minds. Les effectifs explicites en Taille personnalisée peuvent utiliser la totalité de l'allocation payante ; les effectifs supérieurs ouvrent l'écran de mise à niveau.
Creation panel with the Balanced, Coverage, Benchmark and Custom Size modes, Custom Size set to 500 Minds
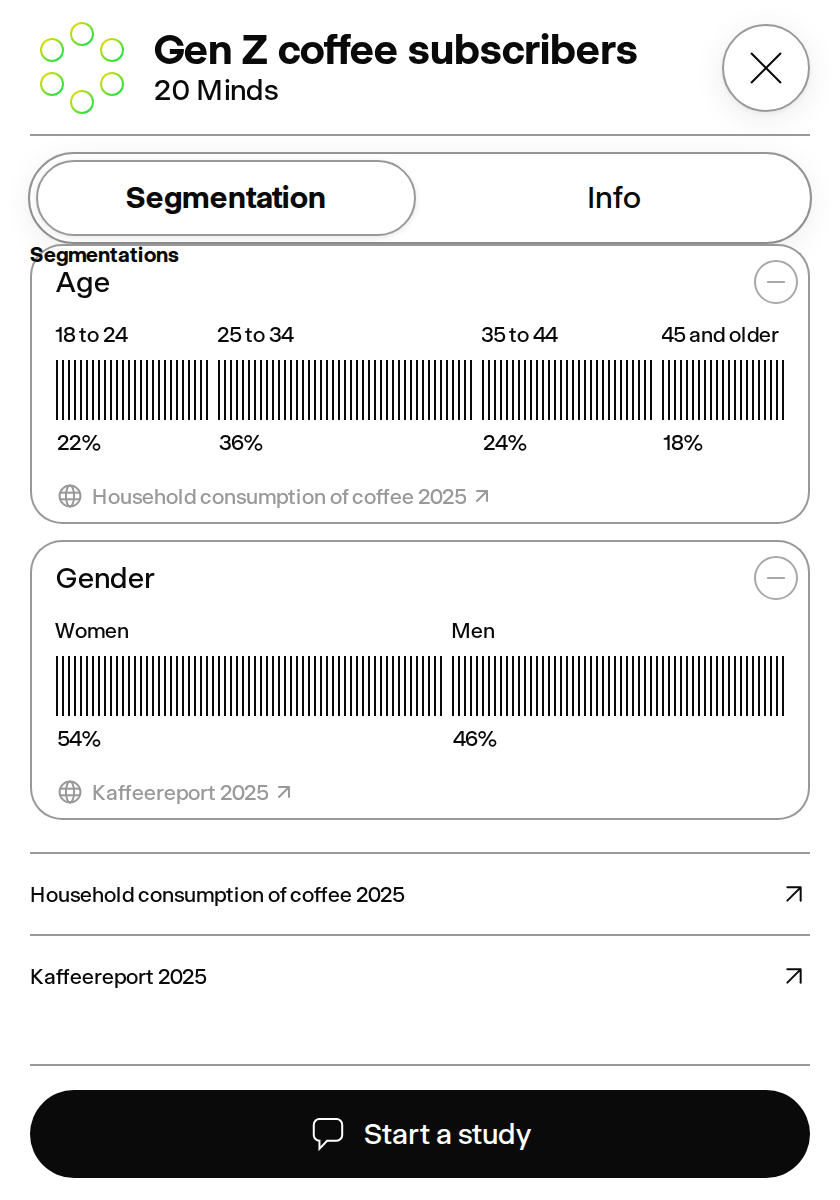
Onglets Segmentation et InfosAprès la création, l'Audience s'ouvre sur un onglet Segmentation qui reprend la revue du brouillon avec son orbite de personas et une carte encadrée par distribution, à l'aide de barres de parts horizontales portant chaque libellé et chaque pourcentage. L'onglet Infos suit avec la description dépliable, la liste complète des Minds et une archive de sources en bas de page, tandis que les modifications de composition se demandent via Rework (retravailler). Les statistiques portant sur une population plus large et les statistiques conditionnelles inverses restent visibles à leurs pourcentages publiés, en contexte complémentaire. Les valeurs situées hors de la définition de l'Audience restent consultables comme résultats de source, avec leur motif d'exclusion ; modifier l'éligibilité passe par Rework.
Audience panel on the Segmentation tab
Brouillons durablesLes brouillons d'Audience sont enregistrés avant acceptation, continuent de s'exécuter en arrière-plan et peuvent être repris à tout moment depuis la liste des Audiences.
Audience draft row in the list while drafting
Audiences à partir de profils sociauxCréez une audience à partir d'un compte public Instagram, YouTube ou LinkedIn en collant l'URL de son profil. Minds lit le compte et modélise l'audience qui le suit — ses données démographiques, intérêts et motivations — afin que vous puissiez étudier les personnes qui suivent un concurrent, un créateur ou une entreprise sans cloner le compte lui-même.
Revue de segmentation des jeux de donnéesAnalysez des données de répondants XLS, XLSX ou CSV champ par champ, mettez les résultats de côté pour les tests et générez une cohorte Benchmark représentative pouvant aller jusqu'à 1 000 Minds.
Capacités incluses
Classification des champsAnalysez structurellement chaque ligne de données de répondants XLS, XLSX et CSV et classez chaque champ comme définition de population, variable de segmentation, résultat d'étude, facteur de décision, question ouverte, pondération, identifiant ou métadonnée, ou statistique dérivée. Les variables de population et de segmentation façonnent la cohorte par défaut ; les résultats et les facteurs restent mis de côté pour les tests au lieu d'être intégrés à l'Audience. Examinez la distribution de la population pour chaque variable dans une étape dédiée après l'analyse.
Relations respectueuses de la confidentialitéPour des données de répondants complètes, les relations par paires respectueuses de la confidentialité sont mesurées de façon déterministe et séparées en dépendances structurelles d'un côté et preuves mises de côté de l'autre. La stratégie d'allocation observée préserve exactement les marges sélectionnées tout en reproduisant les dépendances structurelles compatibles les plus fortes via un arbre de dépendances déterministe ; les petites cellules sont supprimées et les lignes de répondants ou les profils conjoints uniques ne sont jamais convertis un pour un en Minds.
Génération de cohorte BenchmarkRetirez les variables non pertinentes, puis générez une cohorte Benchmark large et représentative dont les attributs agrégés préservent chaque distribution sélectionnée. Là où cette option est activée, une sélection examinée peut inclure jusqu'à 200 variables et la génération s'adapte à l'allocation d'Audience configurée pour l'espace de travail, jusqu'au plafond système de 1 000 Minds. Un ensemble borné d'archétypes de départ larges est développé en profils distincts, attribués de façon déterministe. Les Minds ancrés dans le tableur sont prêts à partir de leurs profils attribués pendant que les portraits se génèrent en arrière-plan.
Progress bar of a Benchmark cohort generation
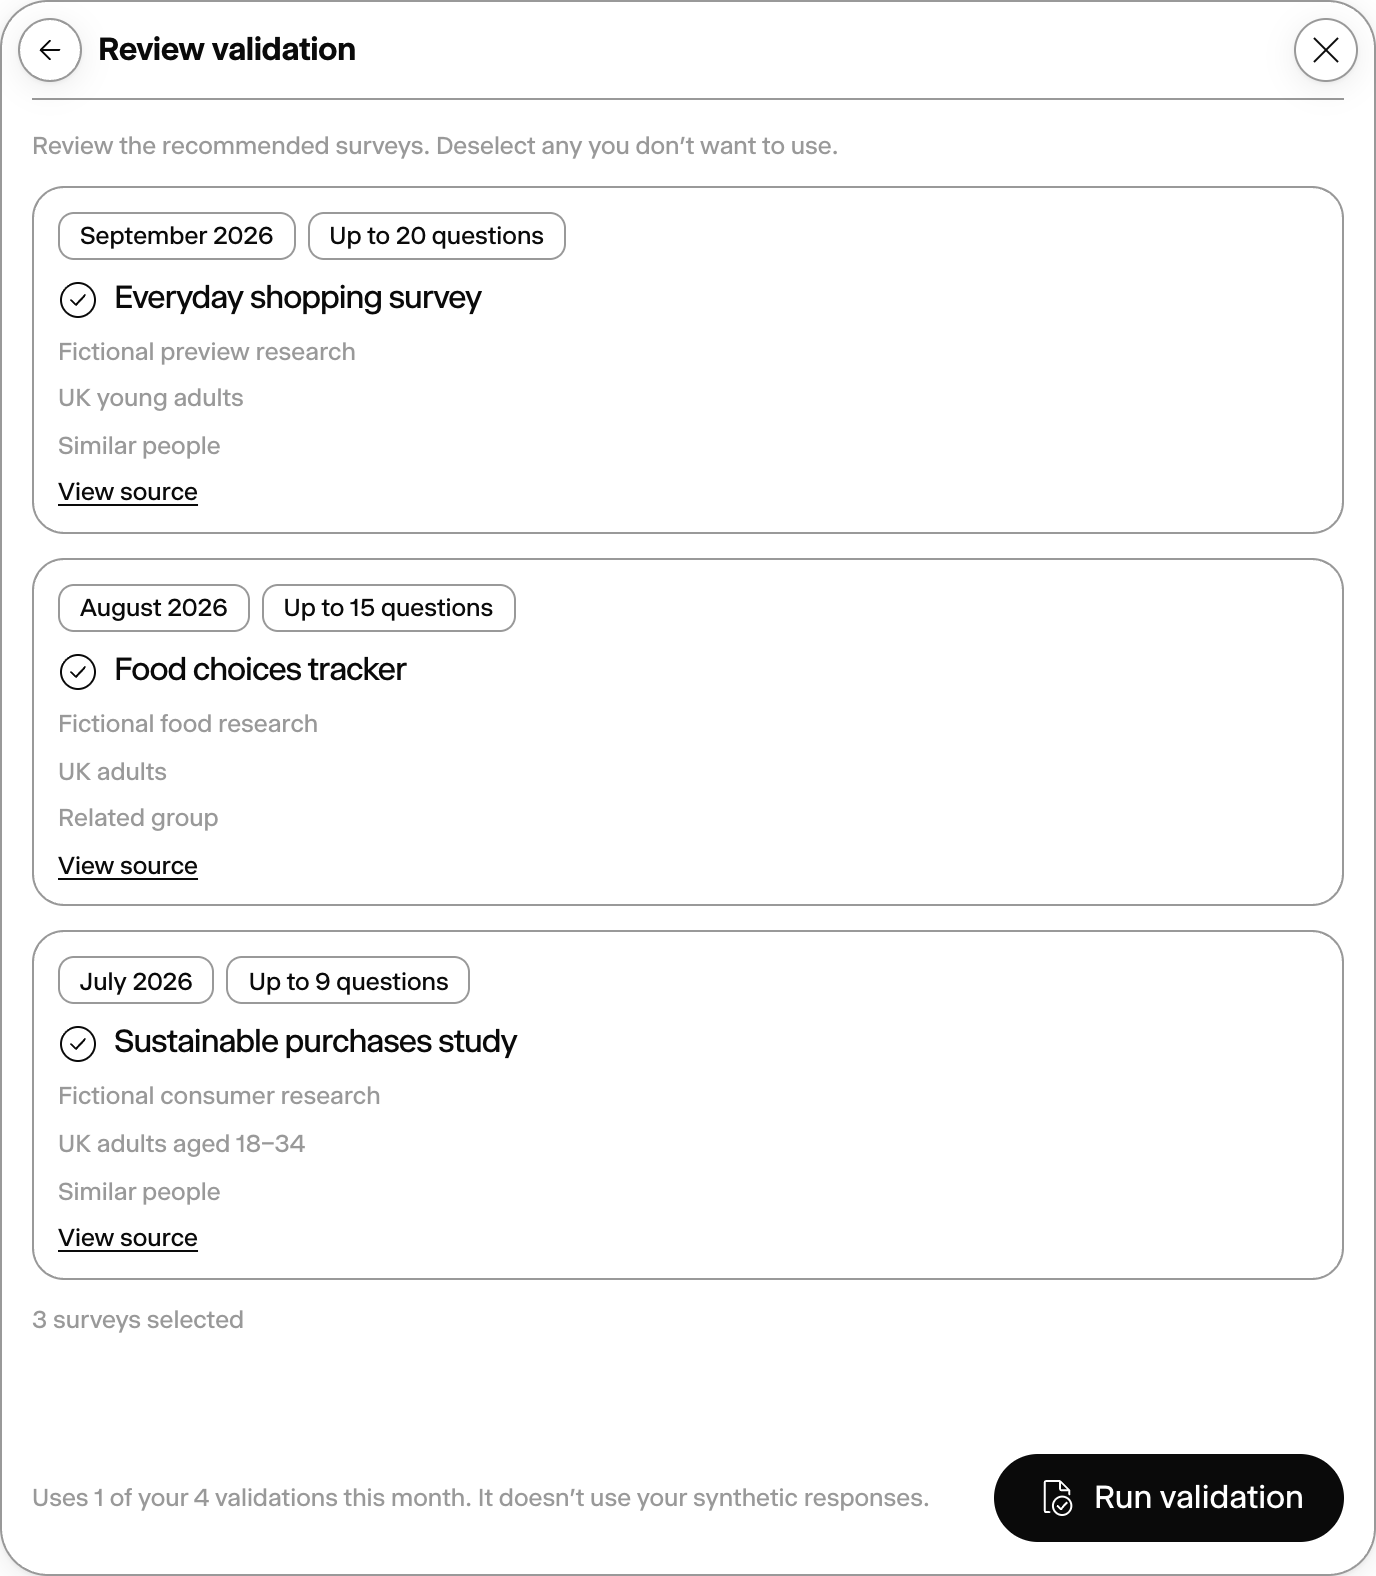
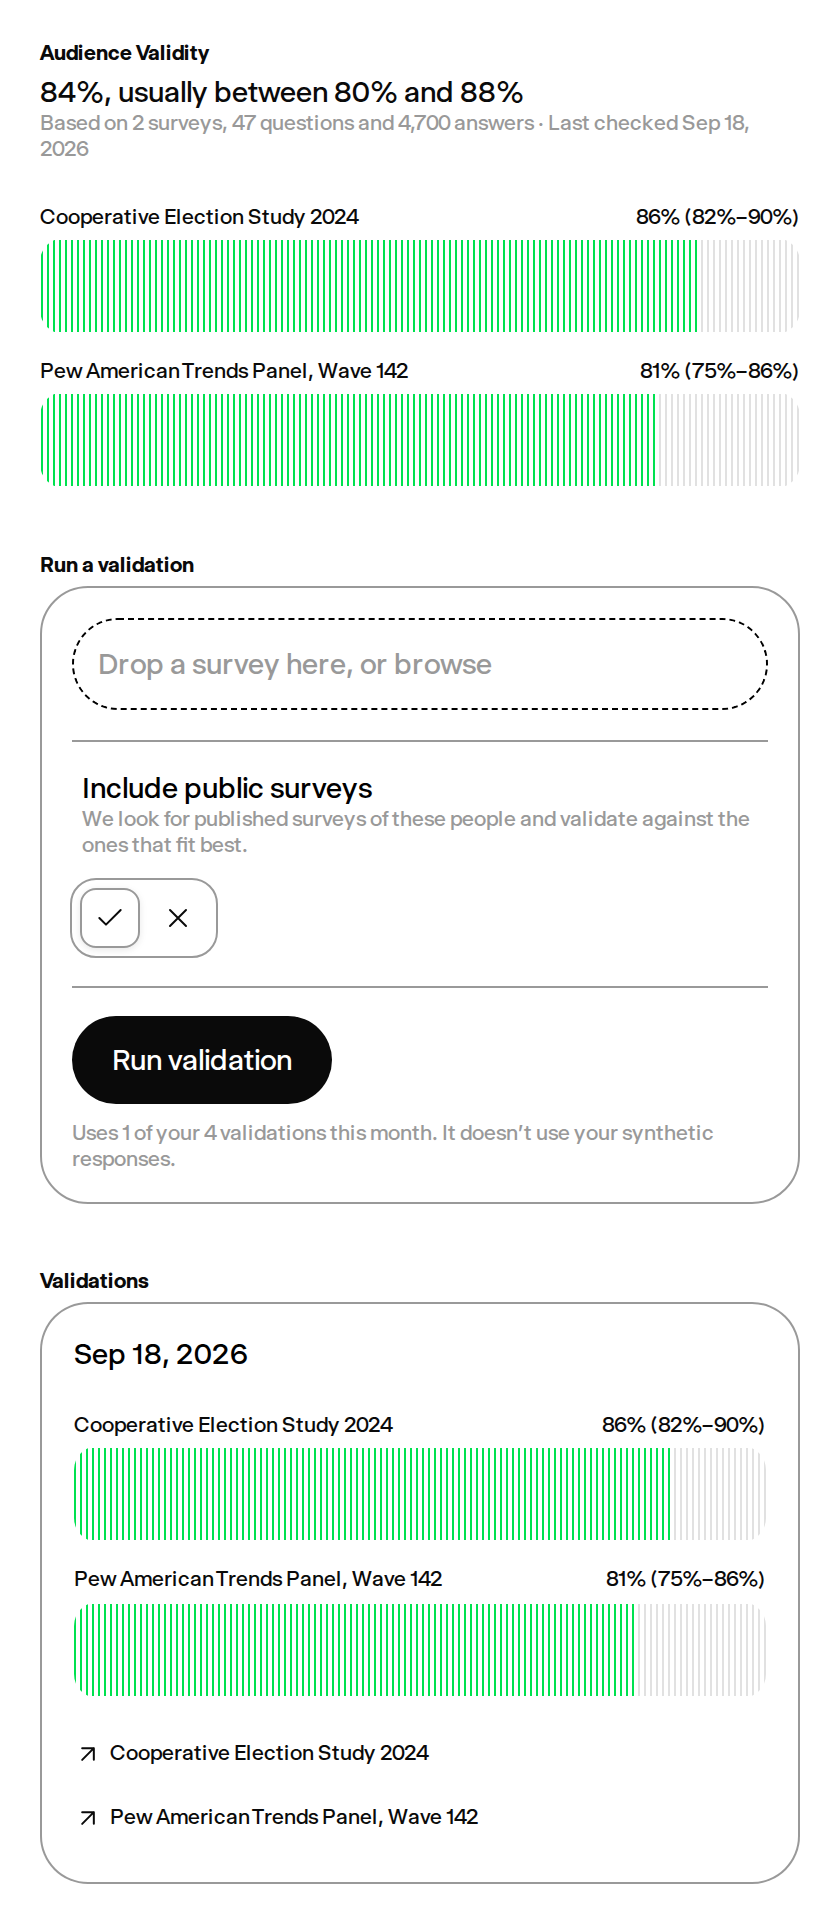
Validation d’AudienceComparez les réponses d’une Audience aux résultats de sondages publiés ou importés. La validation à l’usage consomme des réponses prépayées, sans quota mensuel de validations inclus. Les abonnements payants conservent leurs quotas Stripe ou contractuels.
Review public survey sources and population fit before validation; deselect surveys to exclude them. Illustrated with fictional preview data.
Validation tab of an Audience: its validity out of 100 with one chart row per survey, the form to run a validation, and previous validations
Audiences du MarketplaceAbonnez-vous à des Audiences publiées par des partenaires ou publiez les vôtres pour d'autres équipes, l'accès payant étant facturé comme une option mensuelle du forfait Pro.
Capacités incluses
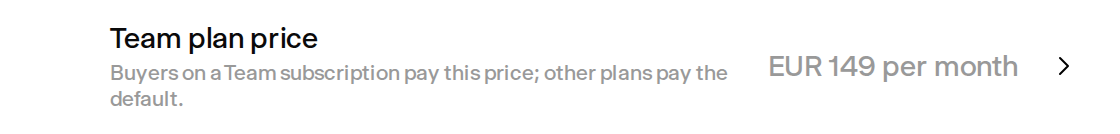
Tarification par forfaitLes éditeurs peuvent fixer le prix d'une Audience par forfait : un prix facultatif pour le forfait Pro s'applique aux acheteurs disposant d'un abonnement Pro, et laisser ce champ vide applique le même tarif à tous les forfaits. Le prix indiqué dans les détails de l'Audience, dans la fenêtre d'abonnement et sur la facture est toujours celui que le forfait paie réellement.
Pro plan price row of a Marketplace Audience
Visuels de couverture et performance de la bibliothèqueLes visuels de couverture générés conservent un décor en studio blanc homogène tout en utilisant des tenues, des activités et des objets posés au sol propres à chaque audience, ce qui rend chaque Audience visuellement distincte. La bibliothèque d'Audiences utilise des miniatures de couverture à la taille d'affichage et donne la priorité aux cartes visibles, afin que de vastes collections enregistrées et Marketplace restent fluides pendant la navigation.
Cartes du MarketplaceLes cartes du Marketplace utilisent trois niveaux d'accent visuel : les traitements élevé et normal adaptent la mise en page centrée sur la couverture, tandis que les lignes à faible accent affichent un avatar d'Audience à gauche avec le nombre de Minds sous le nom. Chaque carte du catalogue conserve une action contextuelle à côté du titre : Enregistrer pour les Audiences gratuites ou S'abonner pour les options payantes ; les actions d'Étude et de gestion restent dans la fenêtre de détails.
Page publique du MarketplaceLe catalogue est public sur getminds.ai/marketplace, dans les neuf langues : toute personne non connectée — visiteur, moteur de recherche, assistant IA — voit chaque Audience publiée avec sa description, ses sources et son nombre de Minds, et peut chercher dans tout le catalogue sans compte. Agir sur une Audience ouvre l'inscription, au nom de l'Audience choisie.
The signed-out Marketplace page at getminds.ai/marketplace
Une page par audience publiqueChaque audience publique a sa propre page sur getminds.ai/marketplace/<nom>, dans les neuf langues, avec la même vue qu'un lien partagé : visuel, description sourcée, les Minds qui la composent et une conversation avec eux. Les liens partagés d'audiences publiques orientent les moteurs de recherche vers cette page au lieu de lui faire concurrence ; les liens vers des audiences privées restent non indexés.
Onboarding personnaliséConfigurez vos premières Audiences en quelques minutes : décrivez votre marque, collez l'adresse de votre site web et joignez des fichiers de contexte ; Minds rédige des Audiences fondamentales que vous examinez avant leur création.
Capacités incluses
Trois Audiences fondamentales ancréesConfigurez vos premières Audiences en quelques minutes : décrivez votre marque, collez l'adresse de votre site web et joignez plusieurs fichiers de contexte ; Minds identifie le contexte de l'entreprise avant de rédiger trois Audiences fondamentales, clients finaux, utilisateurs professionnels et audiences du commerce ou de la distribution lorsque cela est pertinent, ainsi que des Audiences de parties prenantes supplémentaires, optionnelles, uniquement lorsqu'elles sont réellement distinctes. Chaque Audience est ancrée de façon indépendante dans ses propres sources et distributions, avec une description ancrée, un nombre de membres équilibré et un visuel de couverture généré progressivement.
Selected core Audience card
Examiner et modifier avant la créationAvant la création, une étape de revue dédiée vous permet d'inspecter chaque Audience proposée et de modifier les pourcentages de ses distributions ancrées. L'ancrage approuvé et les Formations de segmentation sont persistés avec chaque Audience avant son ouverture.
Visuels, sources et recherche en directLes visuels de couverture démarrent en parallèle dès que les Audiences candidates sont identifiées, pendant que la recherche et l'équilibrage masqué des personas se poursuivent. Les cartes de brouillon affichent les sources vérifiées utilisées pour chaque Audience. Le chargeur reste en phase d'analyse jusqu'à l'arrivée des mots-clés de recherche en direct, puis diffuse les recherches vérifiées à un rythme lisible ; les brouillons prêts ne sont pas retenus par les visuels optionnels ni par la mise en correspondance avec le Marketplace. Les retravaux répètent visiblement les mêmes étapes de recherche et préservent à l'identique les cartes non concernées.
Live research status line
Questions de repli et suggestions du MarketplaceSi une source d'entreprise fournie ne donne pas assez de contexte, Minds demande une description concise de l'offre et du marché avant de rédiger. Il suggère des Audiences pertinentes du Marketplace et ouvre le Plan personnalisé pour une Étude questionnaire temporaire avec les Audiences que vous conservez.
Fallback question for the offering and market
Transition vers la première ÉtudeLe Plan personnalisé reprend l'objectif de recherche sélectionné, la description de l'entreprise, le site web et le contexte téléversé, évite de redemander la sélection d'Audiences et passe directement au choix de la méthode de recherche puis à la revue modifiable des questions ; la première question soumise crée l'Étude, de sorte que l'enregistrement des Audiences reste indépendant des allocations d'Études.
Start your first Study button
Allocation, passage et redémarrageLes limites de l’espace sont vérifiées avant la création des Audiences. Les Audiences prêtes sont conservées si une autre échoue, et celle-ci peut être relancée. Vous pouvez passer la configuration ou la reprendre après une connexion Google Drive ou OneDrive ou le rechargement du même onglet.
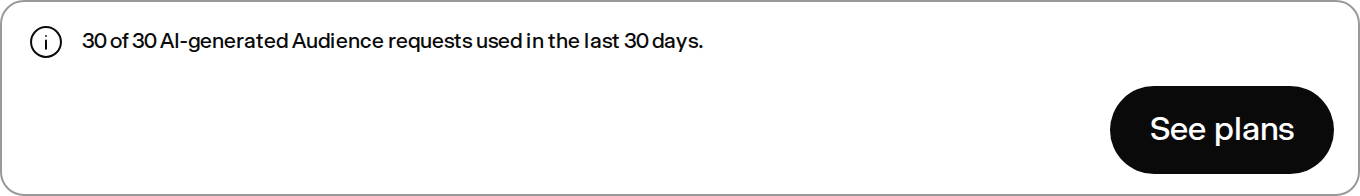
Allowance notice with the plans action

Workflows de recherche

Moyens d'interroger les Minds, de comparer des segments et de tester des stimuli.

FonctionnalitéDescription
ÉtudesUn seul espace de travail d'Étude pour des entretiens approfondis avec des Minds, l'exploration qualitative à grande échelle, des questionnaires assortis de lectures quantitatives directionnelles, des tests de concepts et de messages, et des comparaisons de segments.
Capacités incluses
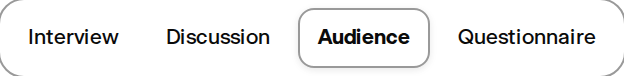
Formats d'ÉtudeUn entretien approfondi avec un seul Mind, une discussion animée entre plusieurs Minds, une question posée à une Audience entière dont chaque Mind répond en parallèle, ou un questionnaire assorti d'une méthode de recherche. Les formats peuvent être combinés au sein d'une même Étude.
Format toggle: Interview, Discussion, Audience, Questionnaire
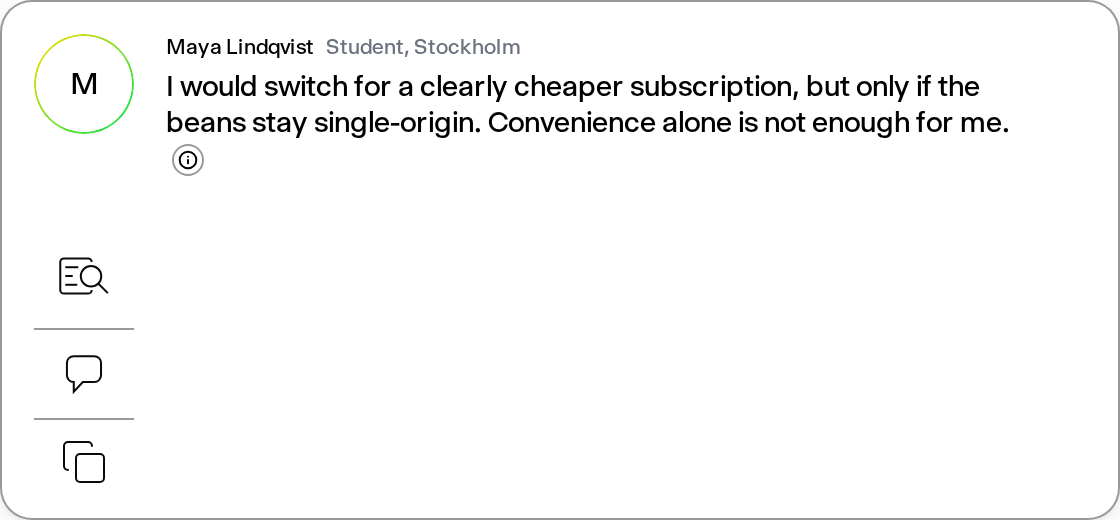
Fils de discussion contextuels avec un MindCliquez sur Chat dans la réponse d'un Mind pour poursuivre à partir de cette question précise, avec ses réponses antérieures ainsi que les fichiers et images pertinents de l'Étude, sans avoir à les téléverser de nouveau. Le fil enregistré se rouvre avec son contexte et renvoie vers l'Étude d'origine ; il exclut les réponses des autres répondants et les questions ultérieures. Les suggestions de relance tenant compte du contexte respectent la langue de l'Étude en cours.
Mind answer card with the Closer Look, Chat and Copy actions
Citations au niveau des affirmations dans les entretiensDans un entretien approfondi en tête-à-tête avec un Mind, les affirmations issues de la base de connaissances, de la recherche web, des liens analysés et des documents téléversés affichent les mêmes survols de logos de source en ligne que les cartes de réponse d'une Étude : les sources publiques ouvrent leurs URL exactes, tandis que les fichiers privés restent sans lien et n'exposent jamais de chemins de stockage.
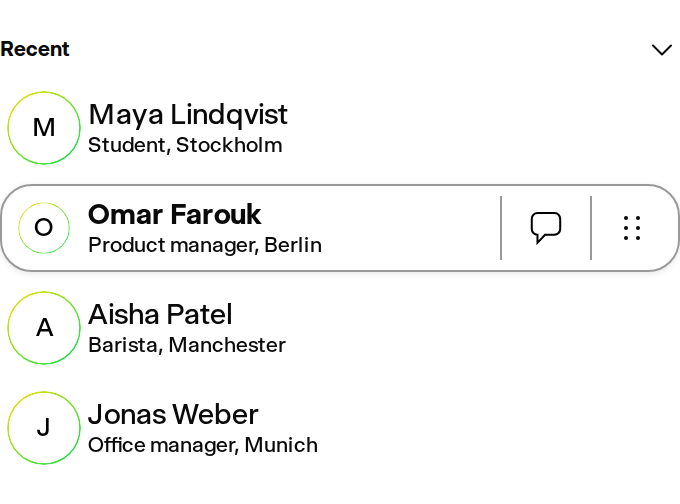
Choisir des Minds et des AudiencesChoisissez des Minds depuis le champ de saisie principal pour ouvrir immédiatement le sélecteur ; un panneau Minds ouvert se replie pendant la transition. Les suggestions récentes de Minds et d'Audiences apparaissent une seule fois chacune, sans se répéter pour combler des emplacements vides.
Recent Minds picker
Démarrage Rapide avec découverte d'AudiencesPour un démarrage Rapide guidé par la demande, le sélecteur accessible au clavier maintient visible l'état de chargement stable (Twinkle) pendant qu'il résout et analyse la demande ainsi que les sites web joints, les téléversements et les ressources d'intégrations prises en charge, avant de déduire l'Audience visée. Il classe conjointement les correspondances pertinentes de votre bibliothèque privée et du Marketplace, et rédige de nouvelles Audiences utiles. Les actions évidentes d'espace de travail, comme exporter, télécharger ou remettre en forme un résultat existant, sont dirigées vers une aide à l'action au lieu de donner lieu à l'invention d'audiences d'analystes. La découverte a une attente bornée : elle conserve les correspondances utiles déjà trouvées ou propose de réessayer plutôt que de charger indéfiniment. Elle peut présenter côte à côte plusieurs alternatives réutilisables et nouvelles (NEW), exactes ou adjacentes, y compris une nouvelle option portant le même nom lorsqu'une Audience existante correspond, tout en laissant chaque résultat non sélectionné jusqu'au choix de l'utilisateur. Les Audiences existantes conservent leur nombre de Minds réellement enregistré, y compris les grandes Audiences constituées manuellement ; seuls les nouveaux brouillons Rapides utilisent la plage de 5 à 20 Minds compatible avec le forfait. Chaque demande Rapide exige une confirmation explicite de l'Audience avant le démarrage d'une Étude, y compris en cas de correspondance exacte avec une Audience existante. Les nouveaux brouillons confirmés entrent dans le flux de création d'Audience partagé, les sources analysées étant conservées.
Audience selector with existing and new Audience suggestions
Études de projetLes projets peuvent lancer une nouvelle Étude à partir des Minds individuels du projet et la conserver avec celui-ci. Les messages de l'Étude indiquent explicitement lorsqu'une Audience ne dispose d'aucun Mind disponible ou qu'elle est encore en préparation.
Carte de progression et de statutUne carte de statut en haut à droite réunit les Audiences de l'Étude en cours et les Études qui tournent en arrière-plan, et ramène vers une Étude terminée dès qu'un résultat en arrière-plan est prêt. À l'intérieur d'une Étude, la carte est toujours accessible et se limite à cette Étude : elle associe sa progression en cours à ses Audiences comme surface de gestion ; les Audiences prêtes affichent leur nombre de Minds réellement enregistré, une commande en cercle avec un moins retire une Audience de l'Étude, et une ligne Ajouter une Audience ouvre le même sélecteur d'Audiences par étapes que le reste de l'espace de travail. Sur la vue d'ensemble, la carte continue de rassembler chaque brouillon enregistré, chaque Étude en cours et chaque Audience encore en préparation. D'autres fonctionnalités de longue durée peuvent publier leurs propres lignes de progression dans la même carte, et un clic sur une ligne ramène vers la fonctionnalité qui l'a publiée.
Historique des résultats rapideLes Études de longue durée affichent d'abord les résultats terminés les plus récents, afin que la transcription s'ouvre rapidement. Les résultats antérieurs restent disponibles par lots prévisibles, et sélectionner un résultat différé depuis la navigation de recherche l'affiche avant de faire défiler jusqu'à l'élément de preuve demandé.
Configuration et plans d'ÉtudeLancez une Étude en mode Rapide ou via la configuration Personnalisée en six étapes. Chaque demande devient un Plan d'Étude versionné, avec des questions, des formats de réponse et une méthode examinés, confirmés avant toute exécution.
Capacités incluses
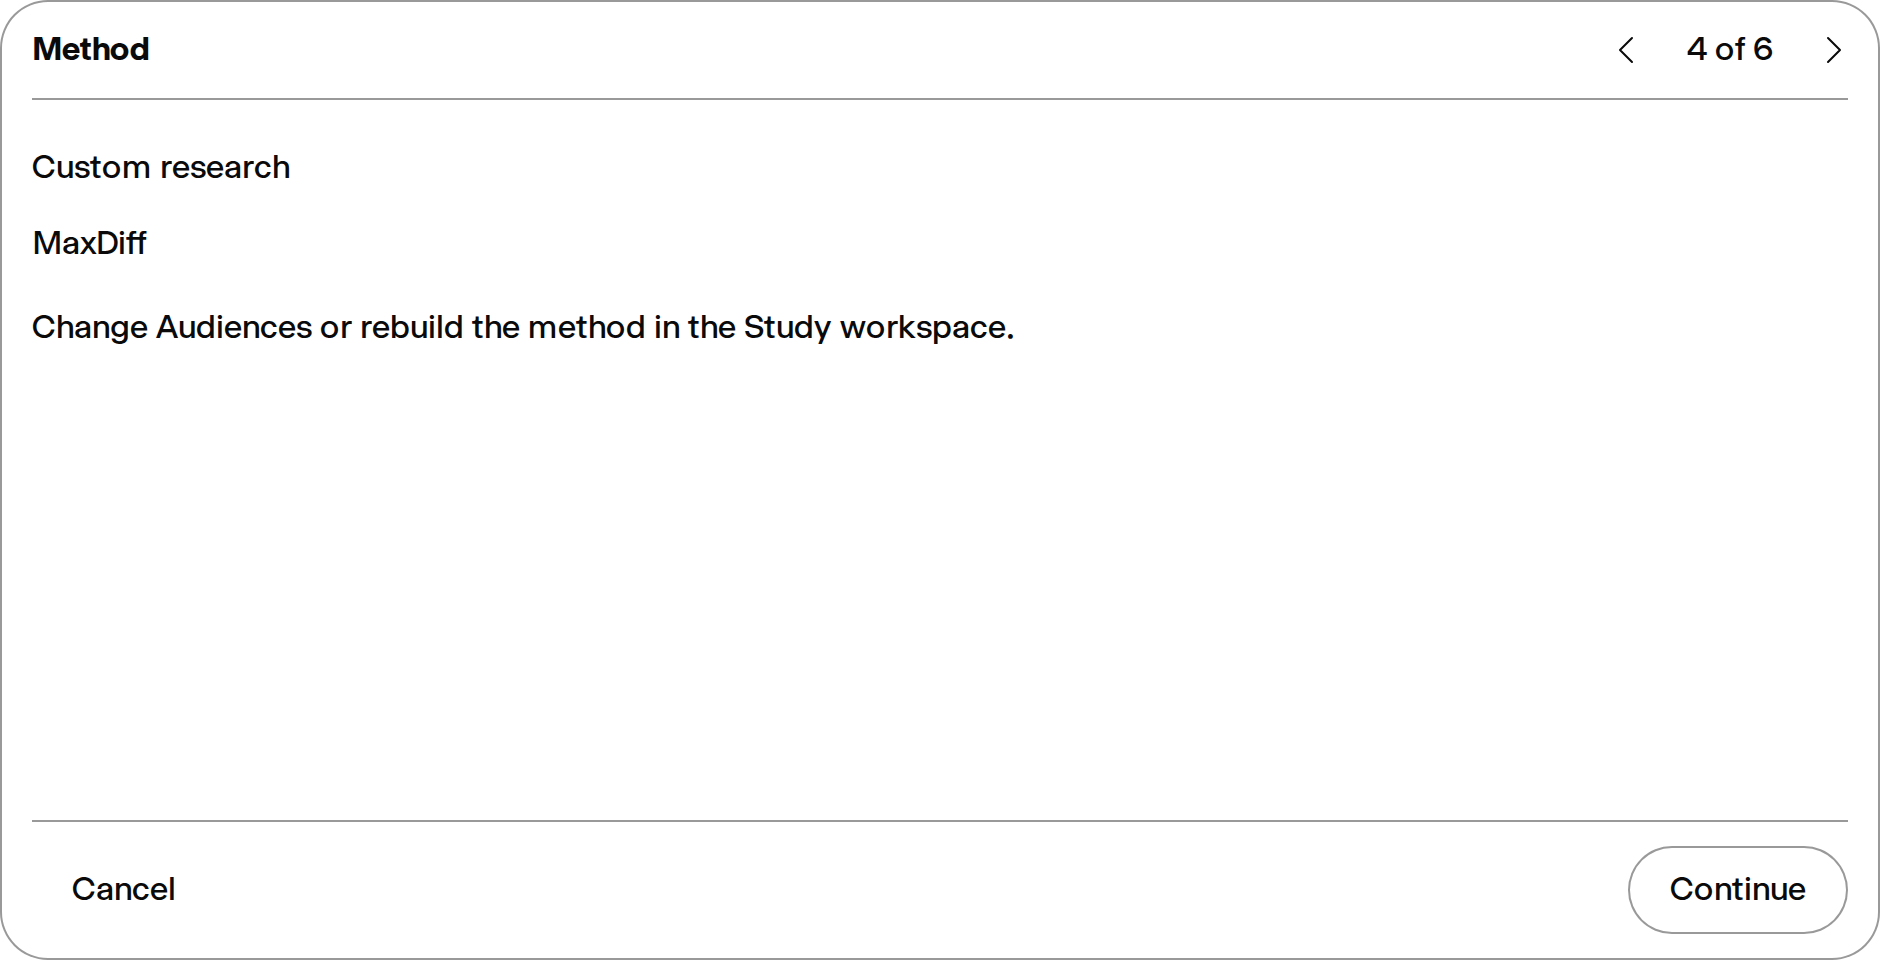
Mode Rapide et configuration PersonnaliséeLancez une Étude en mode Rapide ou utilisez la configuration Personnalisée guidée par l'IA en six étapes pour définir l'objectif de recherche, ajouter un site web, des fichiers ou des notes, sélectionner des Audiences, examiner des questions adaptées à l'objectif et confirmer l'ensemble de la configuration avant l'exécution de l'Étude.
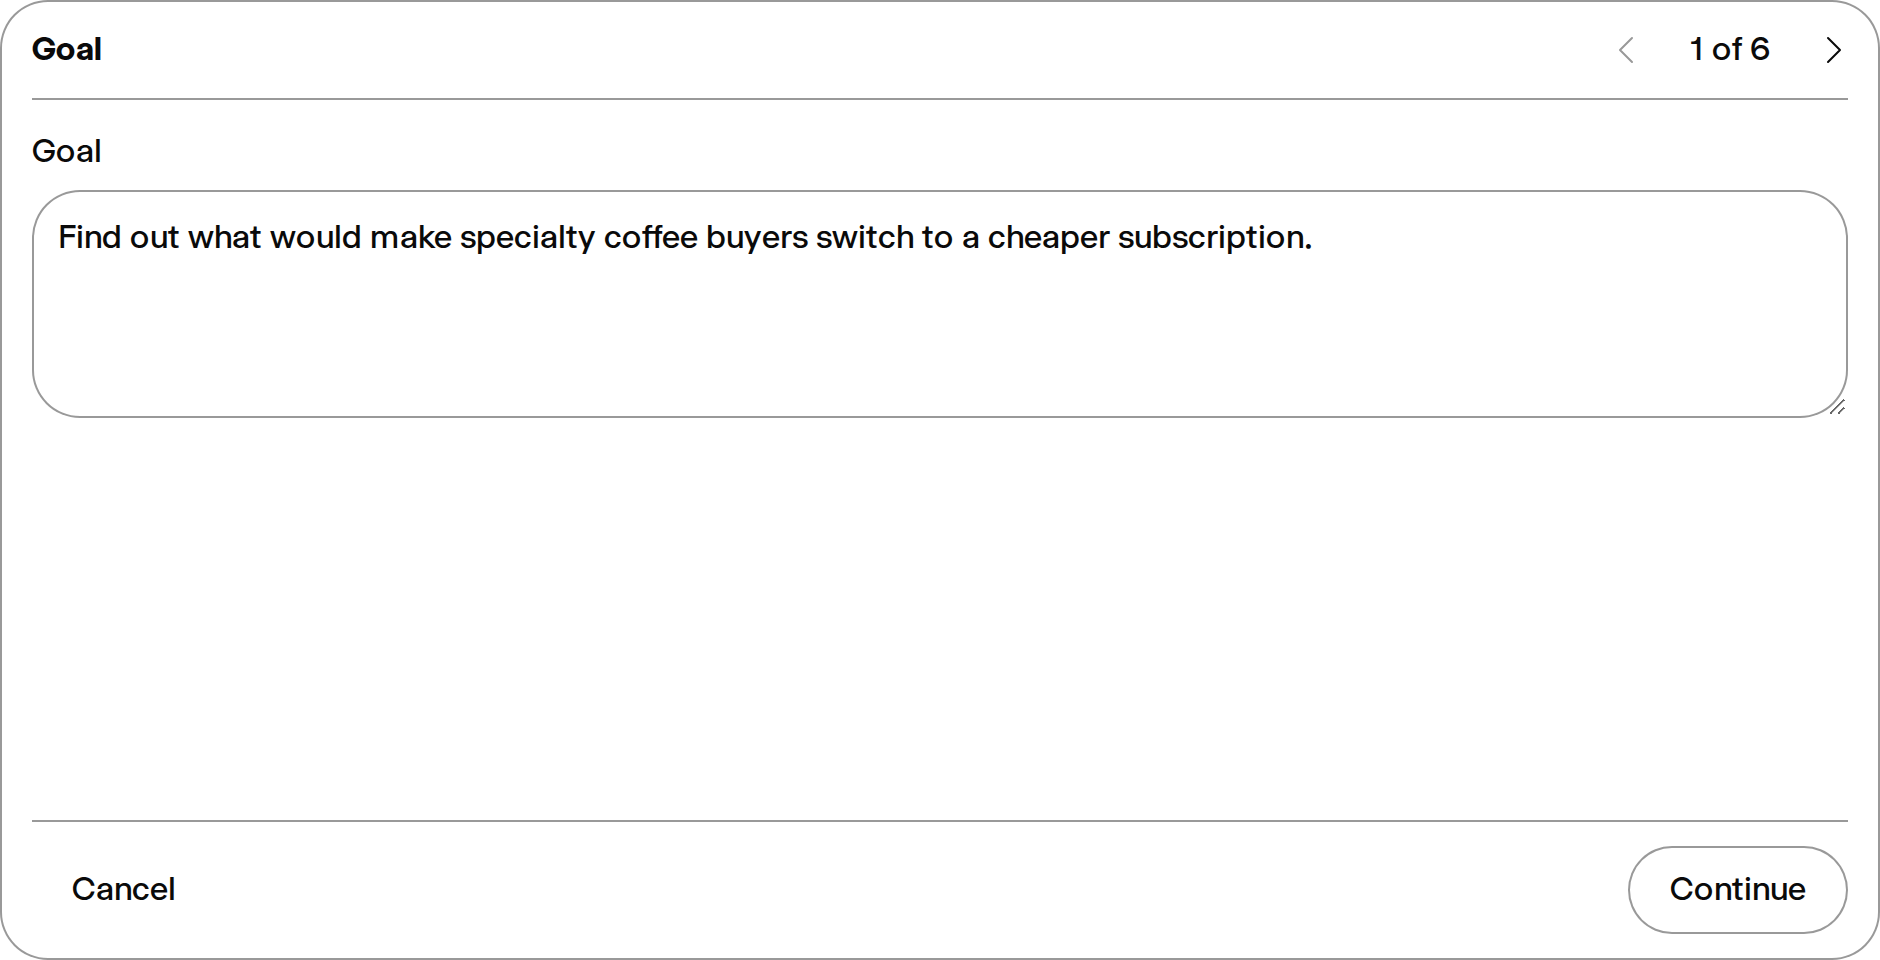
Custom setup step 1 of 6: the research goal
Étape Audience avec sélecteur MarketplaceL'étape Audience, en mode Rapide comme en mode Personnalisé, peut ouvrir l'intégralité du Marketplace comme sélecteur externe : les sélections Marketplace confirmées reviennent dans le plan, tandis qu'une annulation restaure la sélection précédente du plan. Passer du compositeur au mode Personnalisé transfère dans la configuration la demande en cours ainsi que le site web joint, les téléversements et le contexte des intégrations prises en charge. Les recommandations contextuelles d'Audience s'appuient sur les mêmes Audiences enregistrées classées et brouillons d'audience que le mode Rapide, avec les brouillons déduits comme point d'ancrage de pertinence, afin que des correspondances faibles et sans rapport issues de la bibliothèque ne soient pas présentées comme des recommandations. Les nouveaux brouillons (NEW) se sélectionnent à l'intérieur de l'étape 3 ; la tuile Nouvelle Audience accepte une description supplémentaire dans la même étape, sans quitter l'assistant pour le panneau de création autonome. Chaque brouillon reste visiblement marqué pour création à l'étape 6 et n'entre dans le pipeline partagé de création ancrée d'Audiences Rapides qu'après confirmation de l'ensemble de la configuration par l'utilisateur.
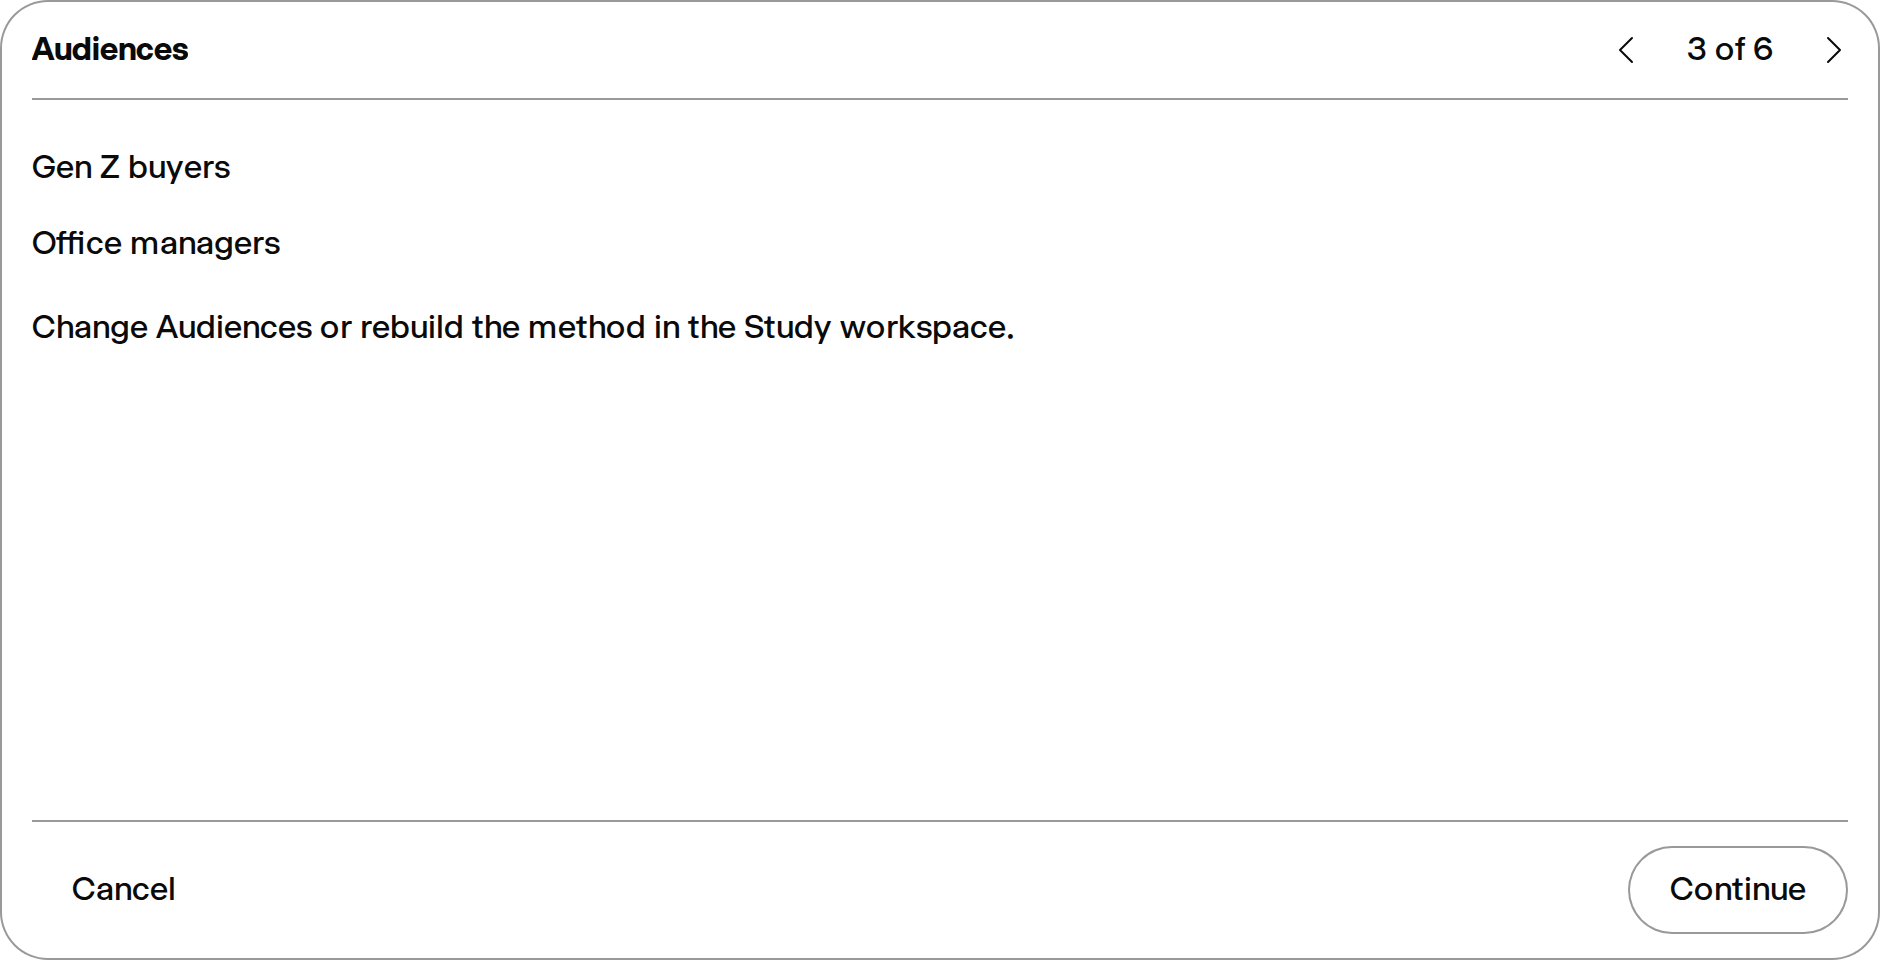
Custom setup step 3 of 6: Audiences
Brouillons d'Étude reprenablesAprès le premier choix de planification, chaque nouvelle configuration Rapide ou Personnalisée est enregistrée comme brouillon d'Étude isolé dont le sous-titre dans la barre latérale est Draft (brouillon). Une fermeture, une navigation, un rechargement ou un démarrage en échec préserve exactement l'étape de planification, les questions, la méthode, la sélection d'Audiences et le contexte téléversé canonique ; plusieurs brouillons peuvent être repris indépendamment. Les points de sauvegarde restent isolés par brouillon lors du passage d'une conversation à l'autre. Les prompts de planification ouverts plus tard à l'intérieur d'une Étude existante sont délibérément exclus. Le même cycle de vie de brouillon, limité au propriétaire et sûr en cas de révision, est disponible via l'API v1 et MCP, afin que des agents puissent créer, réviser et reprendre un plan, l'exécution exigeant toujours une confirmation explicite.
Study draft row in the sidebar
Confirmation et lancementLa confirmation crée et ouvre immédiatement l'Étude durable ; les téléversements et la préparation des nouvelles Audiences (NEW) se poursuivent derrière les chargeurs existants de l'Étude, et les Audiences obtenues sont rattachées à cette même Étude avant le démarrage de ses questions confirmées. Le brouillon est supprimé uniquement après acceptation du démarrage par le serveur : à l'acceptation dans la file, le brouillon correspondant est consommé de façon atomique, de sorte qu'un lancement ne peut pas apparaître à la fois comme Étude et comme brouillon en double ; un lancement refusé laisse le brouillon reprenable. Une fois confirmée, l'Étude en cours d'exécution détient l'état de l'Étude au lieu de rouvrir la configuration au rechargement, et son résultat utilise comme titre le sujet de recherche confirmé et concis plutôt que le brief interne complet.
Confirm and run button
Capture du plan et confirmationLe planificateur capture l'objectif, le sujet, la question principale et la source principale, distingue les questions de l'utilisateur des suggestions de l'agent et renvoie des questions de confirmation explicites avant toute exécution. Les utilisateurs peuvent réviser le brouillon ou conserver un parcours de questionnaire exécutable simple. La confirmation présente le format de réponse proposé pour chaque question, texte libre, choix, échelle numérique standard ou échelle personnalisée, et permet de le modifier avant l'exécution ; le contrat de réponse confirmé reste attaché tout au long du traitement durable. Après confirmation, le mode Personnalisé affiche dans le message d'origine un résumé concis généré par le planificateur, avec le nombre de questions et les métadonnées de méthode localisés, au lieu de répéter l'intégralité du brief. La confirmation suit la paternité de la question plutôt que leur nombre : une question unique rédigée par le planificateur lui-même, y compris son interprétation d'une relance courte comme « wie viel », est confirmée avant d'atteindre l'Audience, tandis qu'une question rédigée par l'utilisateur s'exécute directement.
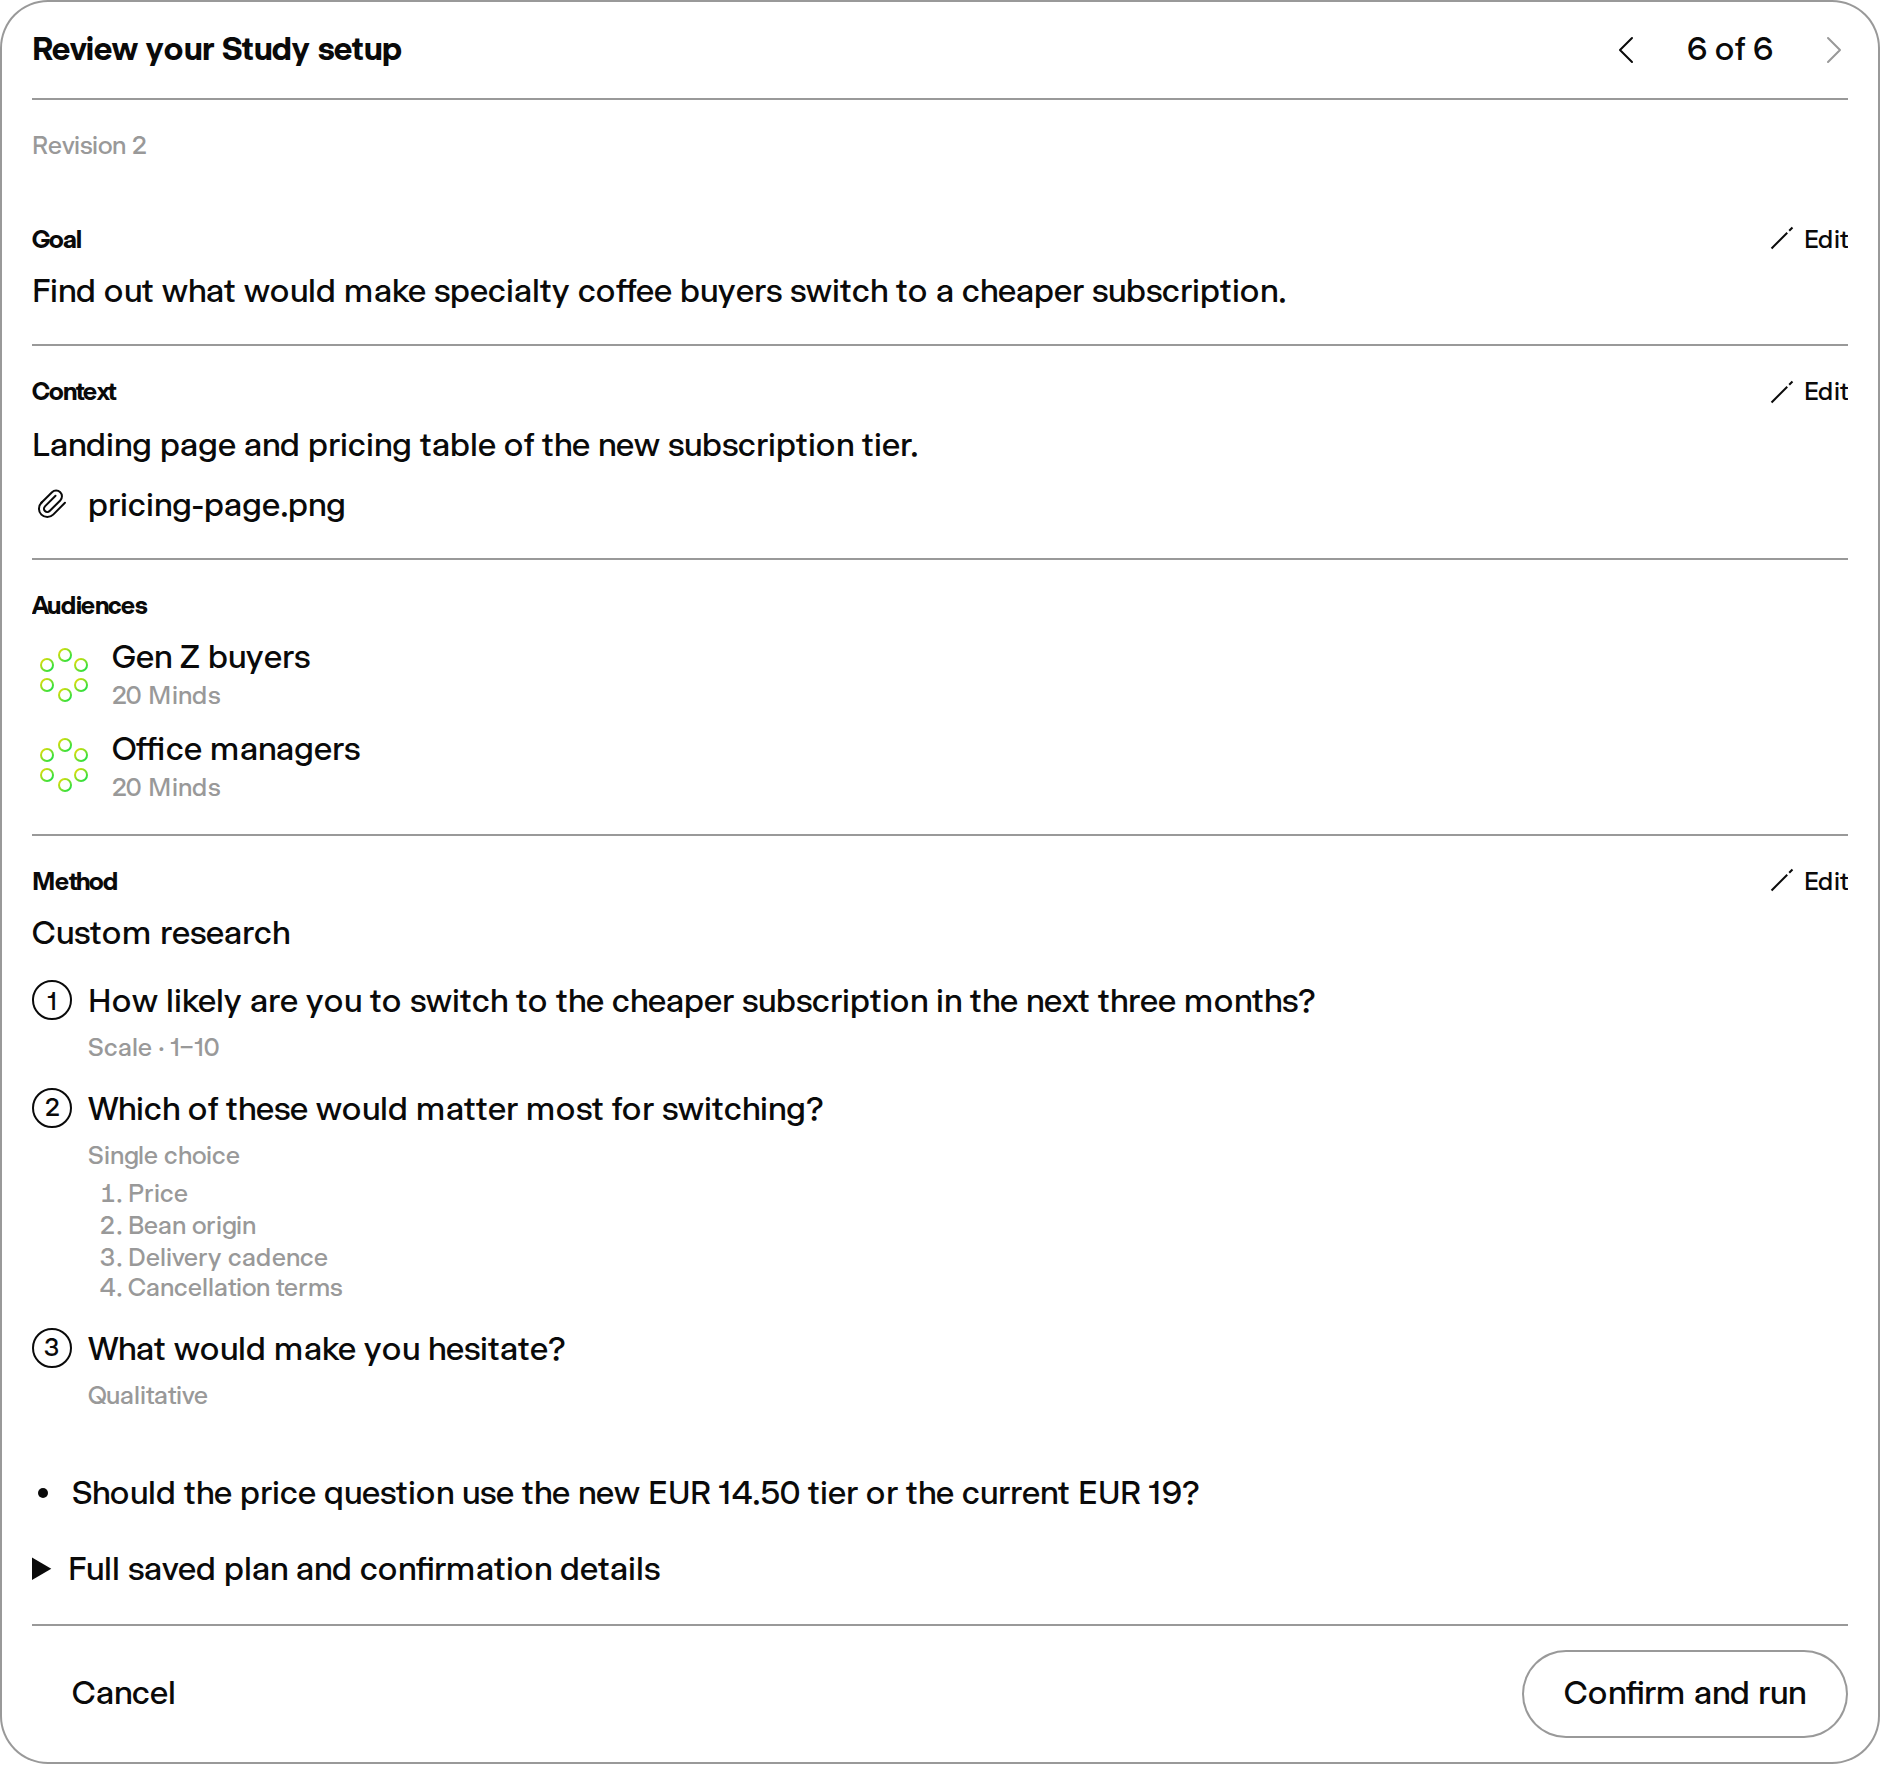
Review step with goal, context, Audiences, method, questions and a confirmation question
Langue de l'ÉtudeUne Étude confirmée conserve dans son plan la langue d'interface en cours et l'utilise tout au long de l'exécution par le processeur ; les plans plus anciens sans langue d'Étude conservent le repli sur la langue enregistrée du propriétaire. Une langue d'Étude explicite régit les textes de confirmation ajoutés par le serveur, les questions, les réponses des Minds, les libellés de catégories, les résultats par question et regroupés, ainsi que les actualisations ultérieures du résumé global de l'Étude, même lorsqu'un collaborateur ou un appelant avec clé API utilise une autre langue. Lorsque le propriétaire d'une Étude lance un questionnaire après avoir changé la langue de la demande, l'exécution utilise cette langue de demande en cours ; les exécutions déclenchées par un collaborateur conservent la langue enregistrée du propriétaire, afin que l'Étude partagée reste cohérente.
Study language toggle
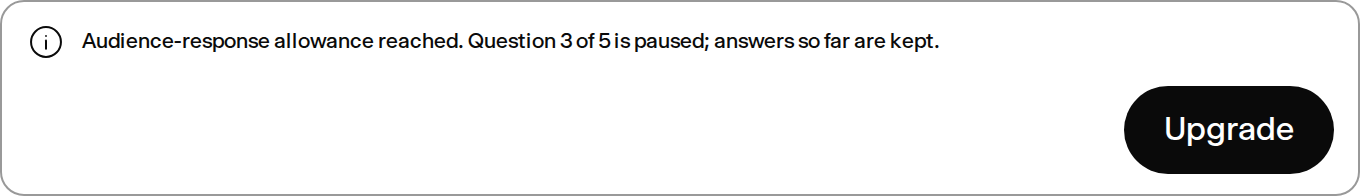
Vérification des allocations avant et pendant une exécutionUne Étude Personnalisée confirmée vérifie son allocation de conversations avant le début du travail de génération d'Audience : un lancement bloqué ouvre donc immédiatement le parcours de mise à niveau contextuel existant, au lieu de passer plusieurs minutes à préparer d'abord une Audience. Les limites de réponses d'Audience sont appliquées avant le lancement et avant chaque question mise en file : les lancements bloqués ouvrent le parcours de mise à niveau sans démarrer, tandis que les limites atteintes en cours d'exécution préservent les preuves partielles, arrêtent le reste, notifient l'utilisateur et restent explicitement signalées comme limitées par le forfait plutôt que comme terminées.
Allowance notice pausing a queued question
Bloc d'origine des questionsLes exécutions multi-questions confirmées affichent un seul bloc d'origine numéroté reprenant les questions exactes, tandis que les enregistrements acceptés ou en attente abandonnés, sans tâche en file, restent masqués.
Question header with number, response format and method tags
Plans via API et MCPLes Études exécutables confirmées conservent un instantané de plan immuable et exposent la progression durable du questionnaire, les calculs de méthode et des blocs de résumé sémantique flexibles via l'API v1 et MCP ; les plans de ressources visuelles conservent l'intention de sortie orientée heatmap pour les moteurs de rendu de l'interface.
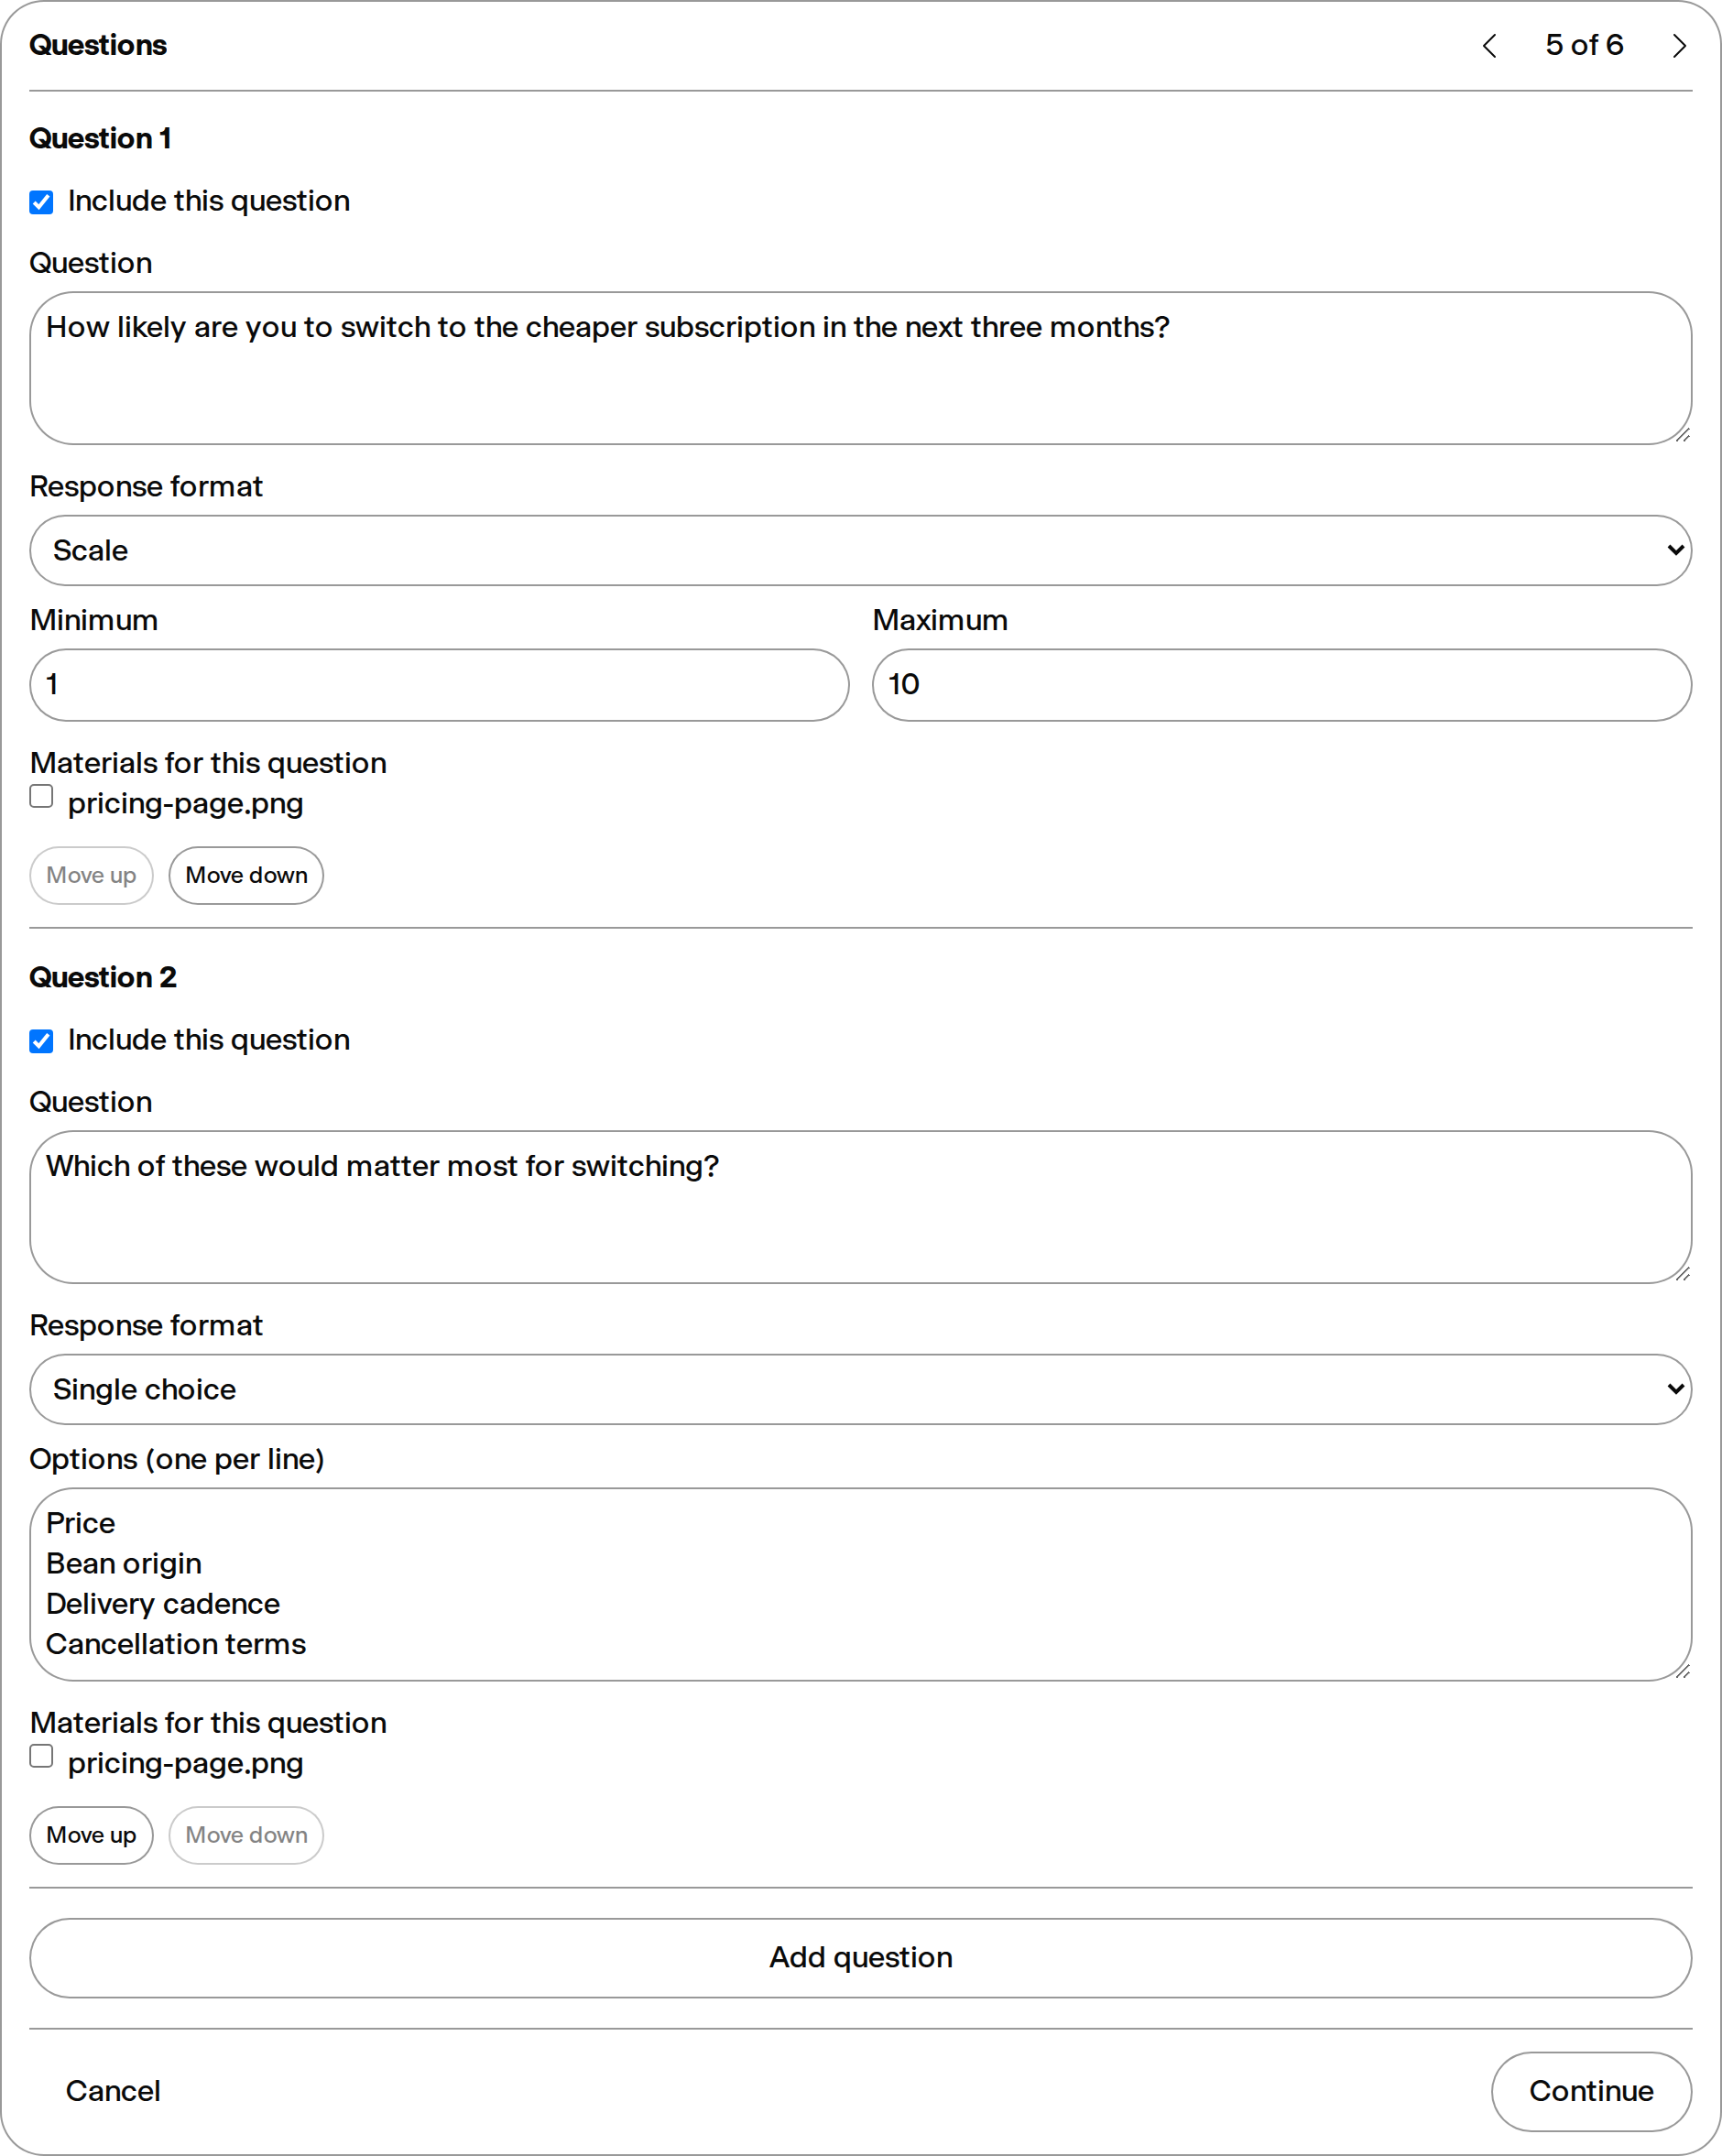
Détection des questions et revue du planExtrayez et détectez les questions à partir des prompts saisis dans une Étude ou téléversés sous forme de fichiers de questionnaire, laissez les utilisateurs examiner l'objectif et la source interprétés, distinguez les questions rédigées par l'utilisateur de celles suggérées, et modifiez les plans multi-questions générés à partir d'objectifs de recherche plus larges avant leur exécution. Le mode Rapide, la génération de questions en mode Personnalisé, la révision de plan, l'API v1 et MCP partagent la même politique de planification de recherche et le même modèle de planification rapide. Une méthode disponible et confirmée conserve sa méthode exacte et son contrat de pipeline tout au long du flux normal ou du processeur durable de questionnaire ; les méthodes expérimentales et planifiées restent consultables mais ne peuvent pas être lancées. L'analyse de documents côté processeur utilise directement les octets téléversés en interne et authentifiés lorsqu'ils sont disponibles, de sorte que les workers du mode Personnalisé et des questionnaires ne dépendent pas de la transformation d'un chemin de proxy de téléversement relatif en URL publique.
Questions step with detected questions and response formats
File d'attente des questionsAffichez chaque élément en attente et sa progression en direct dans une file d'attente de questions au-dessus du champ de saisie de l'Étude, ajoutez d'autres requêtes saisies dans leur ordre de soumission et gardez chaque réponse de sous-question regroupée sous sa demande d'origine. Les tâches générées par une méthode remplacent la liste optimiste de questions par la file exécutable détenue par le processeur, afin que la progression reste cohérente après des expansions telles qu'un MaxDiff. Lorsqu'une relance en file d'attente démarre, elle quitte immédiatement la file et apparaît dans l'Étude avec son état de chargement avant l'arrivée de la réponse. Les relances restent derrière la recherche principale active. Dans une Étude enregistrée, les relances en file d'attente s'exécutent durablement dans le processeur : elles survivent à un rechargement de page ou à la fermeture puis la réouverture de l'Étude et vont jusqu'au bout. Les éléments en attente peuvent être retirés avant leur démarrage. Retirer la dernière ligne visible d'une demande en file annule l'intégralité de son travail durable, y compris les tâches créées par une classification ultérieure ; une fois la file vide et aucune réponse en cours, le message suivant démarre immédiatement.
Queued question chip with its remove action
Ce qui compte comme une seule questionUne demande est découpée uniquement là où l'utilisateur a écrit une liste : marqueurs explicites, lignes distinctes ou questions consécutives. Une question en plusieurs parties reste entière, de sorte que ses options, ses relances et ses lignes coupées par le retour automatique restent rattachées à la question à laquelle elles appartiennent, et le matériel de référence collé n'est jamais exploité pour en extraire les questions rhétoriques qu'il contient. Tout le reste est interprété comme une seule demande de recherche au lieu d'être découpé sur la ponctuation.
E-mail de fin d'exécutionLorsqu'une Étude comportant plusieurs questions termine une exécution en arrière-plan de longue durée, la personne qui l'a soumise reçoit une notification par e-mail unique renvoyant vers les résultats, y compris lorsque certaines questions n'ont pas pu être traitées ; les exécutions courtes, annulées ou arrêtées par l'allocation de réponses du forfait ne donnent jamais lieu à un e-mail.
ModèlesEnregistrez des ensembles de questions comme modèles et réutilisez-les dans la recherche personnalisée, en privé ou en partage avec votre équipe.
Saved question template row
Méthodes de rechercheOnze méthodes de recherche déterministes s'exécutent de bout en bout au sein d'une Étude : MaxDiff, NPS, top/bottom box, analyse des facteurs clés, TURF, Gabor-Granger, Van Westendorp, Kano, préférences classées, comparaison de segments et analyse conjointe. La significativité n'est affirmée que là où l'échantillon le permet.
Capacités incluses
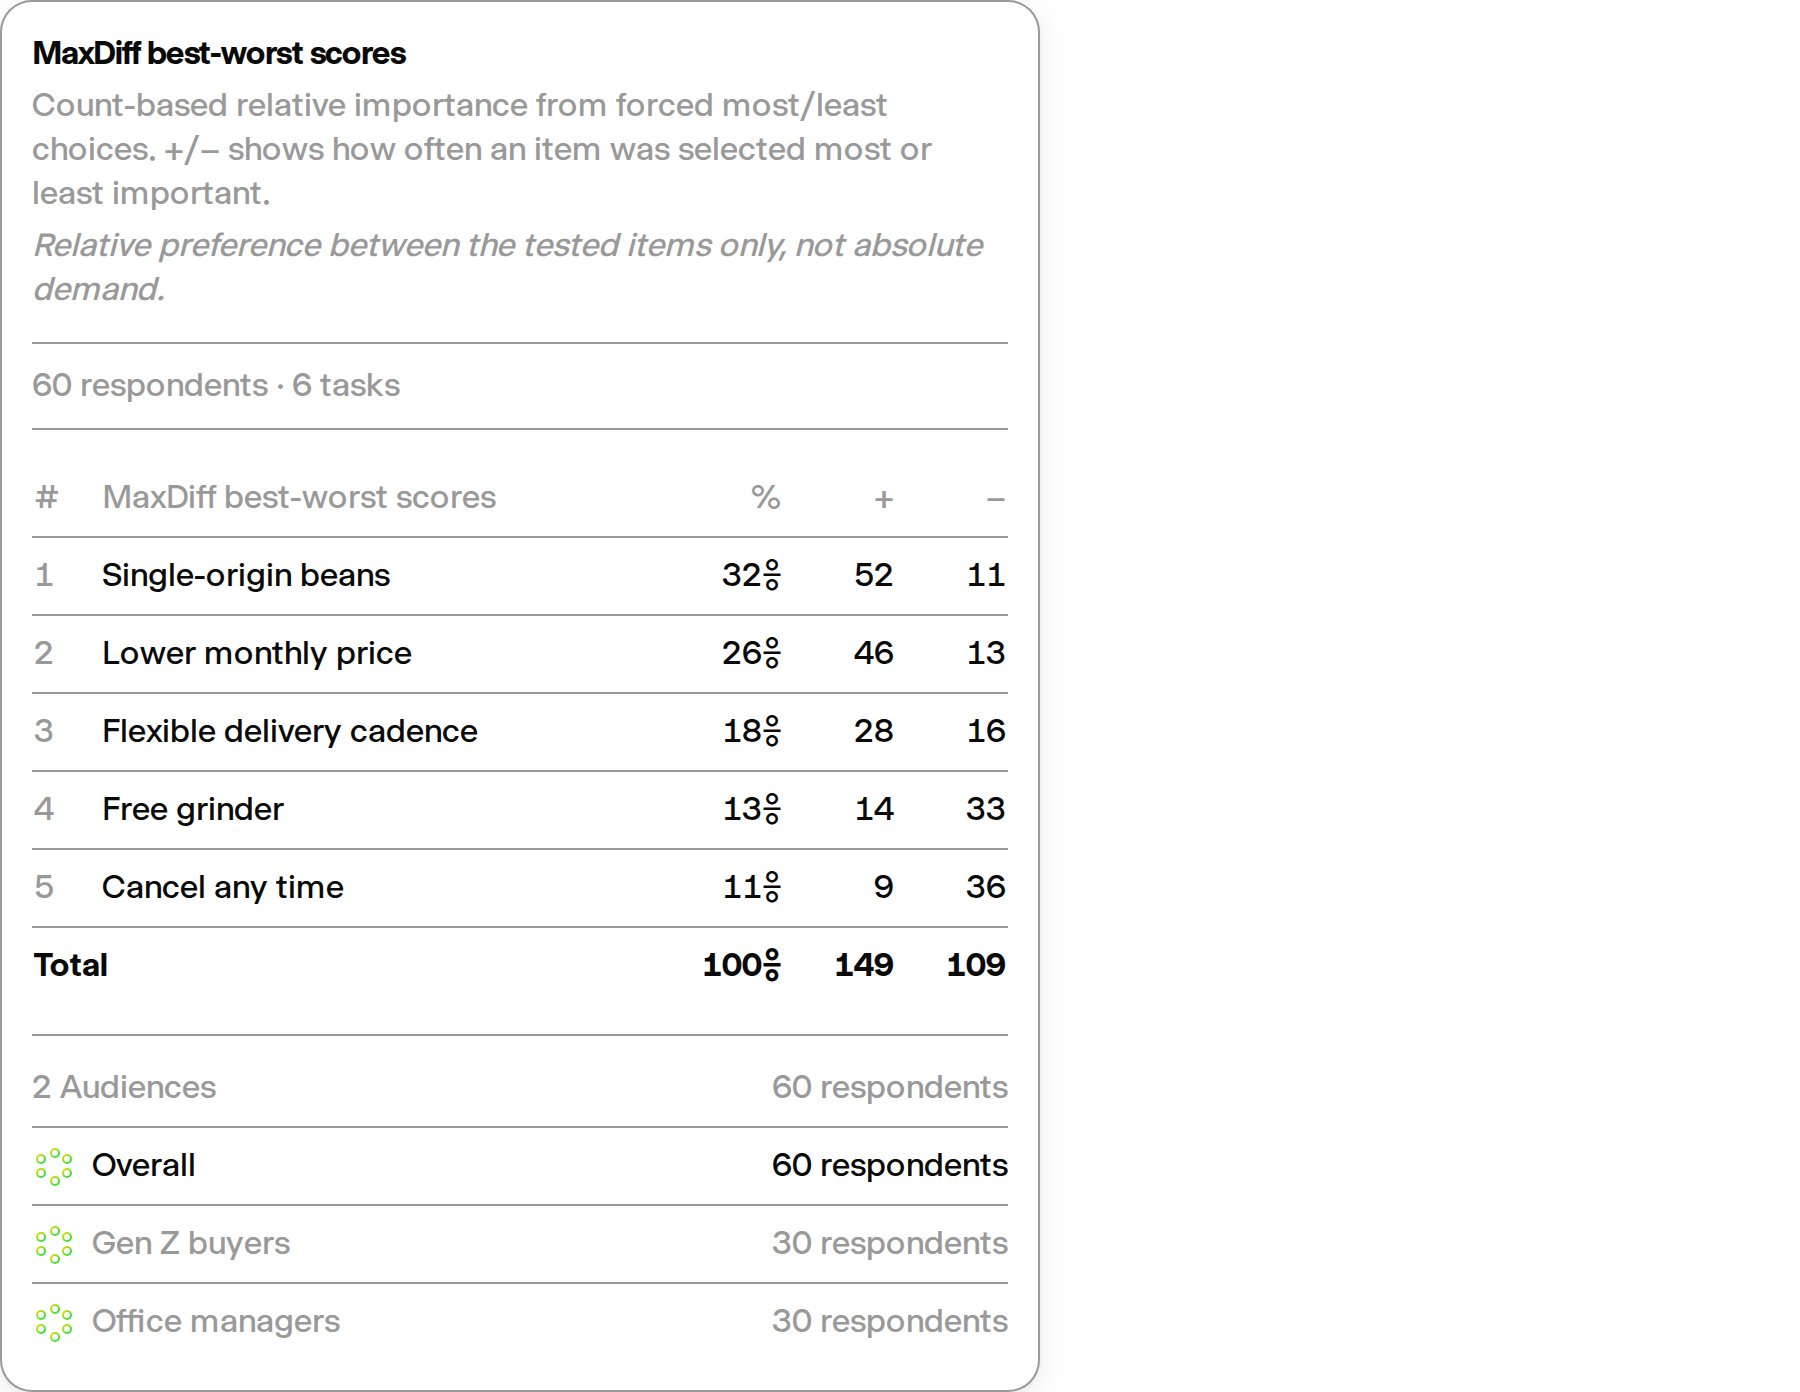
Onze méthodes exécutablesOnze méthodes s'exécutent de bout en bout : MaxDiff utilise un protocole de choix forcé conçu côté serveur, tandis que le NPS, le scoring top/bottom box, l'analyse des facteurs clés, TURF, Gabor-Granger, Van Westendorp, Kano, les préférences classées et la comparaison de segments passent par le même contrat d'adaptateur déterministe, avec des calculs globaux et par Audience, y compris des tests de significativité par paires entre groupes pour la comparaison de segments, le scoring top/bottom box, le NPS et les préférences classées, à l'aide de tests exacts et adaptés aux petits échantillons, assortis d'une correction pour comparaisons multiples sur l'ensemble de chaque résultat. La comparaison de segments compare les groupes d'Audience qui ont réellement répondu plutôt qu'une liste de segments déclarée, et signale un groupe répondant unique avec une explication au lieu de ne renvoyer aucun résultat. Une méthode développe une question du planificateur en une tâche par item, point de prix ou paire de caractéristiques, jusqu'à 100 questions dans une Étude ; un plan d'expérience tronqué par ce plafond garde les paires de caractéristiques entières et signale ce qu'il n'a pas pu demander. L'analyse conjointe s'exécute également : le serveur construit un plan de choix D-optimal, demande aux répondants de choisir entre des configurations complètes et estime un logit conditionnel pour obtenir les utilités partielles par niveau et l'importance des attributs, en refusant de développer un plan dont les utilités partielles ne seraient pas estimables séparément. Chaque tâche de méthode générée fige dans la tâche durable un instantané de son espace de réponse exact, ce qui empêche un worker de réinterpréter des options de choix forcé.
MaxDiff best-worst score card
Les calculs comme preuves faisant autoritéLes artefacts de calcul déterministes font autorité comme preuves pour le résumé du résultat : le modèle reçoit leur méthode enregistrée, leur portée, leur signification méthodologique et leurs valeurs exactes, décide où ils trouvent réellement leur place et les explique sans recalculer les scores. Un résumé terminé peut recevoir plus tard un artefact de calcul valide manquant sans être régénéré. L'Alignement au niveau d'une question et les calculs de méthode au niveau d'une exécution partagent une seule fenêtre Analyse au style résumé, de sorte que des valeurs d'Alignement répétées restent rattachées à leur question exacte au lieu d'apparaître dans une fenêtre de calcul séparée. L'heure de démarrage du processeur est persistée, afin que le compteur de chargement survive à la réouverture ou au rechargement d'une Étude.
Headline metric from a deterministic calculation
Comparaison de segmentsComparez les réponses de différentes Audiences pour voir où les segments s'accordent, divergent ou nécessitent des messages différents.
Tests de significativité honnêtesLa significativité n'est affirmée que là où l'échantillon le permet : les comparaisons de parts utilisent le test exact de Fisher plutôt qu'une approximation normale dont ces tailles d'échantillon ne peuvent pas satisfaire les conditions de validité, les comparaisons de moyennes utilisent un test t de Welch avec les degrés de liberté de Satterthwaite, de sorte que les petits groupes élargissent eux-mêmes leur incertitude, tous les tests d'un même résultat sont corrigés ensemble par la procédure de Benjamini-Hochberg, afin qu'un item ne paraisse pas significatif du simple fait que des dizaines de comparaisons ont été menées à ses côtés, les groupes qui ont répondu sans aucune dispersion interne ne peuvent pas produire de différence significative, et une comparaison qui n'a pas pu être menée le dit au lieu de laisser un silence qui se lirait comme une absence de différence. Les valeurs p rapportées sont plafonnées par le bas plutôt qu'arrondies à zéro, car aucun résultat ne rend une différence certaine.
Sélecteur de méthode avec explicationsLes méthodes dont les calculateurs ne peuvent pas encore s'exécuter restent visibles dans le sélecteur de méthode sans pouvoir être choisies, et une Étude qui attend encore son calcul affiche une étape de calcul dédiée dans le flux de résultats. Le sélecteur explique chaque méthode au lieu de se contenter de la nommer : chaque ligne porte une phrase en langage clair décrivant à quoi sert la méthode, et le survol ouvre une fiche avec l'explication complète, qui nomme la technique sous-jacente pour qu'un professionnel des études la reconnaisse, best-worst scaling, tests t de Welch, Total Unduplicated Reach and Frequency, et qui énonce la même limite permanente que portent les résultats, afin que le choix soit éclairé avant l'exécution de l'Étude et pas seulement après. Aucune étiquette « Advanced » n'est affichée, car elle signalait la difficulté plutôt que la pertinence ; la mention « Not available yet » (pas encore disponible) demeure, car elle change ce qui peut être sélectionné. Les explications sont rédigées nativement dans les neuf langues d'interface, en utilisant les mots propres à chaque langue pour désigner une Audience et une Étude plutôt que les termes anglais.
Method row with its plain-language explanation
Réponses d'AudiencePosez une question une seule fois à une Audience et recevez des réponses synthétiques parallèles de ses Minds, ancrées dans les sites web, fichiers, images, vidéos et fichiers audio que vous fournissez. Les fichiers audio autonomes MP3, WAV, M4A, OGG, FLAC et audio-WebM utilisent la même analyse de transcription et de bande-son non verbale bornée ; si une voie de preuve échoue, l’autre reste disponible.
Capacités incluses
Ancrées dans le matériel fourniLorsqu'un message d'Étude comprend un site web, un fichier, une source, une capture d'écran ou une image correctement chargés, chaque réponse de Mind conservée doit s'appuyer sur un détail concret de ce matériel fourni au lieu de traiter la ressource comme absente.
Supplied stimulus shown above the answers
Analyse vidéo et audioPour une vidéo téléversée dans une question d'Étude classique, l'analyse des pièces jointes combine la transcription disponible et une chronologie sonore bornée avec un ensemble borné d'images représentatives tenant compte des scènes. Les vidéos de format publicitaire font l'objet d'une analyse de l'intégralité de la bande sonore pour la musique significative, les effets sonores, l'ambiance, les silences, l'émotion vocale et les moments de logo sonore ; les vidéos plus longues utilisent au maximum douze extraits audio de huit secondes répartis uniformément, et tout échec de l'analyse audio laisse disponibles le traitement de la transcription et l'analyse visuelle. Les pièces jointes audio autonomes MP3, WAV, M4A, OGG, FLAC et WebM audio utilisent la même analyse de transcription et d'éléments sonores non verbaux bornée, chacune des deux sources de preuve restant disponible si l'autre échoue. L'échantillonnage visuel préserve la couverture des scènes d'ouverture et de clôture, répartit les sélections sur les vidéos à montage rapide et se rabat sur trois images réparties uniformément lorsque les coupes ne peuvent pas être détectées de façon fiable.
Video scene timeline
Traitement durable en arrière-planLes tours d'Étude les plus lourds se poursuivent durablement en arrière-plan, gardent leur progression visible en direct et se rétablissent après un rechargement de page. Pour les grandes Audiences, le travail de réponse est réparti en lots durables sur la capacité de traitement disponible ; chaque réponse de Mind est diffusée dès qu'elle est terminée, sans attendre tout un lot, tandis qu'une reprise bornée ne relance que les Minds encore manquants.
Running Study with elapsed time and queued questions
Titre, résumé et graphiquesChaque résultat terminé dévoile d'abord son titre et son résumé de recherche synthétisé. Pour une question unique, un graphique de réponse compact s'ajoute avant les lignes de réponse au niveau des Minds qui l'étayent, dans la section Preuves repliable. Une recherche multi-questions ajoute de un à quatre graphiques de synthèse des résultats clés côte à côte, deux en général, sélectionnés au regard de l'ensemble de la demande de recherche et de la conclusion globale, et non du seul pourcentage. Chaque graphique s'appuie sur des effectifs de réponses vérifiés : un pourcentage ou un score ciblé pour un résultat autonome, ou une comparaison à deux ou trois valeurs dès lors que le constat formule une affirmation comparative. Le résultat donne à chaque question traitée son propre volet dépliable, son graphique de réponse, ses distributions d'Audience et ses preuves au niveau des Minds.
Audience response block with chart, summary and actions
Comparaisons de pièces jointes et affectation des ressourcesLes résultats de comparaison de pièces jointes affichent les créations image d'origine et les aperçus de première image des vidéos directement au-dessus de leurs colonnes A/B/C, apparient les variantes par nom de fichier persisté et par occurrence plutôt que par position brute de la pièce jointe, et laissent inchangés les votes et résultats historiques lorsque d'anciens résultats sont rouverts. Plusieurs ressources au niveau d'un bloc exigent des affectations explicites aux questions, pour les vidéos, images, documents et sites web : chaque ressource doit être utilisée par au moins une question, et une affectation vide signifie aucun matériel. MCP, la v1 et le générateur d'Étude appliquent le même contrat d'exécution. Les cartes de résultat utilisent la correspondance enregistrée question par question, gardent chaque vidéo affectée accessible par son nom avec sa propre heatmap de scènes enregistrée et les réactions des Minds, et exposent les références aux documents et aux sites web sans modifier le type de réponse ni la mise en page des comparaisons de pièces jointes.
Variant preview of an attachment comparison
Citations de sources sur les réponsesLorsqu'un Mind utilise des éléments retrouvés dans sa base de connaissances, dans l'ancrage de l'audience ou sur le web, sa fiche au survol et la vue Regard approfondi affichent les logos de source au niveau de l'affirmation, via le même système de citations en ligne que les descriptions du Marketplace. Les URL publiques s'affichent sous forme de logos de source cliquables avec une infobulle de domaine ; les fichiers de connaissances privés restent des sources documentaires sans lien et n'exposent jamais de chemins de stockage. L'attribution établie au moment de la génération est enregistrée avec la réponse, tandis que les réponses historiques peuvent être vérifiées à la demande au regard de la base de connaissances actuelle du Mind et de l'ancrage de l'Audience. La charge utile de résultat v1 expose des marqueurs de citation, des identités de source et la provenance en option, sans renvoyer le texte de connaissances privé sous-jacent.
Test de stimuliTestez des textes, des landing pages, des captures d'écran, des présentations, des concepts produit et des supports de concurrents au sein d'une Étude.
Tests par heatmapLancez des heatmaps de site web, de vidéo ou d'image pour capturer des signaux simulés d'attention et d'interaction.
Capacités incluses
Preuves issues de la page observéeLes preuves visibles issues des sites web et des médias priment sur une hypothèse antérieure non étayée, et les résumés de site web sont dérivés de la trace de la page réellement observée plutôt que d'une réponse obsolète antérieure à la navigation.
Website heatmap surface with Mind markers on the observed page
Traitement des vidéos et des transcriptionsLes médias téléversés utilisent un service de reconnaissance vocale de secours configuré lorsque le fournisseur de transcription principal est indisponible. Les réactions aux vidéos relient l'intégralité de la transcription disponible aux éléments exactement visibles dans les images échantillonnées et se replient sur une analyse purement visuelle lorsque la transcription demeure indisponible.
Video analysis action
Plusieurs images ou vidéos par questionChaque image téléversée est analysée comme une création indépendante au sein d'un même résultat, avec des onglets lettrés qui conservent son nom de fichier. Pour les questions comportant plusieurs vidéos affectées, sélectionner une vidéo sélectionne ses propres scènes enregistrées, sa heatmap et les réactions des Minds. Les analyses manquantes démarrent pour cette question et cette ressource ; changer de ressource préserve les analyses existantes et les résultats globaux de la question.
Page selector for several tested pages
Cohérence entre interface, API et MCPL'interface, la v1 et MCP utilisent la même validation de cible et le même pipeline d'analyse.
Études planifiéesPlanifiez la réexécution d'une Étude chaque jour, chaque semaine, chaque mois ou chaque trimestre. Les exécutions se poursuivent de façon fiable en arrière-plan, se rétablissent après les interruptions de worker et conservent la progression pour consultation et export historiques.
Contrôles de crédibilité de la rechercheLa frontière des preuves reste visible depuis la création de l'Audience jusqu'aux réponses d'une Étude : les hypothèses modélisées ne sont jamais présentées comme des faits mesurés, et chaque Étude énonce son propre niveau de complétude.
Capacités incluses
Les hypothèses modélisées restent identifiées comme tellesLorsque le matériel source est lisible mais qu'aucune distribution étayée par des preuves ne peut être appliquée, Minds conserve l'intégralité du matériel téléversé pour revue et limite cette Audience à des hypothèses modélisées plutôt qu'à des faits clients mesurés : ses Minds reçoivent la consigne de traiter les détails du persona comme des hypothèses de scénario synthétiques, de sorte que la frontière est appliquée dans les réponses elles-mêmes plutôt que sous forme d'un badge que le lecteur devrait remarquer et interpréter. La génération de personas synthétiques et les réponses de panel évitent les effectifs de salariés, chiffres d'affaires, budgets, revenus, fuites de politiques internes, nombres d'incidents et parts de marché exacts et non étayés.
Assumed distribution label
Les briefs et les sources accompagnent le planLes briefs d'étude joints alimentent le planificateur lui-même ; chaque critère explicitement nommé est conservé comme une question distincte et examinable, et le Plan d'Étude complet survit à la transition vers l'Audience jusqu'à la confirmation, au lieu de voir seulement la première question s'exécuter. Une Étude conserve également le matériel que sa demande portait. Un site web ou un fichier nommé dans le message, joint dans le compositeur ou ajouté pendant la revue du plan devient la source confirmée du plan et accompagne chaque question de l'exécution, de sorte que le remplacement de la formulation d'origine par les questions du planificateur conserve la page ou le document examiné. Un fichier de contexte illisible arrête l'Étude au lieu de publier des résultats portant sur un matériel que personne n'a ouvert.
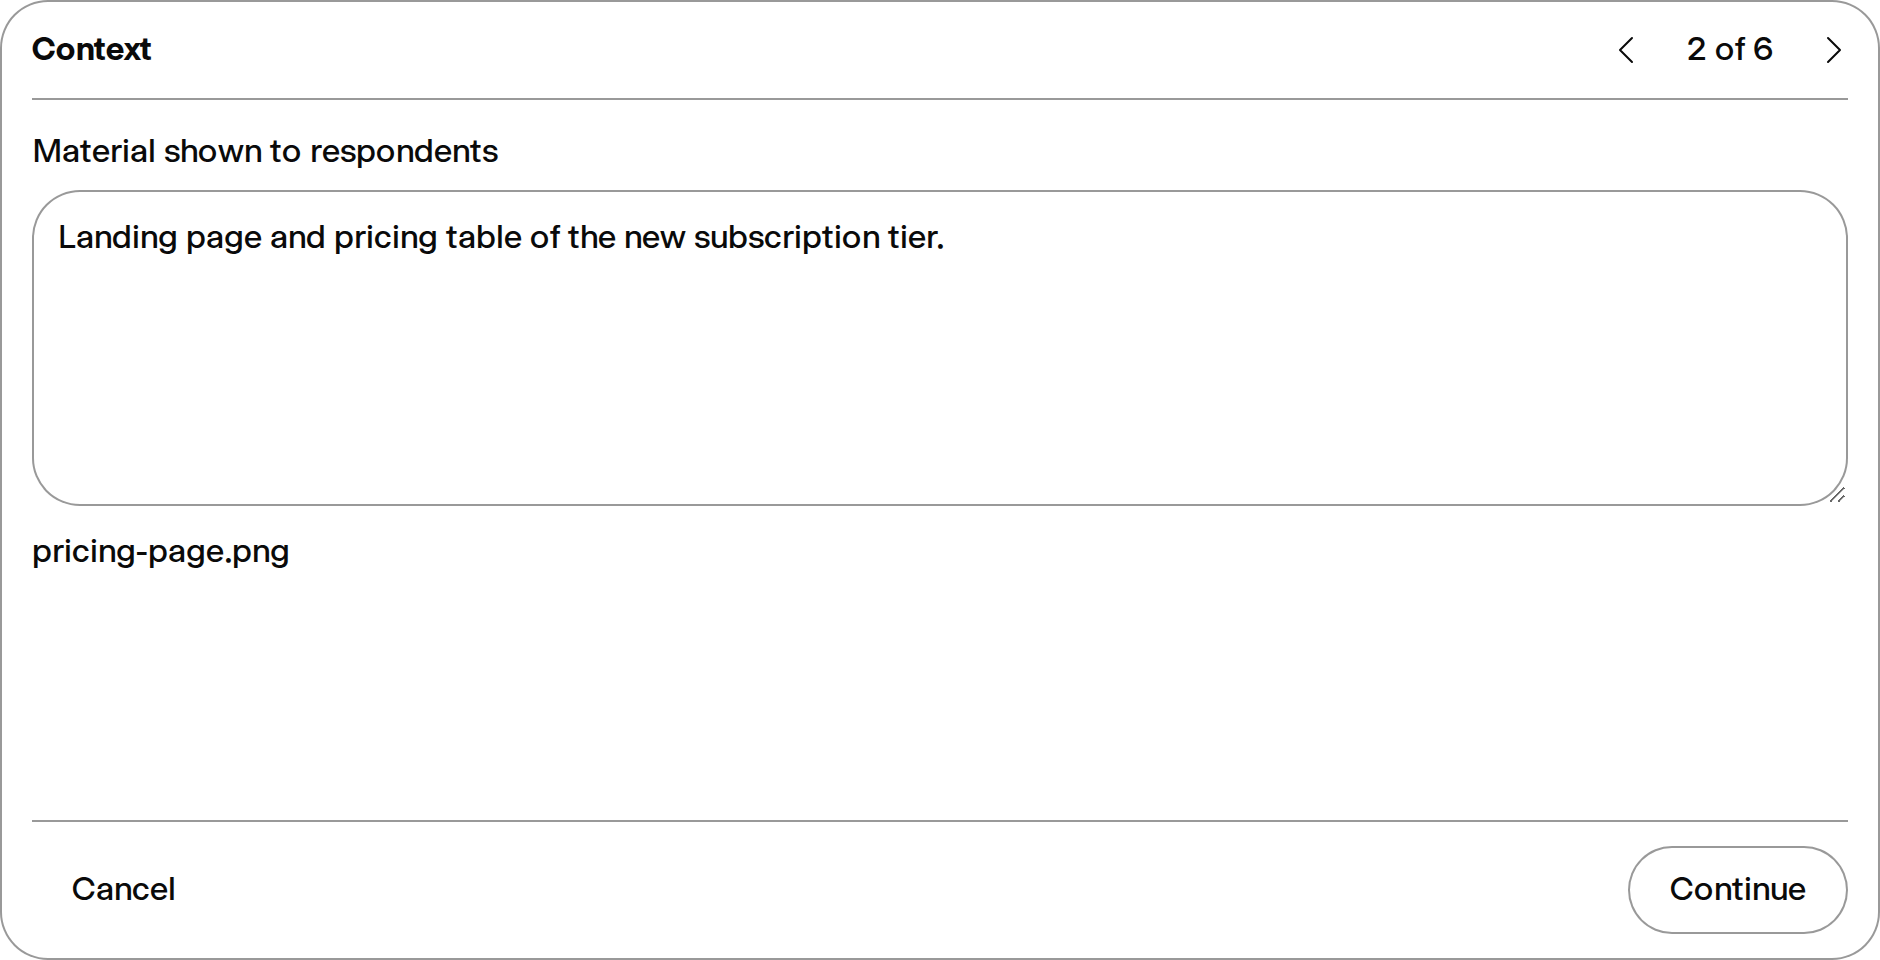
Context step carrying the brief and the attached file
Complétude d'une Étude terminéeUne Étude terminée énonce aussi son propre niveau de complétude. Lorsqu'une question échoue, l'Étude conclut à partir des questions qui ont bien obtenu une réponse et indique combien elles étaient, au lieu d'écarter une exécution dont les autres réponses restent valides ; relancer la question en échec reconstruit la conclusion globale au regard de ces preuves plus complètes. Une Étude qui a cessé de répondre le signale avec le nombre de réponses collectées et peut, sur demande, être conclue à partir de celles-ci, plutôt que d'afficher un état de progression sans fin. Une conclusion assemblée à partir des résultats des questions individuelles, sans synthèse complète, est identifiée comme telle.
Response coverage notice of a finished Study

Analyse et résultats

Résultats structurés qui transforment les réponses en supports de recherche exploitables.

FonctionnalitéDescription
Résultats de méthode et analyseLes résultats de méthode déterministes s'ouvrent dans une fenêtre Analyse unique, avec le calcul, un tableau de validité et d'approximation, ainsi que la limite permanente de chaque méthode à côté de ses chiffres.
Capacités incluses
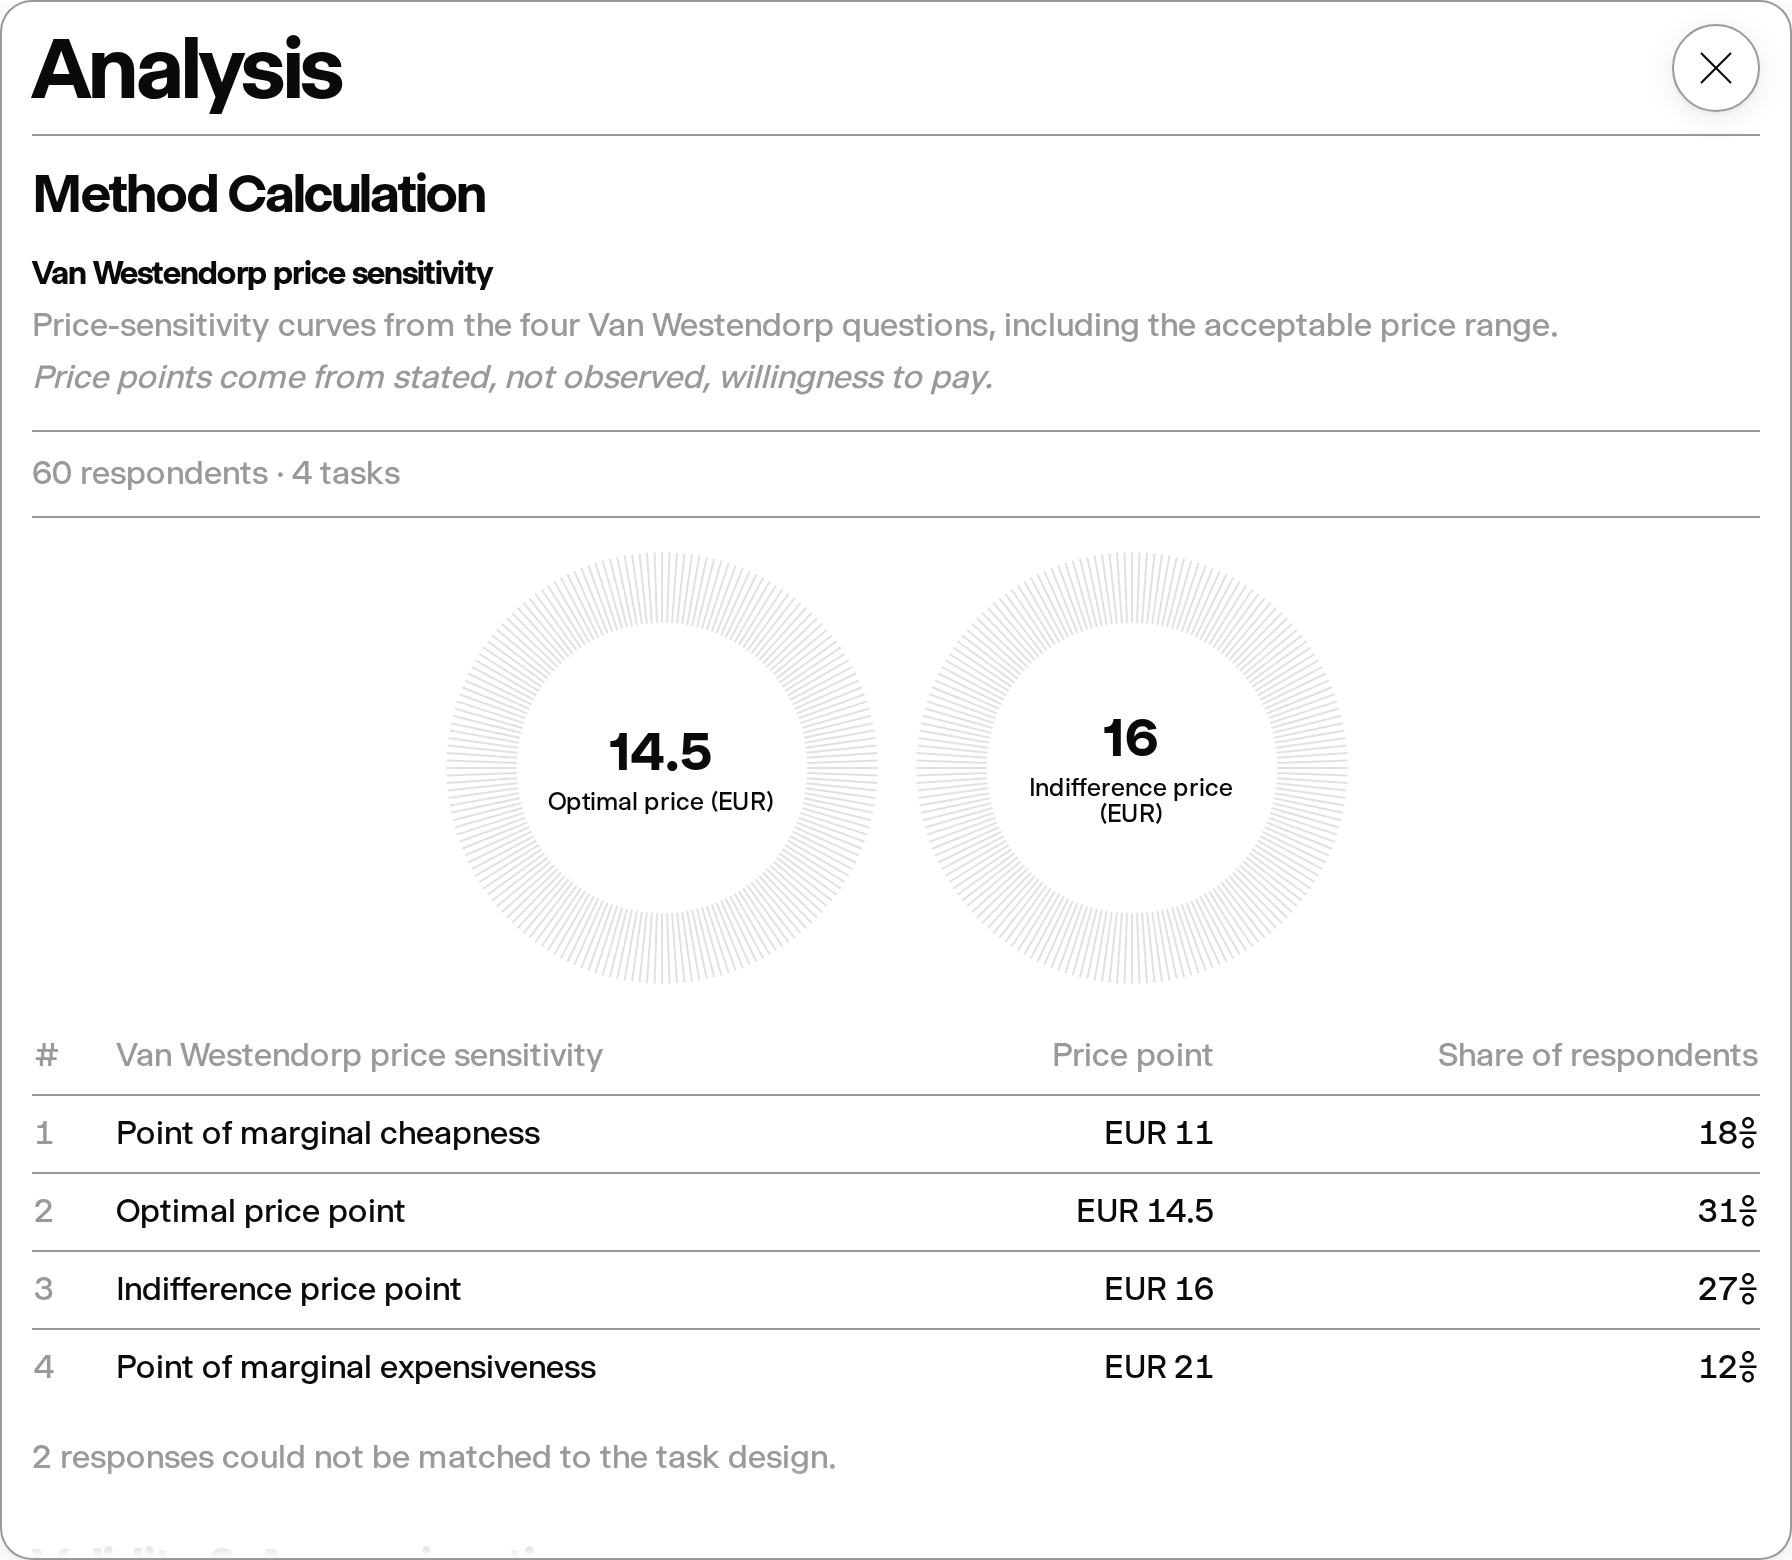
Fenêtre AnalyseOuvrez les résultats de méthode déterministes dans la fenêtre Analyse au style résumé, l'espace de travail restant visible derrière un arrière-plan flouté. La fenêtre présente deux tableaux uniformes : d'abord le calcul de la méthode, puis un tableau de validité et d'approximation avec la correspondance de personnalité et de distribution par question, chaque titre de section étant expliqué au survol. Chaque méthode adossée à un calculateur, MaxDiff, NPS, top/bottom box, facteurs clés, TURF, Gabor-Granger, Van Westendorp, Kano, préférences classées et comparaison de segments, déclare ses propres colonnes de tableau, métriques principales, étiquettes de catégorie et notes de résultat dans la même fenêtre, y compris les notes de significativité par paires entre groupes pour la comparaison de segments, le top/bottom box, le NPS et les préférences classées. Chaque ligne d'Audience porte l'icône d'Audience Minds et bascule le tableau vers le calcul de cette Audience.
Analysis modal with the method calculation
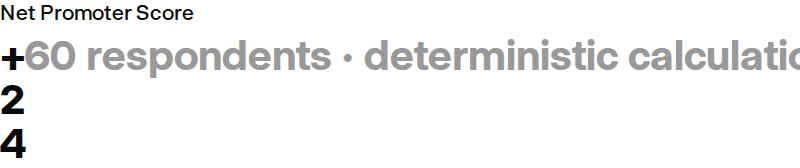
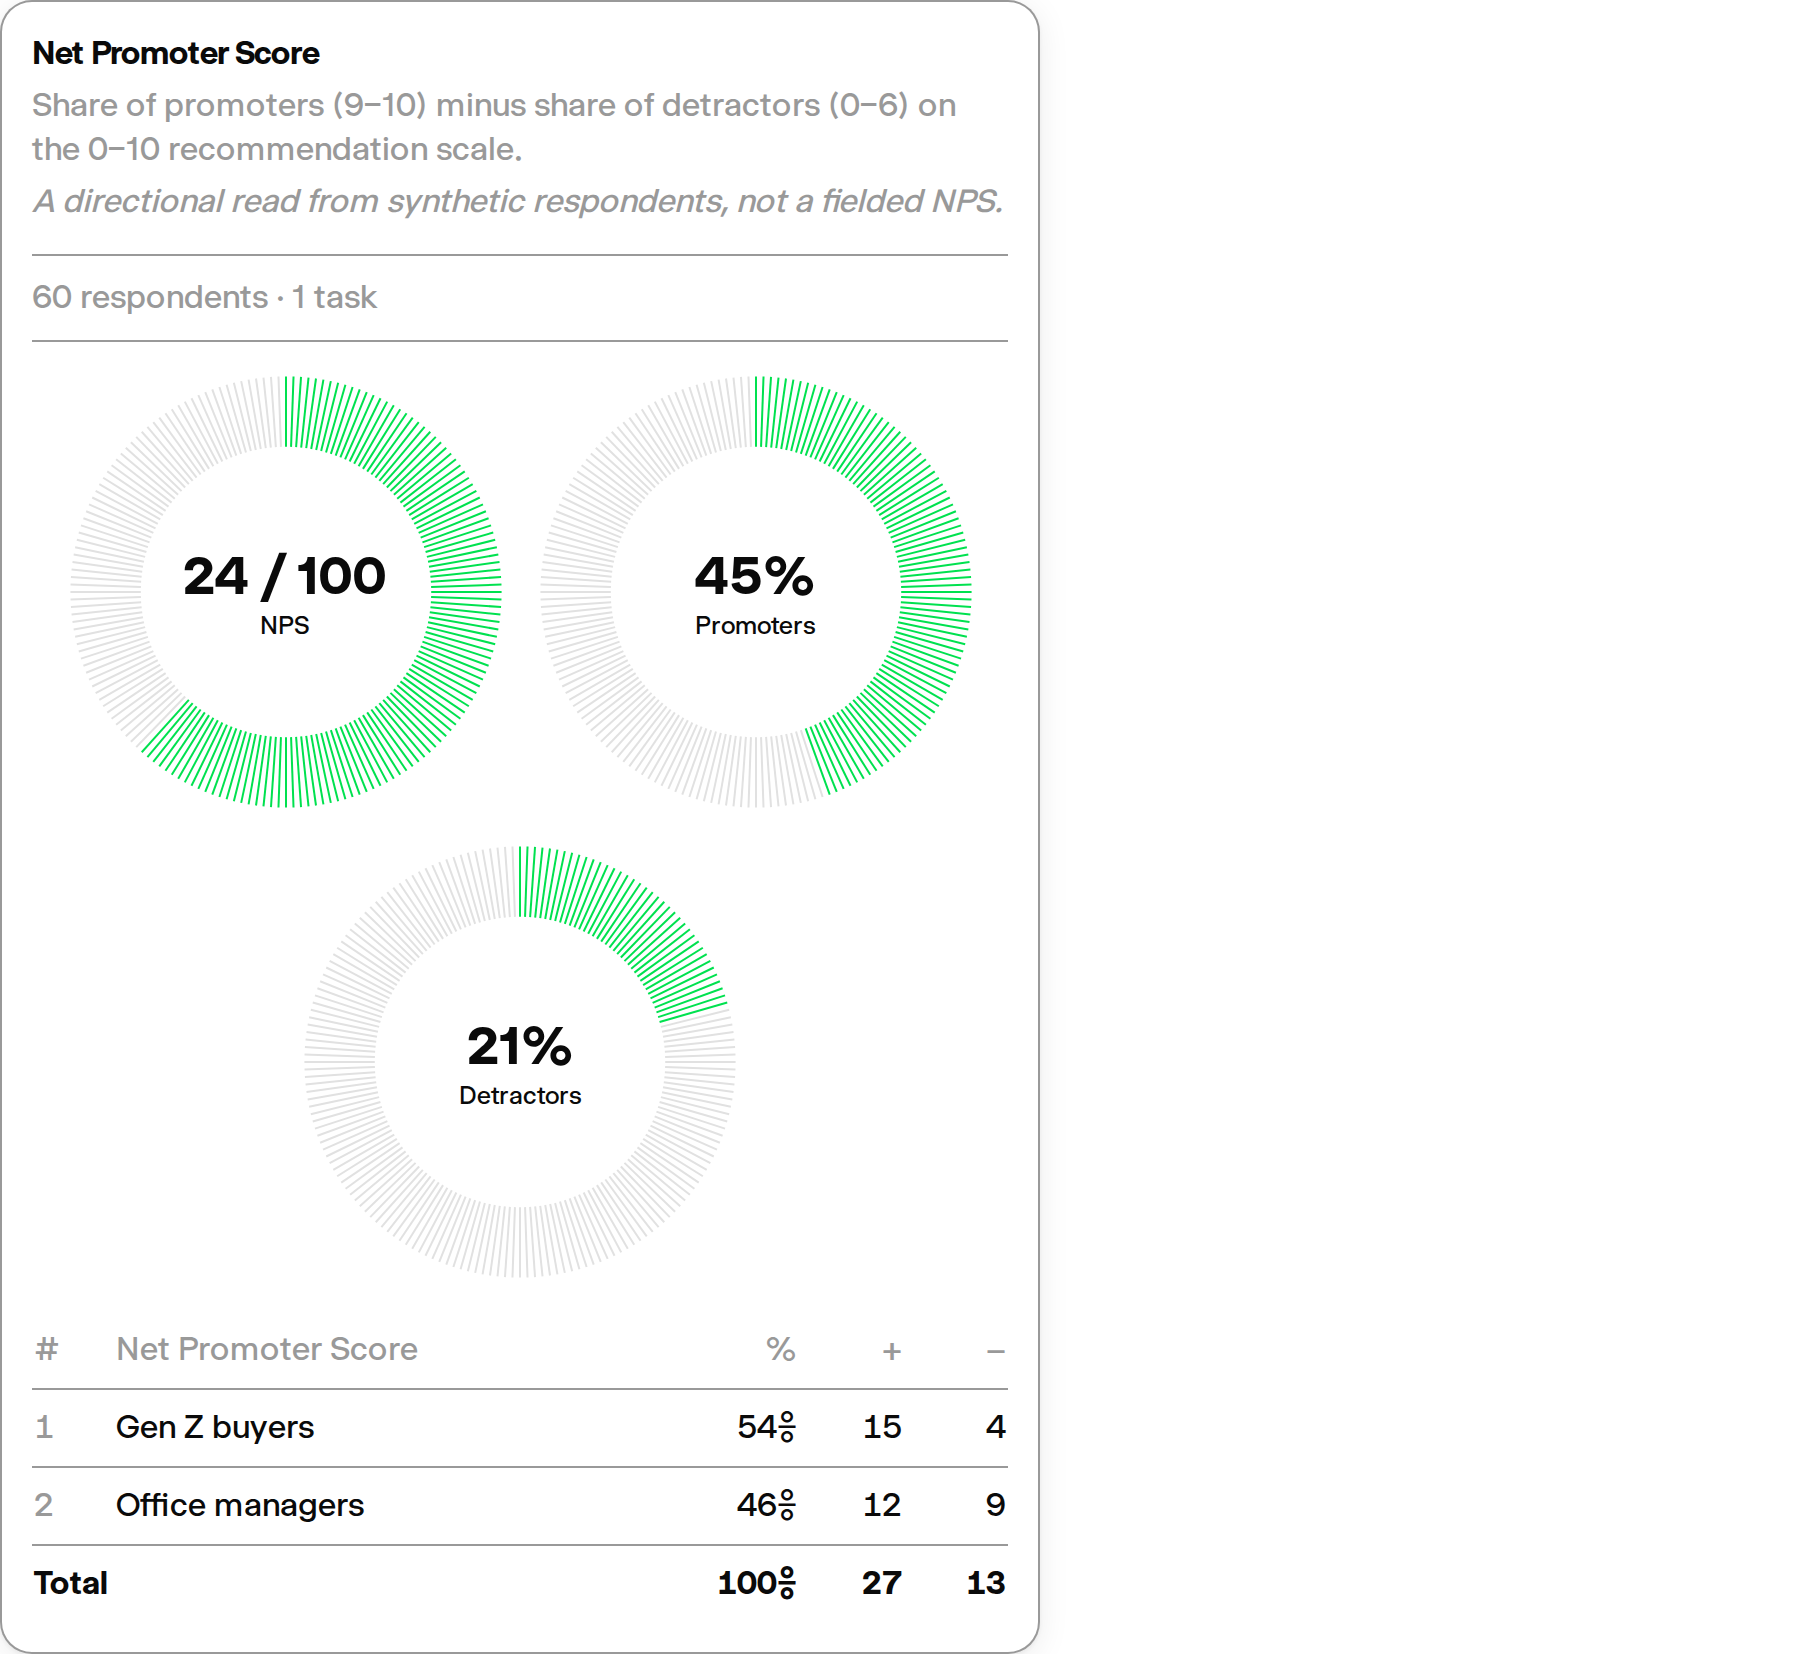
Limites et échelles honnêtesChaque méthode énonce aussi sa limite permanente à côté de ses chiffres, ce que le résultat n'est pas, et pas uniquement dans le résumé généré, et les facteurs clés indiquent si chaque facteur tire le résultat vers le haut ou vers le bas, l'importance étant en elle-même non signée. Les scores principaux reprennent le graphique en anneau de recherche standard sur leur échelle honnête, par exemple le NPS sur sa plage de −100 à 100, et les tableaux n'ajoutent des lignes de pied Total ou Moyenne que là où les lignes s'additionnent réellement en un tout, déclaré colonne par colonne, afin qu'une taille d'échantillon par ligne ne soit jamais totalisée en un chiffre supérieur à celui du panel.
NPS card on its -100 to 100 scale with the standing limitation
Changement de méthode fiableLe choix d'une méthode n'est validé qu'une fois qu'un plan correspondant est renvoyé, de sorte que le sélecteur n'affiche jamais une méthode que l'Étude n'exécutera pas réellement, et un changement en échec conserve la méthode précédente au lieu de ramener discrètement l'Étude vers la recherche personnalisée lors d'une nouvelle tentative. Une méthode dont la configuration est presque correcte est réparée avant l'exécution de l'Étude plutôt que rétrogradée en exécution qualitative, afin que le calcul déterministe soit tout de même produit au lieu de disparaître en silence. Un déploiement survenant pendant l'exécution d'une Étude laisse la page en place : la nouvelle version est prise en compte à la navigation suivante, une fois l'exécution stabilisée, et passer à une méthode de choix forcé réécrit les questions dans la forme propre à cette méthode au lieu d'échouer sur des questions rédigées pour la méthode précédente. Une Étude dont la méthode déclare un calcul déterministe le calcule également pour les exécutions à question unique, et son résultat reste en état de chargement jusqu'à ce que ce calcul soit prêt, de sorte qu'ouvrir immédiatement la fenêtre Analyse affiche toujours le tableau de la méthode.
Method row marked not available yet
Agrégation des réponsesAgrégez les réponses à échelle, catégorielles et qualitatives en distributions, moyennes et thèmes, lorsque le type de question le permet.
Scale overview from 1 to 10 with the share of answers per point and the average
Catégories de réponse canoniquesLes réponses ouvertes sont codées selon une grille de codage versionnée comportant définitions, règles et extraits justificatifs exacts : il s'agit d'une analyse de contenu automatisée avec revue par le modèle, et non d'une validation intercodeurs humaine.
Capacités incluses
Grille de codageCatégorisez les réponses qualitatives à partir de leur texte enregistré complet, à l'aide d'une grille de codage versionnée comportant des définitions, des règles d'inclusion et d'exclusion ainsi que les extraits justificatifs exacts. Les formulations équivalentes partagent une même catégorie tandis que les affirmations opposées restent distinctes. Les pourcentages de catégorie principale conservent une voix par réponse ; les codes secondaires restent attachés à la réponse.
Coded categories with a representative quote each
Études volumineuses et réponses non codéesLe codage s'exécute par lots bornés pour les études volumineuses, les affectations ambiguës ou en échec étant affichées comme non codées.
Coding notice with uncoded answers
Recoder des résultats enregistrésLes propriétaires et les collaborateurs peuvent recoder les résultats de questions existants sans régénérer les réponses ; la version d'origine et les révisions de catégories récentes sont conservées.
Portée et variantes A/BIl s'agit d'une analyse de contenu structurée et automatisée, avec revue par le modèle plutôt que validation intercodeurs humaine. Les tests A/B conservent les variantes téléversées comme espace de réponse fixe, y compris les variantes ne recueillant aucune sélection.
Synthèses d'ÉtudeGénérez à la demande des synthèses évolutives d'une Étude, avec des thèmes mis en avant et des graphiques de synthèse, et actualisez-les au fil de l'Étude.
Study summary prose with the headline finding in bold
Exports structurésExportez les réponses, les transcriptions, les résultats d'Étude et les synthèses de direction au format Markdown, JSON, PDF, Word aux couleurs de votre marque ou PowerPoint 16:9, et les données brutes au format SPSS SAV, CSV et XLS.
Capacités incluses
Synthèses de direction et rapports d'ÉtudeLes synthèses de direction sont disponibles en PDF, en Markdown modifiable et en documents Word, ainsi que sous forme de présentation PowerPoint 16:9 pensée pour les diapositives, présentant la conclusion pour la direction, les indicateurs, les groupes participants, jusqu'à quatre constats étayés par des preuves, les facteurs de décision, la méthodologie et les sources. Les rapports d'Étude complets utilisent la même structure de présentation d'insights 16:9 en PDF et en PowerPoint, accompagnés de versions Markdown et Word au texte redistribuable.
Profils de personas et briefs d'AudienceLes profils de personas et les briefs d'Audience utilisent le même système pensé pour les diapositives, avec leur propre identité, leurs traits ou leur composition, les Minds participants, la méthodologie et la hiérarchie des sources.
Un seul menu de partage et d'exportLa commande Exporter au niveau d'une réponse et l'action Partager du résumé ouvrent le même menu Partage et export à l'échelle de l'Étude que la commande de l'en-tête.
Result actions with Export
Données brutesExportez les productions de recherche prises en charge, telles que les réponses, les transcriptions, les résultats d'Étude et les synthèses de direction, au format Markdown, JSON, PDF ou en documents Word aux couleurs de votre marque, y compris les exports de Minds et d'Audiences avec leurs sources et avertissements lorsqu'ils sont disponibles. Les données brutes d'une Étude sont disponibles en SPSS SAV natif, ainsi qu'en CSV et XLS.

Collaboration

Fonctionnalités d'espace de travail d'équipe pour l'usage partagé et l'administration.

FonctionnalitéDescription
Espace de travail d'équipe partagéTravaillez depuis un espace de travail partagé pour les Minds, Audiences, Études et supports de recherche détenus par l'équipe. Les propriétaires d'Audience, les collaborateurs invités et les membres de l'espace de travail Pro partagé peuvent modifier les informations ordinaires de l'Audience, les paramètres de partage et la couverture Marketplace ou les logos autorisés ; les utilisateurs publics ou disposant uniquement d'un accès via une Étude restent en lecture seule, tandis que les opérations destructives, de contrôle d'accès, de vérification et de facturation conservent des autorisations plus strictes.
Gestion des sièges et des rôlesGérez les sièges d'équipe, les accès et l'administration de l'espace de travail pour l'équipe du client.
Capacités incluses
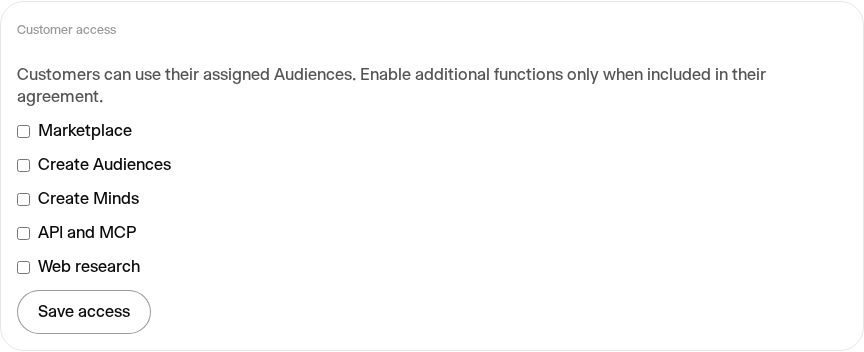
Intégration des clients gérée par les partenairesLes partenaires habilités peuvent créer des espaces clients distincts, attribuer des Audiences et limiter les fonctions uniquement pour leurs propres clients. Les forfaits contractuels comprennent des places achetées, des bonus Early Bird temporaires et des quotas mensuels de réponses séparés ; la facturation indique la licence interne et les frais nominatifs des clients payés par le partenaire.
Partner customer onboarding controls
Utilisation d'équipe mutualiséeMutualisez les contingents de réponses entre les sièges afin que l'utilisation de l'équipe puisse être gérée à l'échelle de l'espace de travail.
Partage d'Étude et accès invitéPartagez une Étude par lien ou invitez-y un client ou une partie prenante ; les invités peuvent poser leurs propres questions à votre Audience, même avec un compte gratuit, et leur utilisation est décomptée de votre allocation.
Capacités incluses
Liens de partage, publication et exportPartagez une Étude par lien, publiez-la ou dépubliez-la explicitement, et exportez-la depuis le même menu de partage ; la publication et les actions destructrices demandent toujours une confirmation.
Share menu with link sharing and e-mail invitations
Questions des invités sur votre allocationInvitez un client ou une partie prenante dans une Étude dont vous êtes propriétaire et laissez-le poser ses propres questions à votre Audience, même avec un compte gratuit. Ses questions sont décomptées de votre allocation de réponses et non de la sienne, de sorte qu'aucune limite de forfait de l'invité ne s'interpose entre lui et l'Étude que vous avez partagée. L'utilisation est enregistrée sur votre espace de travail, l'invité restant l'auteur de ses propres questions.
Invitation input for a client or stakeholder

Intégrations

Accès programmatique et surfaces de workflow connectées.

FonctionnalitéDescription
Comptes connectésConnectez les outils où vit votre matériel et apportez-le dans une Étude, une Audience ou la base de connaissances d'un Mind sans le téléverser de nouveau : stockage cloud, fichiers de design, comptes publicitaires et tickets produit.
Capacités incluses
Google Drive et OneDriveJoignez des fichiers depuis un stockage cloud connecté tel que Google Drive ou OneDrive dans le champ de saisie de l'Étude, lors de la création d'une Audience et dans la base de connaissances d'un Mind, avec l'accès fichier par fichier que vous accordez dans le sélecteur.
Attachment source picker with Google Drive and OneDrive
Designs FigmaLà où cette option est activée, collez le lien d'un fichier ou d'un cadre Figma dans une Étude pour utiliser le design comme stimulus.
Comptes Meta AdsLà où cette option est activée pour le forfait souscrit, connectez un profil Meta depuis les Paramètres pour choisir un compte publicitaire autorisé et importer directement dans une Étude des textes, images et vidéos publicitaires existants. L'intégration utilise un stockage chiffré des jetons OAuth, conserve une piste d'audit des imports et demande un accès en lecture seule, de sorte que Minds ne peut pas créer, modifier, publier, mettre en pause ni supprimer des publicités Meta.
Meta Ads connection row
Tickets LinearConnectez Linear et joignez un epic ou un PRD dans le champ de saisie de la conversation, en le choisissant parmi les tickets récents ou en collant le lien d'un ticket, afin de mener une recherche auprès d'un panel à son sujet. Le ticket est importé en lecture seule sous forme de document markdown avec sa description, ses métadonnées et ses commentaires récents, et il est ingéré comme n'importe quel PRD téléversé. Avec l'agent d'espace de travail @Minds installé, mentionnez @Minds sur un ticket pour obtenir un plan de recherche dans le fil, le confirmer et recevoir les résultats du panel directement sur le ticket.
Linear connection row
Tickets JiraConnectez Jira et joignez un epic ou un PRD dans le champ de saisie de la conversation, en le choisissant parmi les tickets récents ou en collant le lien d'un ticket, afin de mener une recherche auprès d'un panel à son sujet. Le ticket est importé en lecture seule sous forme de document markdown avec sa description, ses métadonnées et ses commentaires récents, et il est ingéré comme n'importe quel PRD téléversé.
Jira connection row
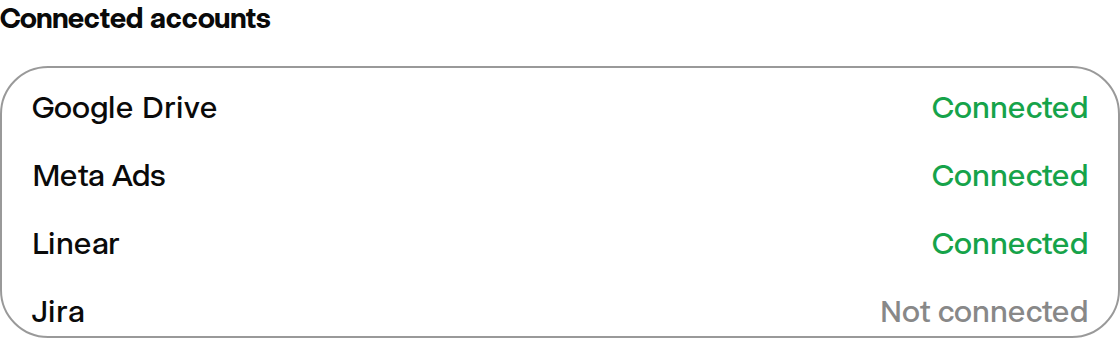
Vue d'ensemble des intégrationsParcourez et recherchez les intégrations Minds dans une vue d'ensemble complète de l'espace de travail, ouverte depuis la barre latérale ou les Paramètres. Les cartes sont regroupées en comptes connectés, assistants IA, données et reporting, outils pour sites web et intégrations à venir. Les cartes disponibles ouvrent une fenêtre de configuration avec des commandes de connexion ou des instructions. L'état de connexion en direct s'affiche pour les comptes pris en charge ; l'accès dépend de l'intégration et du forfait.
Connected accounts section
Intégration MCPConnectez des clients et agents IA compatibles aux flux de travail Minds via le Model Context Protocol, dans les mêmes limites que l'API publique.
Capacités incluses
Minds, Audiences et Études via MCPLes opérations de cycle de vie fondamentales pour les Minds, les connaissances, les Audiences, les Formations, les Études, les conversations et les brouillons d'étude respectent les mêmes limites applicatives que l'API publique. Les Études existantes peuvent être exportées, explicitement publiées ou dépubliées par lien, et partagées avec des collaborateurs invités ; les actions de publication conservent leurs annotations de risque et les outils destructifs exigent une confirmation explicite, tandis que la création et la rotation des identifiants d'API restent dans les paramètres de compte authentifiés.
Exécutions d'Étude durablesLes questions d'Étude renvoient un identifiant d'exécution durable au lieu de dépendre d'un seul processus MCP ou d'un flux ouvert ; le statut est lu depuis le registre partagé adossé à la base de données, au fil des reconnexions, des redémarrages et des instances MCP mises à l'échelle horizontalement.
Widgets de plan dans les hôtes MCPLes widgets de plan sur ordinateur utilisent six étapes : Objectif, Contexte, Audiences, Méthode, Questions et Revue. Vous pouvez modifier l'objectif, le matériel de répondants collé, ainsi que les questions, options, échelles, ordre et affectations de matériel pris en charge. L'enregistrement crée une nouvelle révision de brouillon sans régénération par l'IA ; le démarrage de la recherche exige une confirmation distincte de cette révision enregistrée dans la conversation. Le widget affiche Enregistrer et examiner pour les modifications non enregistrées et ne comporte pas de bouton Lancer l'Étude. Les batteries de questions propres à une méthode et les changements d'appartenance à une Étude existante passent par l'espace de travail. Sur mobile, l'espace de travail s'ouvre, et une Étude lancée y renvoie pour la progression et les résultats.
Plan widget on the Method step with Save and review
Extensions de navigateur et widgetsUtilisez les extensions de navigateur et les widgets MCP pris en charge pour intégrer Minds à des flux de travail externes ou à des interfaces destinées à vos clients. Les widgets de création, de statut, d'Audience et de réponse reçoivent leur état autorisé via l'hôte MCP, affichent leur interface dans les neuf langues prises en charge, montrent un chargeur Minds centré pendant le traitement et présentent les portraits de Minds autorisés via des URL d'image signées à durée de vie courte, sans exposer d'identifiants applicatifs dans l'iframe.
Accès APIUtilisez l'API publique pour les workflows programmatiques pris en charge de Minds, d'Audiences, d'Études et d'export.
Minds for n8nInstall n8n-nodes-minds on self-hosted n8n and connect a Minds API key. Version 0.1.0 supports Study Create, Get, Get Many, Preview Research Plan, and Get Summary, including use as an AI Agent tool. Preview saves a plan draft; review and start research separately in Minds. The package is published on npm; n8n verification is under review and n8n Cloud installation is not yet available.
Minds pour Google SheetsUtilisez une feuille de calcul comme file d'attente de recherche. Sélectionnez les lignes dont la première colonne contient des questions, choisissez une Audience existante, confirmez l'exécution : chaque réponse est écrite dans la colonne suivante. Les lignes vides conservent leur position, le module complémentaire avertit avant d'écraser des cellules de résultat et envoie jusqu'à 25 questions par exécution via le même point de terminaison MCP de Minds que les autres intégrations prises en charge.
Analyses d’études pour Looker StudioConnectez une étude existante à Looker Studio comme source de données réutilisable pour des rapports, des revues récurrentes et des tableaux de bord partagés. Le connecteur s'authentifie avec une clé d'API, lit les analyses en direct de l'ID d’étude saisi et ne modifie jamais l’étude.
Intégrations personnaliséesCadrez des intégrations propres au client pour les workflows d'entreprise, les systèmes internes ou les stacks analytiques.

Sécurité et contrôles Enterprise

Contrôles généralement configurés pour les grandes équipes et les déploiements pilotés par les achats.

FonctionnalitéDescription
Single Sign-OnConfigurez une connexion SAML 2.0 gérée par le client via Supabase Auth, avec Microsoft Entra ID ou Okta, tandis que le fournisseur d’identité conserve le MFA et Conditional Access.
Connexions de modèles pour les équipesLorsque cette fonction est activée dans un espace Pro, les administrateurs peuvent enregistrer des identifiants chiffrés pour des endpoints HTTPS publics utilisant OpenAI Chat, OpenAI Responses ou Anthropic Messages. Vérifiez les capacités avant de choisir une connexion pour les requêtes des Minds ou des Études. Les tâches en attente conservent la révision choisie ; une connexion indisponible échoue sans changer de modèle. Les analyses auxiliaires utilisent toujours les modèles Minds et les frais du fournisseur sont distincts. Cette version ne prend pas en charge les entrées visuelles.
SLA EnterpriseConvenez de niveaux de service, de délais de réponse du support et d'avoirs de service pour les déploiements enterprise, le cas échéant.

Services et support

Support, onboarding, validation et services propres au client.

FonctionnalitéDescription
Facturation des abonnementsLes nouveaux clients choisissent leur pays de facturation avant le paiement. Les abonnés existants conservent leurs modalités de facturation et tarifs convenus. Les propriétaires et administrateurs gèrent le même abonnement d’équipe.
Services de validation et de calibrageRéalisez des travaux de validation, d'onboarding, de calibrage ou de support à la recherche cadrés séparément, au regard de données de référence internes ou externes appropriées.
Populations synthétiques personnaliséesCréez des populations synthétiques propres au client ou à un secteur à partir des données du client, de la recherche de partenaires et de sources publiques appropriées.
Support prioritaireBénéficiez d'un support prioritaire pour les plans payants et les espaces de travail clients.
Support communautaireAccédez aux ressources de support standard en libre-service et orientées communauté.