
Minds ComfyUI: Ergebnisse, Outputs und Fehlerbehebung
Lesen Sie das Research-Widget und strukturierte Ergebnisse zusammen, leiten Sie die ausgewählten Originalmedien weiter und analysieren Sie, welche Phase Ihren Graph gestoppt hat. Diese Referenz behandelt Gleichstände, mehrere Zielgruppen, Input-Limits und persistente Retries.
Minds · Audience Preferences liefert eine Research-Response und eine Reihe von Graph-Outputs zurück. Die Response hilft Ihnen zu verstehen, was die ausgewählten Zielgruppen bevorzugt haben. Über die Outputs können Sie dieses Ergebnis festhalten und mit den ausgewählten Originalmedien weiterarbeiten. Ein abgeschlossener Präferenztest bedeutet jedoch nicht automatisch, dass jeder Output-Port ein natives Bild oder Video zur Weitergabe bereitstellt.
Diese Referenz setzt voraus, dass das Paket installiert ist und der Server über MINDS_API_KEY verfügt. Starten Sie mit der ComfyUI-Einrichtungsanleitung, falls der Node fehlt oder Sie noch keinen ersten Test durchgeführt haben. Nutzen Sie den Leitfaden für native Videos, wenn der Graph Bewegung und Audio verarbeiten soll.
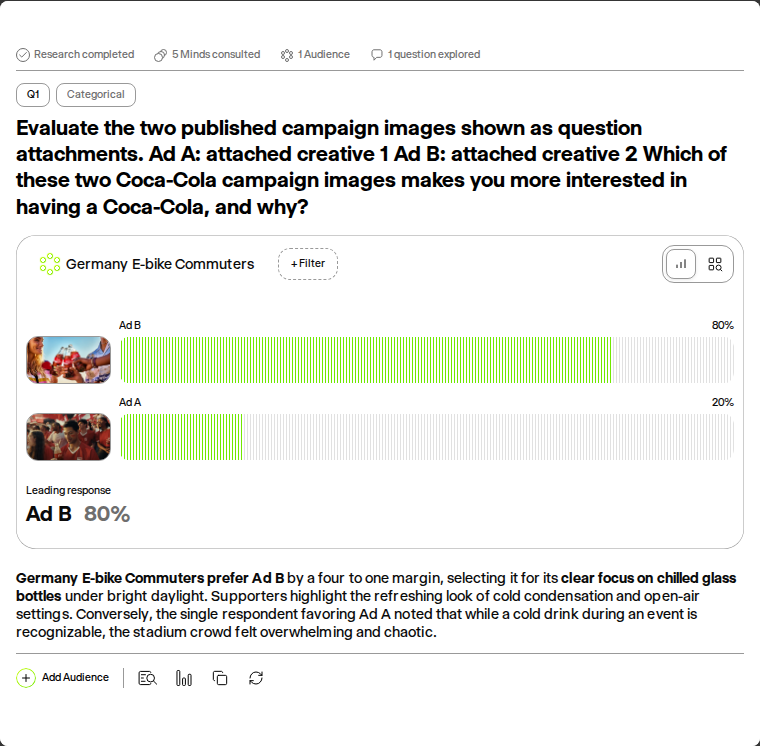
Lesen Sie Vorschaubild und Label gemeinsam: Ad A ist das Fußball-Kampagnenbild, Ad B zeigt Share a Coke. Die abgeschlossene Verteilung enthält eine Stimme für A und vier für B, weshalb das Widget 20 % und 80 % anzeigt. Die Detailaufnahme umfasst die Erklärung und die untere Aktionsleiste. Im zugehörigen Workflow erreicht das Originalbild B den Save-Image-Node. Die fünf QA-Antworten belegen, dass Anzeige und Auswahl übereinstimmen, nicht die Gültigkeit einer Marktschätzung. Kampagnenquellen: Coca-Cola football, Share a Coke.
Bewegen Sie den Mauszeiger über das Ergebnis und scrollen Sie mit dem Mausrad oder mit zwei Fingern auf dem Trackpad zu den Erkenntnissen und den unteren Bedienelementen. Der Graph bleibt dabei stehen. Die höhere Dokumentationsaufnahme zeigt das gesamte Ergebnis auf einmal.
Das Widget als Research-Response interpretieren
Das eingebettete Widget nutzt dieselbe Minds-Response-Oberfläche, die auch in MCP-Clients verwendet wird. Abhängig von der abgeschlossenen Response kann es die Fragestellung, die ausgewählte Zielgruppe, die kategoriale Verteilung, zentrale Erkenntnisse und verfügbare Antworten einzelner Minds anzeigen. Scrollen Sie im Ergebnisbereich, um die gesamte Response zu prüfen, anstatt nur den höchsten Balken abzulesen.
Prüfen Sie zuerst die Fragestellung. Kontext, Kandidatenreferenzen und die formulierte Frage werden im gespeicherten Präferenz-Instrument zusammengeführt. Ein Ergebnis für ein Website-Intro kann nicht automatisch beantworten, welches Creative in einem stummen Social-Media-Feed gewinnt. Überprüfen Sie anschließend die Zielgruppe und die Bezeichnungen der Alternativen. Diese definieren die Population und das Auswahlspektrum, für die das Ergebnis gilt.
Lesen Sie die Erkenntnisse und verfügbaren Antworten parallel zur Verteilung. Sie können dabei helfen, relevante Aspekte für weitere Analysen zu identifizieren - eine plausible Erklärung ist jedoch kein eigenständiger Beweis für reales Marktverhalten. Für eine breitere qualitative Exploration, Fragebogenarbeit oder quantitative Methoden wie MaxDiff setzen Sie die Arbeit im verknüpften Study-Workflow und im Feature-Guide fort.
Minds ist die End-to-End-Plattform für kommerzielle synthetische Marktforschung, die qualitative und quantitative Methoden über Minds, Zielgruppen und Studies verbindet. Minds PRISM bildet das Fundament für Argumentation, Inferenz und Quellenmodellierung hinter jedem Mind. Dieser Adapter stellt auf dieser Basis eine fokussierte kategoriale Präferenzfrage bereit.
Die fünf Output-Ports verstehen
| Port | Typ | Verwendung |
|---|---|---|
selected_images | IMAGE-Liste | Native Originalbilder, die für die Routing-Zielgruppe ausgewählt wurden |
selected_videos | VIDEO-Liste | Native Originalvideos, die für die Routing-Zielgruppe ausgewählt wurden, einschließlich Audio |
results_json | STRING | Serialisiertes Ergebnis mit Study-/Run-Referenzen und zielgruppenspezifischen Rankings |
preference_result | MINDS_CREATIVE_RESULT | Strukturiertes Ergebnis für die Weiterverarbeitung in kompatiblen Custom Nodes |
selected_creatives | MINDS_CREATIVES | Datensätze ausgewählter Creatives, einschließlich nativem Material oder gehosteten/textuellen Referenzen |
Die Bild- und Video-Ports sind Listen-Outputs. Eine Shortlist, ein Gleichstand oder ein ausgewähltes Set kann mehrere Elemente enthalten. Stellen Sie sicher, dass der nachgelagerte Node den nativen Typ und das Listenverhalten Ihres ComfyUI-Workflows unterstützt. Diese benutzerdefinierten Outputs sind keine generischen Strings; verbinden Sie daher einen Node, der den entsprechenden Typ verarbeiten kann.
Die Ergebnis-Ports bleiben auch dann nützlich, wenn für eine bestimmte Modalität keine nativen Medien vorliegen. Beispielsweise kann ein Textkonzept-Vergleich ein valides Ergebnis und ausgewählte Konzeptdatensätze liefern, ohne Bilder zu erzeugen. Ebenso werden gehostete Videoreferenzen nicht automatisch zu nativen VIDEO-Objekten, nur weil ihr MIME-Typ video/mp4 lautet.
Was in results_json enthalten ist
Das JSON enthält studyId, runId, reviewUrl, question, audiences, creativeFingerprint und interpretation. Es verknüpft die Präferenz mit der gespeicherten Studie und dem exakten Creative-Set. Behalten Sie diese Referenzen bei, wenn Sie eine Entscheidung dokumentieren, damit Sie nachvollziehen können, welcher Durchlauf und welche Alternativen als Grundlage dienten.
Jeder Zielgruppen-Eintrag enthält seine audienceId, den Anzeigenamen, ranking, winners, optionale estimation-Daten der API und confidence. Jedes Ranking-Element umfasst label, index, share und rank. Der Anteil (share) ist ein Dezimalwert der gesamten Ergebnisverteilung und kein Prozent-String. Ein Anteil von 80% wird als 0.8 dargestellt.
Kandidaten-Indizes sind nullbasiert und beziehen sich auf die zusammengestellte Creative-Reihenfolge. Das winners-Array enthält Indizes mit Rang 1, einschließlich Gleichständen. Verwenden Sie Labels zusammen mit Indizes und dem Fingerprint, wenn Sie ein Ergebnis prüfen oder weiterleiten. Die Eingabeposition allein ist kein Beleg dafür, dass ein Kandidat bevorzugt wurde.
Der Adapter normalisiert die zurückgegebene kategoriale Verteilung und sortiert sie absteigend nach Anteil. Er belässt confidence bei null; er berechnet weder ein ungestütztes Konfidenzintervall noch Signifikanzwerte oder Conversion-Prognosen. Wenn Sie eigene nachgelagerte Automatisierungen aufbauen, behalten Sie diese Unterscheidung bei, anstatt Präferenzen fälschlicherweise als gemessene Effektivität zu deklarieren.
Zielgruppen vergleichen, ohne sie zusammenzulegen
Jede ausgewählte Zielgruppe behält ihre eigene Präferenzverteilung und ihr eigenes Ranking. Wenn Zielgruppe A eine Variante bevorzugt und Zielgruppe B eine andere, erfasst das Ergebnis beide. Der Node führt sie nicht zu einer Gesamtpopulation mit erfundenen Gewichtungen zusammen.
Wenn exakt eine Zielgruppe ausgewählt ist, kann deren Ranking die Medienauswahl direkt steuern. Bei mehreren Zielgruppen tragen Sie eine enthaltene Zielgruppen-ID in selection_audience_id ein. Dies bestimmt die Population, deren Präferenz die ausgewählten Creative-Outputs steuern soll. Die Forschungsergebnisse der anderen Zielgruppen bleiben davon unberührt.
Ohne diese Routing-Auswahl können das Widget und results_json die abgeschlossene Studie weiterhin anzeigen, während das Medien- und Creative-Routing blockiert bleibt. Das ist das erwartete Verhalten. Prüfen Sie zuerst die Segmentunterschiede und entscheiden Sie dann, welche Zielgruppe diesen Zweig Ihres Produktions-Workflows steuern soll.
Eine Zielgruppen-ID außerhalb des Tests wird abgelehnt. Ein Anzeigename ist kein Ersatz für die ID. Konsultieren Sie den Zielgruppen-Leitfaden und das optionale Hilfswerkzeug Minds · Find Audiences, wenn Sie prüfen müssen, welche Populationen für das Server-Konto zugänglich sind.
top_k und Gleichstände interpretieren
top_k legt den Schwellenwert für die Shortlist innerhalb der Kandidatenanzahl fest. Der Node schließt Kandidaten ein, deren Anteil mindestens dem Anteil an diesem Schwellenwert entspricht. Wenn mehrere Kandidaten dort gleichauf liegen, bleiben alle ausgewählt, selbst wenn der Output mehr Elemente enthält als top_k.
Ränge basieren auf der Anzahl der Kandidaten mit einem strikt größeren Anteil. Zwei Alternativen, die gleichauf auf dem ersten Platz liegen, erhalten beide Rang 1. Gibt es zwei führende Kandidaten mit Gleichstand und eine schlechter bewertete dritte Alternative, erhält diese dritte Alternative Rang 3. Dadurch bleibt der tatsächliche Gleichstand erhalten, anstatt eine Rangfolge vorzutäuschen, die die Daten nicht hergeben.
Wenn Ihr nächster Schritt genau eine Datei erwartet, machen Sie diese Annahme in Ihrem eigenen Workflow explizit. Sie können gleichauf liegende Outputs für eine weitere Iteration beibehalten oder den Gleichstand in Minds analysieren. Der Adapter wählt nicht stillschweigend den zuerst verbundenen Kandidaten aus, nur um einen Gleichstand verschwinden zu lassen.
Der Node prüft außerdem, ob der Creative-Fingerprint mit dem gerankten Batch übereinstimmt, bevor Originale ausgewählt werden. Die Änderung eines Labels oder eines Medien-Inputs ist eine inhaltliche Forschungsänderung, nicht bloß eine kosmetische Graph-Anpassung. Starten Sie für geändertes Material einen neuen Test.
Native Outputs bewahren das Originalmaterial
Native Bildeingaben werden für die hochgeladene Forschungskopie als PNG codiert. Native Videos werden als MP4 codiert, einschließlich ihres Audios. Der ausgewählte Output verwendet den ursprünglich verbundenen Tensor oder das VIDEO-Objekt, nicht die hochgeladene Codierung oder eine aus dem Response-Widget extrahierte Vorschau.
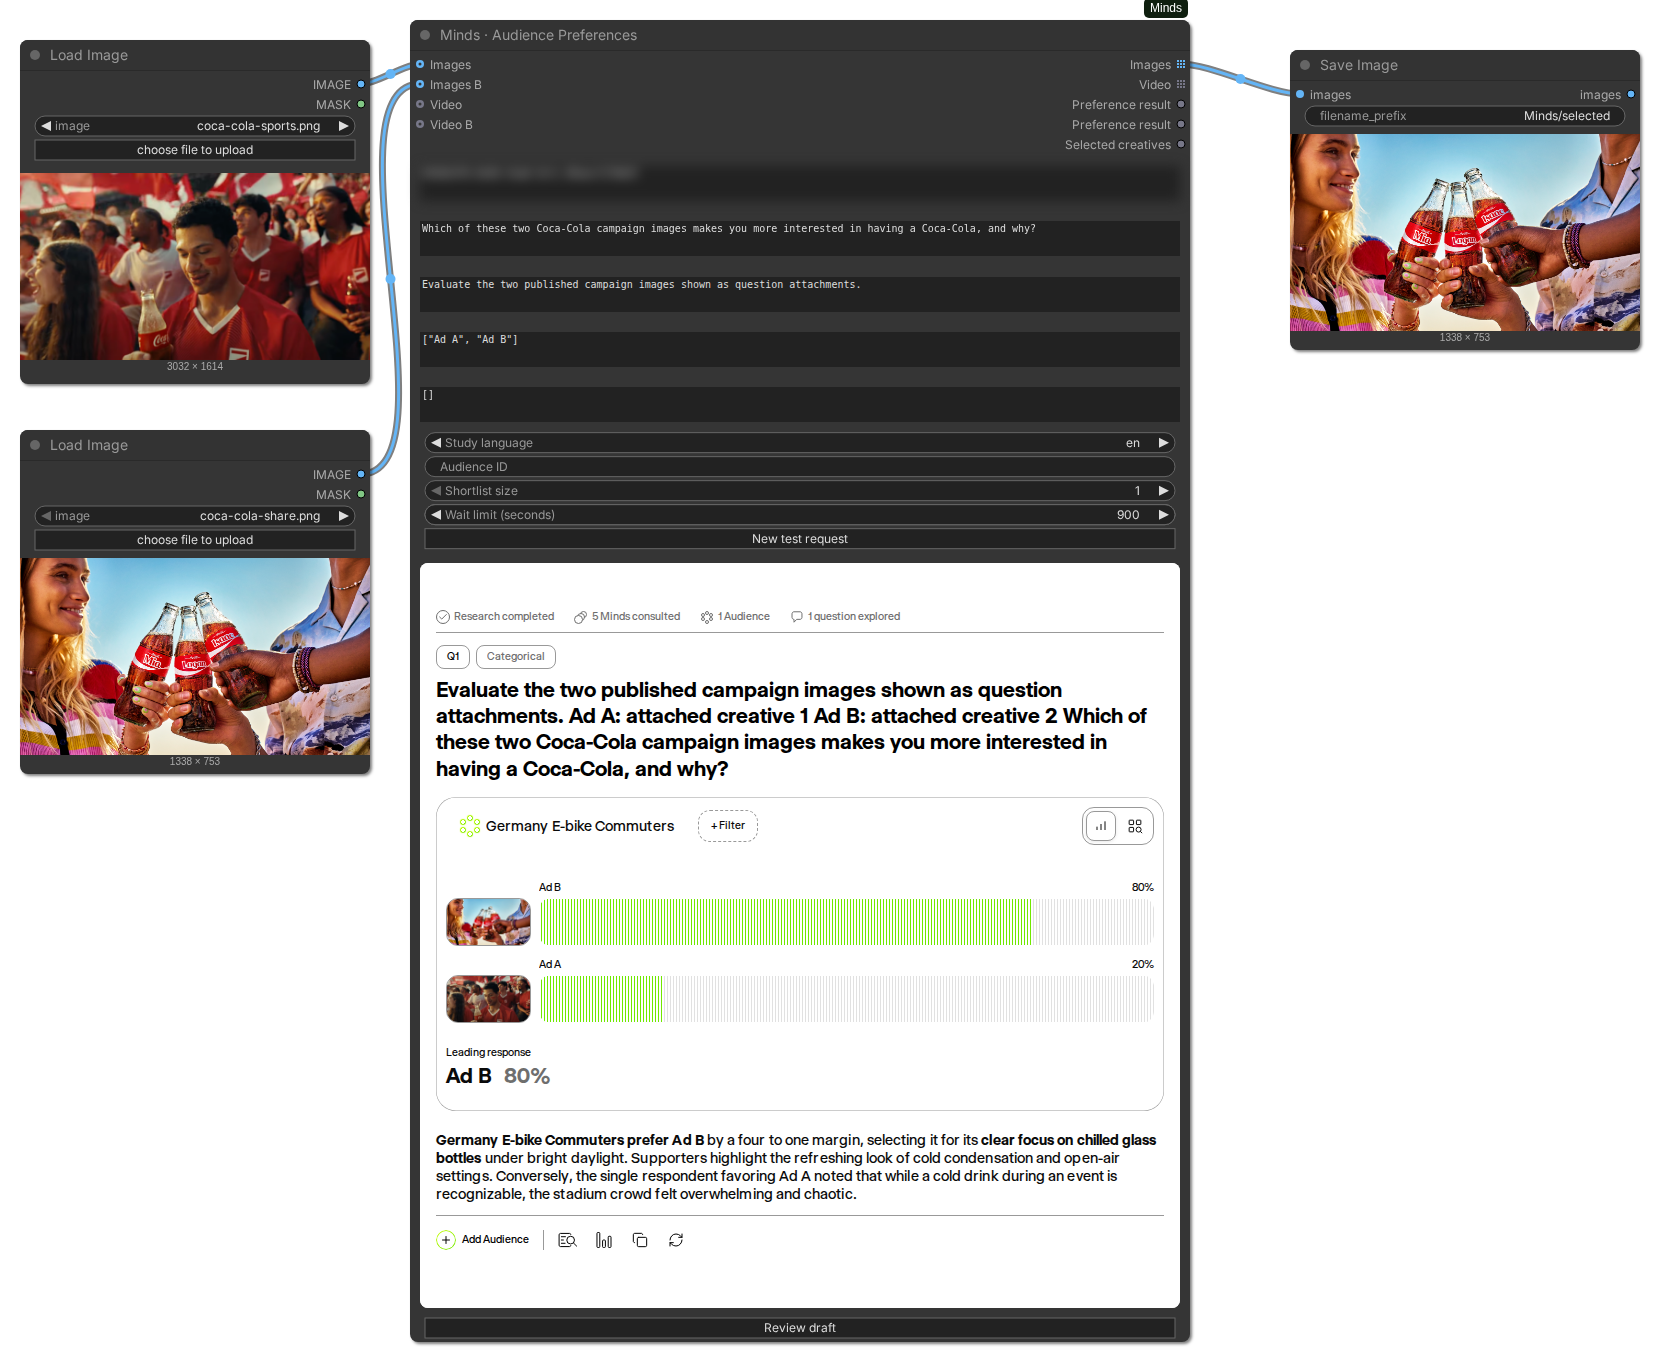
Dadurch kann Ihr Graph in der ursprünglichen Arbeitsqualität fortgesetzt werden. Der nachgelagerte Node bestimmt weiterhin, wie die gespeicherte Datei codiert und benannt wird. Überprüfen Sie dessen Einstellungen, wenn Sie ein bestimmtes Format oder Audioverhalten benötigen. Der Präferenz-Adapter kann kein Material wiederherstellen, das bereits vor der Eingabe fehlte.
Wenn ein Bild einen gemischten Vergleich gewinnt, kann selected_images nutzbar sein, während selected_videos kein ausgewähltes natives Video enthält. Wenn ein gehosteter Datensatz gewinnt, prüfen Sie die ausgewählte Referenz. Interpretieren Sie einen fehlenden nativen Output nicht als fehlgeschlagene Response, ohne vorher zu prüfen, welcher Kandidat tatsächlich gewonnen hat.
Die Phasen Vorbereitung, Prüfung und Ausführung erkennen
Beim ersten Einreihen in die Queue erstellt oder lädt der Node einen gespeicherten Study-Entwurf und öffnet dessen Prüfungsdialog. Er blockiert die nachgelagerte Ausführung, während er auf die Freigabe wartet. Prüfen Sie Frage, Alternativen, Zielgruppen und Sprache, geben Sie den exakten Entwurf frei und reihen Sie den Workflow erneut ein, um den Durchlauf zu starten.
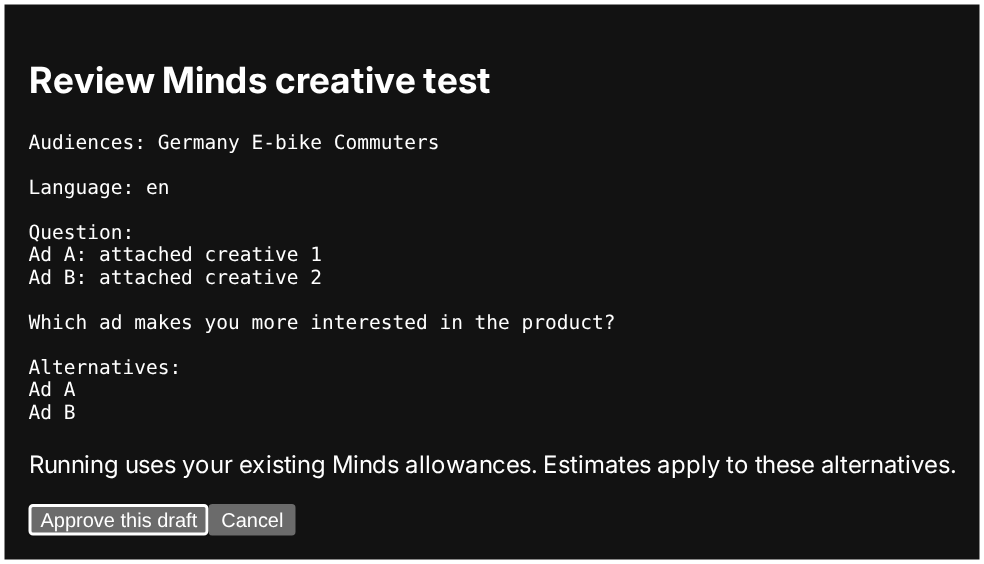
Wenn Sie die Prüfung abbrechen, ist kein Gewinner verfügbar. Wenn Sie den Entwurf freigeben, den Workflow aber nicht erneut einreihen, wird die Studie durch diese Aktion allein noch nicht ausgelöst. Die Schaltfläche Review draft öffnet die verfügbare Prüfung erneut. Sie kann keinen Entwurf anzeigen, der noch nicht vorbereitet wurde.
Der Adapter verifiziert den gespeicherten Entwurf vor der Ausführung. Geänderte Fragen, veränderte Anhänge, andere Zielgruppen oder eine neue Revision können eine vorherige Freigabe ungültig machen. Bereiten Sie den neuen Zustand vor und prüfen Sie ihn. Kopieren Sie keine Freigabewerte zwischen Workflows, um den Prüfschritt zu umgehen.
Dieselbe Anfrage wiederholen oder einen neuen Test starten
Der Node verwaltet eine Request-Identität und einen persistenten serverseitigen Beleg, der an das authentifizierte Konto gebunden ist. Ein unveränderter Wiederholungsversuch kann die gespeicherte Studie, den Entwurf und den Durchlauf wiederverwenden. Dies ist besonders nützlich, wenn nach dem Start der Studie eine Netzwerkunterbrechung oder ein lokales Polling-Timeout auftritt.
Für einen unveränderten Wiederholungsversuch reihen Sie denselben Workflow erneut ein. Behalten Sie dasselbe Material, dieselben Labels, dieselbe Frage, denselben Kontext, dieselben Zielgruppen und dieselbe Study-Sprache bei. Das Ersetzen der Server-Zugangsdaten durch ein anderes Konto gewährt keinen Zugriff auf die gespeicherte Arbeit des ersten Kontos; der Adapter prüft die Eigentümerschaft.
Verwenden Sie New test, wenn sich die Research-Inputs ändern. Dies erstellt eine neue Request-Identität und setzt die vorherige Freigabe sowie die Anzeige der Response im Node zurück. Bereiten Sie den überarbeiteten Test vor, prüfen Sie ihn und führen Sie ihn aus. Dies gilt auch dann, wenn ein vorgelagerter Generierungs-Node ein neues Bild oder Video erzeugt hat, selbst wenn der Prompt-Text unverändert geblieben ist.
Ein endgültig fehlgeschlagener oder abgebrochener Durchlauf unterscheidet sich von einem Polling-Timeout. Öffnen Sie die gespeicherte Studie, um sie zu analysieren. Das wiederholte Einreihen eines endgültigen Fehlers macht dessen unvollständige Datenbasis nicht geeignet für die Auswahl eines Gewinners.
Eingabegrenzen und Validierung
| Input | Aktueller Adapter-Vertrag |
|---|---|
| Gesamte Creative-Alternativen | 2–20 eindeutige Kandidaten |
| Creative-Labels | Eindeutig, nicht leer, jeweils maximal 200 Zeichen |
| Ausgewählte Zielgruppen | 1–100 eindeutige, kommagetrennte UUIDs, vorbehaltlich Account-Zugriff und Verfügbarkeit |
| Zusammengestellte Frage | Maximal 2.000 Zeichen inklusive Kontext, Kandidatenreferenzen und Konzepttext |
| Lokal codiertes Creative | Nicht leer, maximal 50 MB pro Upload |
| Textkonzept-Datensatz | 1–20.000 Zeichen, ebenfalls begrenzt durch das engere Limit für zusammengestellte Fragen |
| Gehostete URL | HTTPS-Dateireferenz, maximal 4.096 Zeichen, keine eingebetteten Anmeldedaten oder Fragmente |
top_k | Mindestens 1 und innerhalb der tatsächlichen Kandidatenanzahl |
| Lokales Polling-Timeout | 5–3.600 Sekunden; Standardwert 900 |
study_locale | ar, de, en, es, fr, ja, ko, tr, zh |
Diese Limits validieren die Eingaben des Adapters, garantieren jedoch nicht, dass jede Datei unterhalb des Limits oder jedes Konto denselben Test ausführen kann. Kontozugriff, Kontingente, Zielgruppenverfügbarkeit und Validierungen des Research-Dienstes gelten weiterhin. Ein separates Manifest-Textlimit berechtigt nicht zu einer Frage, die das Limit für zusammengestellte Fragen überschreitet.
Fehlerbehebung nach blockierter Phase
| Symptom | Prüfung und nächste Aktion |
|---|---|
| Node fehlt | Sicherstellen, dass das offizielle Paket im custom_nodes-Verzeichnis des laufenden Servers liegt, Abhängigkeiten mit dessen Python installiert wurden und der Server neu gestartet wurde. Importfehler der Custom Nodes prüfen. |
MINDS_API_KEY-Fehler | Das Secret in den tatsächlichen ComfyUI-Serverprozess einspeisen und den Server neu starten. Ein Key im Workflow-JSON oder in einem separaten Terminal konfiguriert den Server nicht. |
| Validierungsfehler bei Label oder Kandidat | Jedes native Bild und Video in der Reihenfolge der Collection zählen. labels_json an native Inputs anpassen und Manifest-Einträgen eigene eindeutige Labels zuweisen. |
| Entwurf erscheint und Speichern ist blockiert | Den vorbereiteten Entwurf prüfen und freigeben, dann erneut einreihen. Dies ist die reguläre erste Phase. |
| Review passt nicht mehr | Einen neuen Test für geändertes Material starten oder den aktuellen gespeicherten Entwurf wie angewiesen laden und prüfen. |
| Ergebnisse werden angezeigt, aber Medien bleiben blockiert | selection_audience_id bei Multi-Zielgruppen-Research prüfen und kontrollieren, ob die ausgewählten Datensätze den erwarteten nativen Medientyp enthalten. |
| Research läuft noch | Den unveränderten Workflow erneut einreihen, um das Polling für denselben gespeicherten Run fortzusetzen. |
| Unvollständige Evidenz oder unerwartete Verteilung | Die gespeicherte Study öffnen und analysieren. Der Adapter wählt bei inkompatiblen oder unvollständigen Ergebnissen bewusst keine Creatives aus. |
| Widget ist leer | Prüfen, ob die Frontend-Assets des Pakets geladen wurden, ComfyUI aktualisieren und Browserfehler analysieren. Das JSON-Ergebnis hilft, ein Anzeigeproblem von einem Research-Fehler zu unterscheiden. |
Authentifizierungsfehler sind unabhängig von Entwurfsfehlern. HTTP 401 weist auf den Server-Key hin. HTTP 402 oder 403 können auf Berechtigungen oder Account-Kontingente hindeuten. HTTP 409 kann auf eine geänderte Anfrage oder nicht einsatzbereite Minds verweisen. HTTP 413 signalisiert ein Problem mit der Dateigröße. Bei HTTP 429 wiederholen Sie dieselbe Anfrage später, anstatt wiederholt neue Studies zu erstellen.
Der offizielle Issue-Tracker ist die Anlaufstelle für Support rund um das Paket. Geben Sie die Versionen des Pakets und von ComfyUI, die fehlgeschlagene Phase sowie eine bereinigte Fehlermeldung an. Halten Sie Server-Keys, private Medien, signierte URLs und unredigierte Kontodaten aus öffentlichen Berichten heraus.
Was verifiziert wurde
Die Evidenz der veröffentlichten Integration umfasst reale Bild- und native Video-Workflows über Entwurfsfreigabe, Live-Ausführung über die Minds-API, Rendering der eingebetteten Response bis hin zum nativen Speichern. Die Video-Testdateien waren zwei Sekunden lang und enthielten Audio. Die Wiederholung derselben Anfrage setzte den bestehenden persistenten Durchlauf im getesteten Workflow fort.
Diese Überprüfungen wurden mit ComfyUI 0.41.0 und Frontend 1.55.17 mit einer QA-Zielgruppe aus fünf Minds durchgeführt. Sie belegen weder die Unterstützung langer Videos noch die Ausführung in Comfy Cloud, ein natives Partner-Node-Listing, Forschungskalibrierung oder Kampagnen-Uplift. Behalten Sie diese Unterscheidung bei, wenn Sie eigene Creative-Entscheidungen im Team präsentieren.
Für Studiendesign und Interpretation lesen Sie die Einführung, Minds, Zielgruppen und Studies. Die Integrationsübersicht, die ChatGPT-Einrichtung, die Claude-Einrichtung und die MCP-Übersicht erläutern weitere Host-Workflows. Der ComfyUI-Creative-Artikel zeigt, wie Sie eine präzise Präferenzfrage in eine produktive nächste Creative-Iteration überführen.
Häufig gestellte Fragen
Was bedeutet der Präferenz-Prozentsatz?
Er beschreibt die resultierende Verteilung über die exakten Alternativen für eine ausgewählte Zielgruppe. Es handelt sich um richtungsweisende synthetische Marktforschung, nicht um gemessene Kampagnen-Performance, eine repräsentative Populationsschätzung oder eine prognostizierte Conversion-Rate.
Gibt top_k immer exakt diese Anzahl an Creatives zurück?
Nein. Der Node berücksichtigt alle Gleichstände an der Schwelle, sodass eine Shortlist mehr Kandidaten als top_k enthalten kann. Er behält geteilte erste Plätze bei, anstatt willkürlich nach der Eingabereihenfolge auszuwählen.
Warum werden Ergebnisse angezeigt, ausgewählte Medien bleiben jedoch blockiert?
Wenn mehrere Zielgruppen enthalten sind, wählen Sie eine enthaltene selection_audience_id für das Medien-Routing. Stellen Sie zudem sicher, dass der ausgewählte Kandidat über die verbundene native Modalität verfügt; gehostete URLs und Textelemente erzeugen keine nativen IMAGE- oder VIDEO-Outputs.
Kann ich einen Wiederholungsversuch starten, ohne einen neuen Study-Durchlauf zu beginnen?
Reihen Sie denselben Workflow mit identischer Request-Identität und unveränderten Inputs erneut ein, um die persistent gespeicherte Anfrage fortzusetzen. Verwenden Sie New test und prüfen Sie den Entwurf erneut, wenn sich Material, Labels, Frage, Kontext, Zielgruppen oder die Study-Sprache ändern.
Wird der API-Key an das Response-Widget übermittelt?
Nein. Die Authentifizierung erfolgt ausschließlich über den ComfyUI-Python-Server. Das Ergebnis-iFrame empfängt die Response-Daten zur Anzeige; es benötigt den Minds-Key des Servers nicht. Behandeln Sie die Research-Inhalte selbst als Informationen, die Sie gezielt teilen.
Liefert der Node ein statistisches Konfidenzintervall?
Das strukturierte Ergebnis belässt confidence bei null und erzeugt weder ein künstliches Intervall noch Signifikanzaussagen. Interpretieren Sie die Verteilung unter Berücksichtigung von Zielgruppe, Stimulus, Fragestellung und den Evidenzgrenzen des Durchlaufs.







